Тестирование Qwen3.8-27B на RTX 3090: почти 262K контекста, до 94 токенов/с
Qwen3.8-27B запустилась на одной RTX 3090 с 24 ГБ видеопамяти. Модель приняла запрос на 257 966 токенов без обрезки, а на небольших запросах выдавала до 93,5 токена/с. Её подключили к чату, связанному с платформой мониторинга и управления транспортом: из этой системы в переписку поступил список машин, после чего пользователь запросил анализ заправок и возможных сливов топлива за месяц.
Проверка большого документа заняла почти десять минут. В другом вызове только чтение данных и написание ответа потребовали около одиннадцати минут. При этом в коротком объяснении контроля топлива модель допустила ошибку: предложила исключать слив при выключенном двигателе и нулевом расходе топлива через него.
Что нужно было получить от локальной модели
Задача — работать с данными через обычный чат. Пользователь задаёт вопрос, подключённая система возвращает нужные сведения, модель составляет ответ. Для примера с транспортом это список машин, а затем вопросы о событиях за выбранный период.
За вычисления отвечал сервер с RTX 3090. На нём работала llama.cpp — программа, которая загружает модель и рассчитывает продолжение текста. Чат связывается с ней через API, программный интерфейс для передачи запросов и ответов.
На сервере нужно было оставить две модели: Qwen3.8-27B и GigaChat 3.1 Lightning. Пользователь выбирает нужную в чате, сервер выгружает предыдущую из видеопамяти и загружает выбранную. Так можно переключаться между ними, не размещая обе на карте одновременно.
Для Qwen сохраняли окно 262 144 токена. Контекст — всё, что модель получает для текущего ответа: инструкции, историю диалога и данные из подключённых инструментов. Текст разбивается на токены — слова, части слов и знаки. Общего окна должно хватить и на вход, и на генерируемое продолжение. Поэтому отдельно проверяли почти заполненное окно, а не только короткую переписку.
Включили и MTP — режим, в котором предлагается несколько черновых токенов продолжения, а затем проверяется, какие из них принять. Его работу видно по двум счётчикам: сколько токенов предложено и сколько принято. Ускорение относительно работы без MTP в этой серии не измеряли: одинакового задания в двух режимах не было.
На каком оборудовании всё работало
У видеокарты собственные 24 ГБ памяти. Серверу также было доступно 24 ГБ оперативной памяти.
| Компонент | Конфигурация |
|---|---|
| Видеокарта | NVIDIA GeForce RTX 3090; 24 576 MiB по утилите nvidia-smi |
| Операционная система | Debian GNU/Linux 13, trixie; x86_64; glibc 2.41 |
| Драйвер NVIDIA | 550.163.01; во время установки не обновлялся |
| CUDA — средства для работы программы с видеокартой | Toolkit 12.4 |
| Оперативная память | Доступно 24 ГБ |
| Диск перед установкой | Раздел 108 ГБ; свободно 70 ГБ |
| Программа запуска | llama.cpp b12431, локальная сборка с CUDA |
MiB — мебибайты, двоичные мегабайты.
Для Qwen выбрали файл Qwen3.8-27B-UD-Q4_K_M.gguf. GGUF — формат хранения модели, а UD-Q4_K_M обозначает вариант сжатия её весов. Веса — числовые параметры, полученные при обучении; уменьшение точности их хранения позволяет сократить объём файла и требуемой памяти. Этот файл занимал 16 564 259 744 байта.
Дополнительная память нужна для обработки текста. Её промежуточные результаты хранятся в KV-кэше. У Qwen для него использовали точность q4_0, у GigaChat — q8_0. Полные настройки обеих моделей, включая размеры порций обработки и Flash Attention, сохранены в техническом приложении.
Кейс 1. Обновление программы запуска и первый ответ
Старая сборка llama.cpp не смогла прочитать модель: сообщила об отсутствии массива параметров blk.64.ssm_conv1d.weight. Сначала проверили целостность скачанного файла. Его SHA256 — контрольная сумма — совпала с указанной в репозитории. После обновления llama.cpp до b12431 модель загрузилась.
Обозначение архитектуры qwen35 в старой сборке не гарантировало, что она прочитает именно этот GGUF. В этом случае проблема решилась обновлением программы, а не повторным скачиванием весов. Старую сборку 7cadbfc сохранили отдельно.
Первый запрос выполнили без MTP:
Что больше: 15 или 20? Ответь только числом.
Ответ:
20
Сервер обработал вход из 29 токенов примерно за 147 миллисекунд, затем сгенерировал ответ примерно за 50 миллисекунд. Завершение было штатным, без обрыва по лимиту. В счётчике ответа записаны три токена; токены не равны числу видимых цифр или букв.
Это подтвердило загрузку модели и получение ответа через API. Для оценки скорости трёх токенов мало: значение около 40 токенов/с из этого вызова нельзя сравнивать с длинными ответами как устойчивый результат.
Затем включили MTP. Модель снова загрузилась и ответила; счётчики предложенных и принятых черновых токенов подтвердили работу режима. Окно во всех этих запусках оставалось 262 144 токена. Исходный JSON первого ответа и объяснение каждого его поля находятся в разделе А технического приложения.
Шесть замеров: сколько приходится ждать
У ответа есть два вычислительных этапа. Сначала модель обрабатывает вход: вопрос, историю и полученные данные. Затем генерирует продолжение. Большая скорость второго этапа не сокращает время, уже потраченное на первый.
Если часть входа обрабатывалась раньше и её состояние осталось в кэше, сервер может использовать эти результаты повторно. Поэтому в таблице разделены заново прочитанные токены и взятые из кэша. Это повторное использование обработки текста, а не готового ответа.
Во всех шести вызовах было настроено окно 262 144 токена, MTP включён. В первом столбце — фактическая длина входа.
| Входной контекст | Заново прочитано / из кэша | Время чтения входа | Скорость генерации | Длина ответа | Время генерации |
|---|---|---|---|---|---|
| 68 токенов | 68 / 0 | 0,18 с | 69,3 токена/с | 1 024 токена | 14,77 с |
| 8 768 токенов | 1 132 / 7 636 | 1,07 с | 72,7 токена/с | 368 токенов | 5,05 с |
| 14 610 токенов | 5 522 / 9 088 | 5,28 с | 93,5 токена/с | 1 240 токенов | 13,25 с |
| 205 842 токена | 189 649 / 16 193 | 6 мин 37 с | 34,5 токена/с | 9 085 токенов | 4 мин 24 с |
| 209 709 токенов | 649 / 209 060 | 2,25 с | 40,0 токена/с | 7 725 токенов | 3 мин 13 с |
| 257 966 токенов | 257 966 / 0 | 9 мин 48 с | 42,1 токена/с | 47 токенов | 1,09 с |
На небольших входах наблюдались 69-94 токена/с, на входах около 200-258 тысяч — 34-42 токена/с. Это разные запросы, поэтому по таблице нельзя измерить влияние одной только длины контекста.
Особенно заметна разница между двумя вызовами около 200 тысяч токенов. При входе 205 842 токена заново обрабатывались 189 649 — это заняло больше шести минут. При входе 209 709 токенов новыми были только 649 — чтение заняло 2,25 секунды. Но длинный ответ второго вызова всё равно генерировался больше трёх минут.
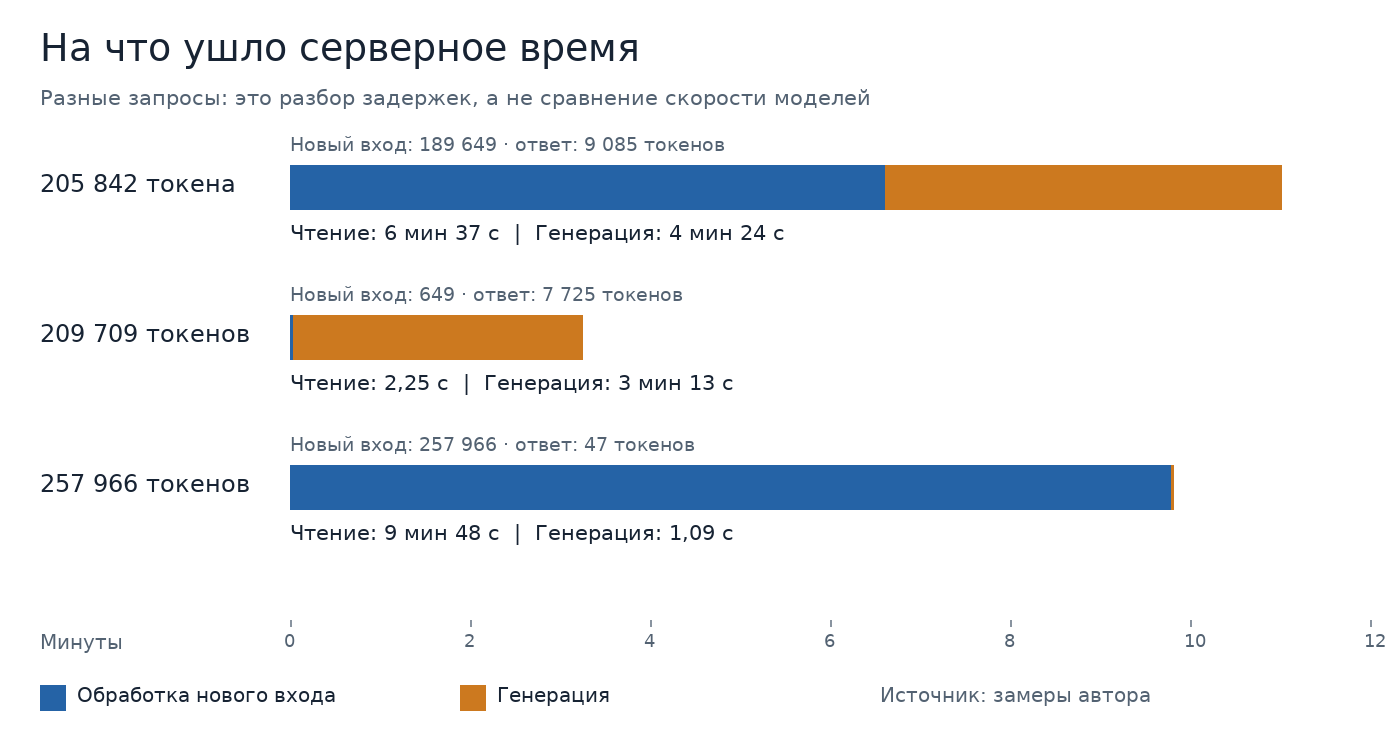
Для рабочего чата полезно записывать оба времени. Если задержку создаёт чтение большого нового входа, одна только высокая скорость выдачи текста её не объяснит и не устранит.
Кейс 2. Что модель ответила о контроле топлива
До анализа данных проверили, как Qwen объясняет саму задачу:
Объясни по-русски, как проверять аномальный расход топлива в автопарке: какие данные нужны, как отличить слив от заправки и ошибки датчика, почему нельзя делать вывод по одному скачку. Дай подробный связный ответ.
Ответ начинался с разумного принципа:
Чтобы эффективно выявлять аномалии (в частности, слив топлива), необходимо выстроить систему, основанную на корреляции данных, а не на единичных инцидентах.
Модель перечислила координаты, скорость, состояние двигателя, уровень в баке, заправки и сведения из CAN — канала обмена данными бортовых систем. Но в дальнейшем объяснении появились ошибки.
| Фрагмент ответа модели | Что нужно проверить или исправить |
|---|---|
| «Расход по CAN-шине… Это самый точный источник, так как он измеряет расход непосредственно в момент движения или работы двигателя». | CAN — способ получить параметр. Точность зависит от того, откуда взято значение, как его рассчитывает блок управления и как настроена система. Без проверки назначать его эталоном нельзя. |
| «Датчик уровня в баке — это потенциометр с поплавком». | Такое устройство бывает, но не у всех датчиков. В мониторинге используются и ёмкостные датчики. Для диагностики нужно знать, что установлено на конкретной машине и как настроено соответствие показаний объёму топлива — тарировка. |
| «Если расход по CAN в момент «скачка» был нормальным или нулевым (двигатель заглушен), а уровень упал — это, скорее всего, ошибка ДЛТ или механическое повреждение датчика, а не слив». | Слив возможен при выключенном двигателе и нулевом расходе топлива через него. Такое сочетание не позволяет исключить слив. Нужно проверить само падение уровня, условия измерения и другие признаки. |
| «Слив — это плавное или ступенчатое снижение уровня без соответствующего расхода». | Подходит как признак подозрительного события, но похожую картину могут дать утечка или сбой измерения. Для окончательного вывода нужны дополнительные данные. |
«ДЛТ» в цитате оставлено как в ответе. Обычно датчик уровня топлива сокращают как ДУТ.
В этом запросе отключили развёрнутое рассуждение модели и ограничили выход 1 024 токенами. Ответ дошёл до этого предела и оборвался на незавершённом заголовке ####. Причину видно в записи сервера: finish_reason=length — достигнут предел длины. Это объясняет обрыв; ошибку про слив ограничение длины не исправляет.
Генерация заняла 14,77 секунды при 69,3 токена/с. Полные параметры и счётчики сохранены в разделе Б приложения. Прикладной результат этого примера — конкретная ошибка, которую нужно включить в проверочный набор: модель не должна исключать слив только потому, что двигатель выключен.
Кейс 3. Почти заполненное окно контекста
Чтобы проверить большой вход, подготовили искусственный документ. Большую его часть составляла повторяющаяся строка:
Обычная служебная запись: автомобиль прошёл плановую проверку.
В начале, середине и конце разместили три случайных контрольных значения. Модель должна была вернуть их в нужном порядке. Размер документа подбирали через средства самого сервера: сначала применяли шаблон сообщения, затем считали токены. Получили 257 966 токенов уже оформленного входа.
Модель вернула все три значения правильно. Обработка документа заняла около 9 минут 48 секунд, короткий ответ — ещё примерно секунду. По клиентскому замеру весь запрос завершился за 589,3 секунды.
| Показатель | Результат |
|---|---|
| Вход / ранее обработанный вход | 257 966 / 0 токенов |
| Чтение входа | 587 874,227 мс; 438,81 токена/с |
| Генерация | 47 токенов за 1 091,535 мс |
| Скорость генерации | 42,14 токена/с |
| MTP: предложено / принято | 36 / 34 черновых токена |
| Полная длительность по клиенту | 589,3 с |
| Результат поиска | Все три контрольных значения найдены |
В журнале указано truncated=0: вход не обрезался. Так подтвердили работу почти заполненного окна. Ровно 262 144 токена на вход не отправляли — часть общего лимита нужна для оформления запроса и ответа.
Этот тест проверял поиск трёх записей в повторяющемся тексте. Для анализа разнообразной истории транспорта он не заменяет проверку событий и связей между ними. Исходные контрольные значения, промежуточные размеры документа и запись журнала находятся в разделе В приложения.
Кейс 4. Переключение между Qwen и GigaChat
В чате выбирали имя модели, а её загрузкой управлял сервер-маршрутизатор. Ему задали ограничение —-models-max 1 — держать загруженной одну модель.
Трижды отправили вопрос с ответом «20», переключая модель:
| Запрос к модели | Ответ | Время с загрузкой и ответом | Состояние после запроса |
|---|---|---|---|
| gigachat | 20 | 2,6 с | GigaChat loaded, Qwen unloaded |
| qwen3.8-27b | 20 | 2,7 с | GigaChat unloaded, Qwen loaded |
| gigachat | 20 | 2,3 с | GigaChat loaded, Qwen unloaded |
loaded означает «загружена», unloaded — «выгружена». Состояния менялись как требовалось: после каждого обращения на карте оставалась выбранная модель.
Переключения выполняли последовательно на тестовом маршрутизаторе. Время первой загрузки после перезапуска и одновременную работу нескольких пользователей не проверяли.
Кейс 5. Ошибка памяти, которую исправили без уменьшения контекста
После переноса запуска в постоянную службу Qwen перестала загружаться. Сервер выдал out of memory — не удалось выделить видеопамять. До этого модель с теми же параметрами работала.
Оказалось, что тестовый сервер на порту 8082 не остановили. Он уже занимал около 15 ГБ видеопамяти — 15 605 MiB по показаниям утилиты. Постоянная служба на порту 8081 пыталась разместить на той же карте ещё один экземпляр модели.
После остановки оставшегося процесса занятость снизилась до 4 MiB. Затем постоянный сервер загрузил Qwen и получил ответ «20». Уменьшать окно 262K или отключать MTP не понадобилось.
Ограничение на одну модель действовало внутри каждого сервера отдельно. Оно не запрещало второму процессу занять видеокарту. Поэтому при такой ошибке сначала стоит посмотреть список процессов, использующих GPU. Исходная запись сбоя сохранена в разделе Г приложения.
Кейс 6. Погода через подключённые инструменты
В чате задали вопрос:
можешь посмотреть погоду на сегодня?
На снимке выбрана 3090/qwen3.8-27b. Видны обращения к поиску в памяти, уточнению у пользователя, веб-поиску и загрузке страницы. Их имена в интерфейсе — search_memories, ask_user, search_web и fetch_url.
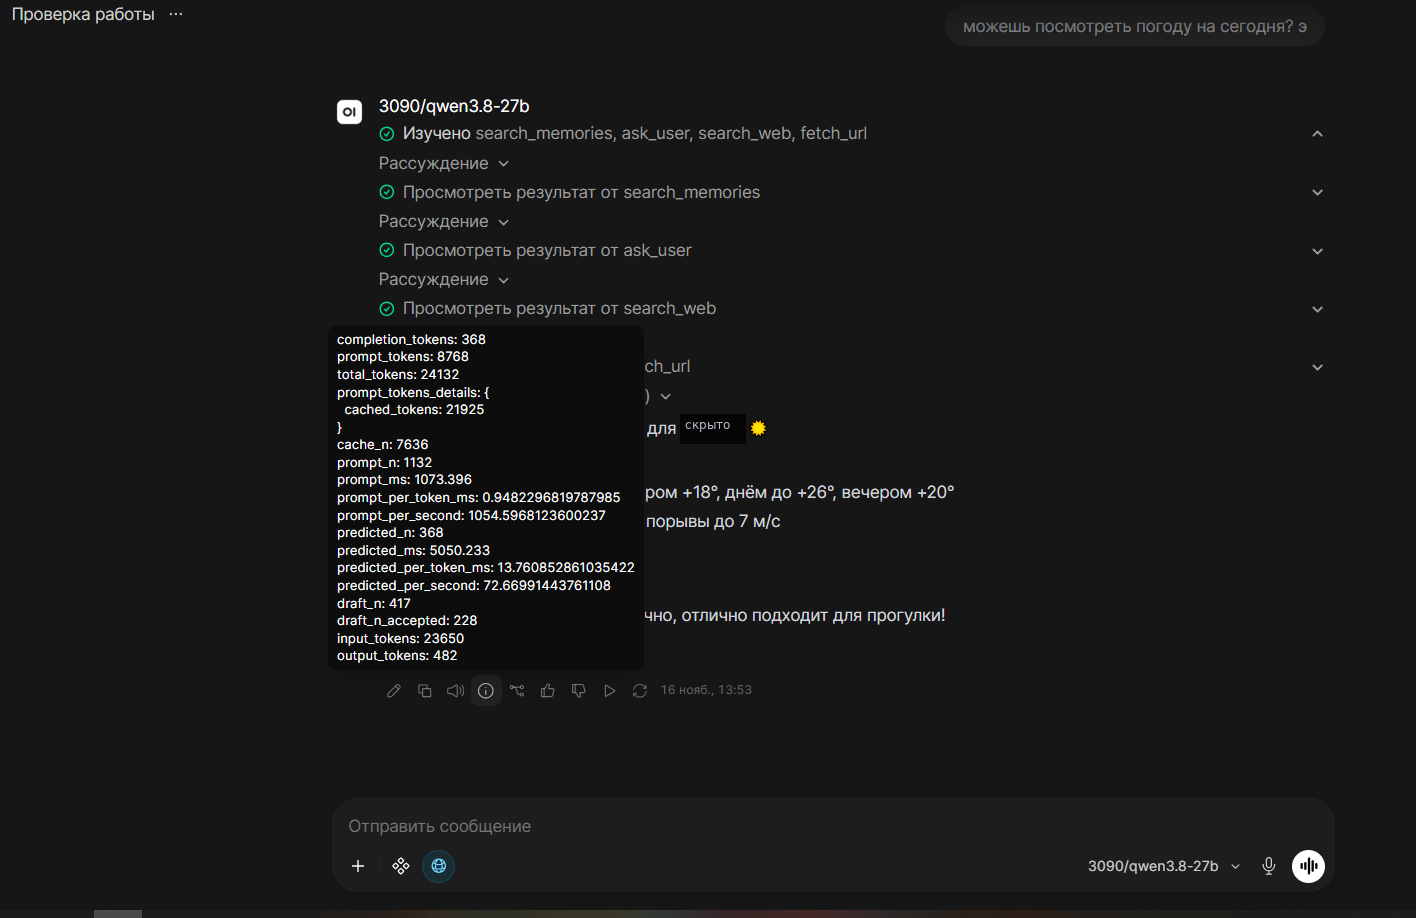
Модель написала: утром +18 °C, днём до +26 °C, вечером +20 °C, порывы ветра до 7 м/с. Под сообщением стоит «16 нояб., 13:53». Дата и такой прогноз вызвали сомнение. На снимке не раскрыты страница-источник, дата прогноза и полный ответ инструмента, поэтому причину установить не удалось.
Сам ответ длиной 368 токенов генерировался примерно пять секунд при 72,7 токена/с. Здесь видно, что чат обращался к инструментам; для проверки погоды нужно открыть полученный ими источник. Счётчики вызова и замеченные расхождения клиентских полей приведены в разделе Д приложения.
Кейс 7. Платформа мониторинга и управления транспортом
В этом примере чат подключён к специализированной платформе мониторинга и управления транспортом. В ней ведутся сведения о машинах и бортовых терминалах — устройствах, от которых система получает данные для мониторинга. Через подключённые функции чат запрашивает сведения платформы и передаёт их модели для ответа.
Схема обращения такая: вопрос пользователя → запрос к платформе → полученные данные → ответ в чате. Благодаря этой интеграции в переписке появился список транспорта; вручную переносить таблицу из платформы в сообщение не потребовалось.
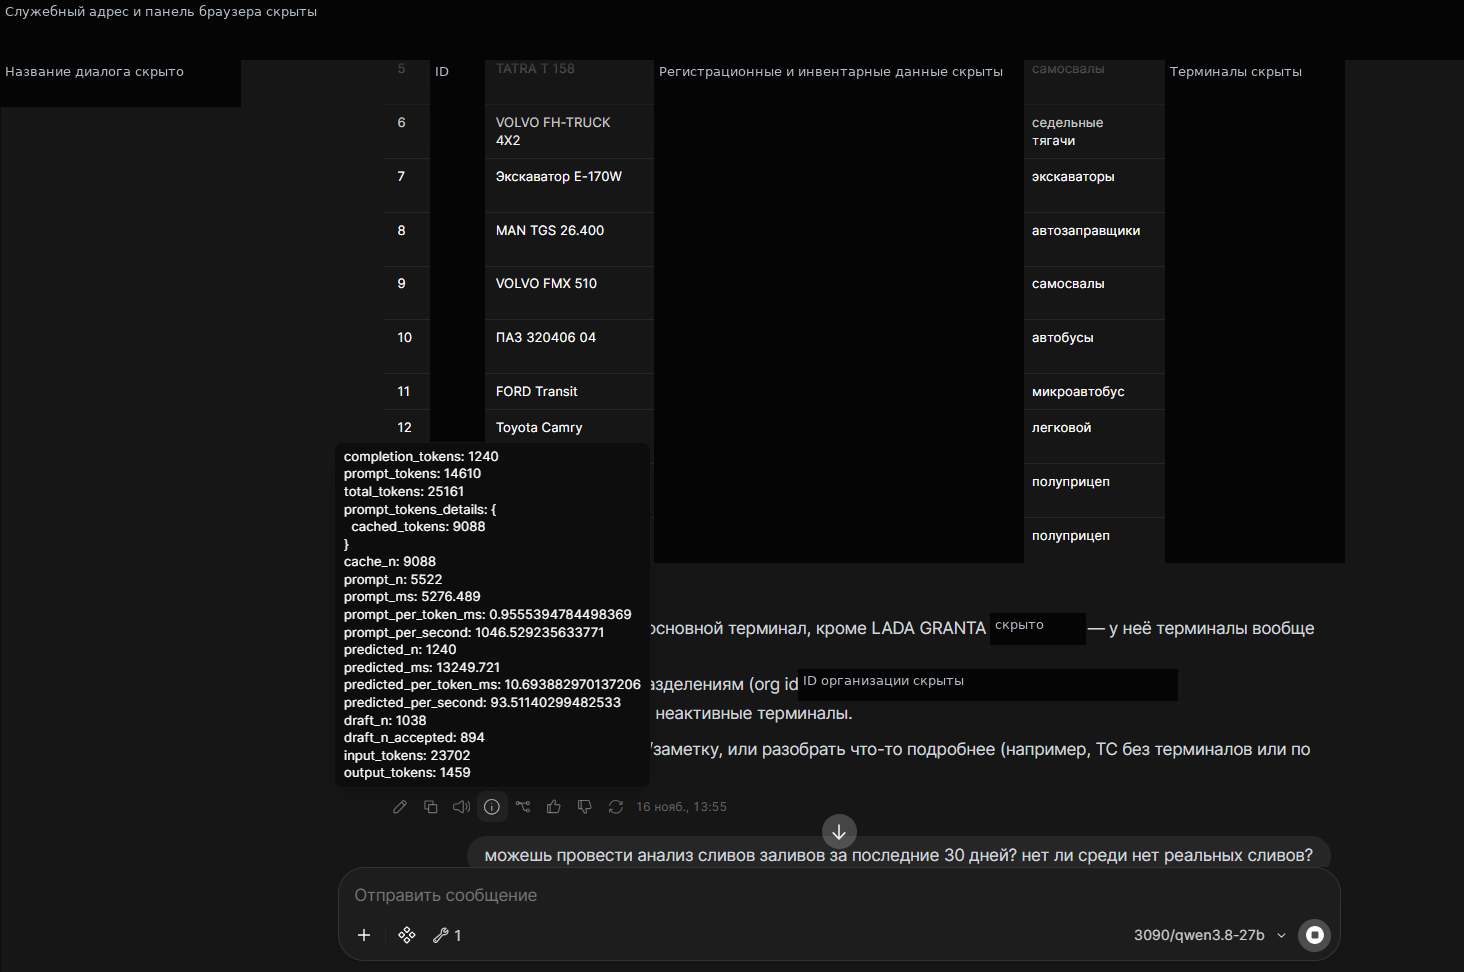
В таблице видны TATRA, VOLVO, MAN, ПАЗ, FORD Transit, Toyota Camry, экскаватор и полуприцепы. Есть категории транспорта, регистрационные и инвентарные данные, VIN — идентификационные номера транспортных средств, — а также сведения о терминалах. Отметка «неакт.» относится к терминалу; по ней нельзя судить, использовалась ли сама машина.
После получения списка задали вопрос:
можешь провести анализ сливов заливов за последние 30 дней? нет ли среди нет реальных сливов?
«Заливы» здесь — заправки, при которых уровень топлива вырос. Возможные сливы — подозрительные падения уровня. Пользователю нужен список событий за месяц: какая машина, когда и где находилась, на сколько изменился уровень и что требует проверки.
Такой запрос имеет смысл именно благодаря связи с платформой: вопрос относится к её рабочим данным. На снимке видны таблица и запрос дальнейшего анализа; готового анализа за месяц и итоговой таблицы спорных событий в материалах нет.
Ответ с таблицей генерировался за 13,25 секунды со скоростью 93,5 токена/с. Чтобы проверить полноту интеграции, нужно сопоставить обращения к платформе с её ответами: все ли нужные машины и периоды получены, не пропущены ли страницы выгрузки. Полного аудита этих обращений не проводили. Точные метрики сохранены в разделе Е приложения.
Кейс 8. Одиннадцать минут ожидания
После работы с данными ответ долго не появлялся. Разовый замер показал 99% загрузки GPU, 339 Вт, 71 °C и 22 937 MiB занятой видеопамяти. Видеокарта вычисляла, но её загрузка не объясняла, что именно происходит.
В журнале рос счётчик сгенерированных токенов одной задачи: от 1 087 в 11:04:04 до 7 161 в 11:07:00. Значит, в этом отрезке модель уже писала продолжение. Сам текст в журнале не сохранялся, поэтому по нему нельзя отличить окончательный ответ от рассуждений или повторов.
Позже в интерфейсе появились полные времена вызова:
• заново прочитано 189 649 токенов из входа 205 842 — 6 минут 37 секунд;
• сгенерировано 9 085 токенов — 4 минуты 24 секунды;
• скорость генерации — 34,5 токена/с.
Суммарно чтение и генерация заняли около одиннадцати минут. Работа инструментов, очередь, передача данных и отображение в чате могли добавить время сверху.
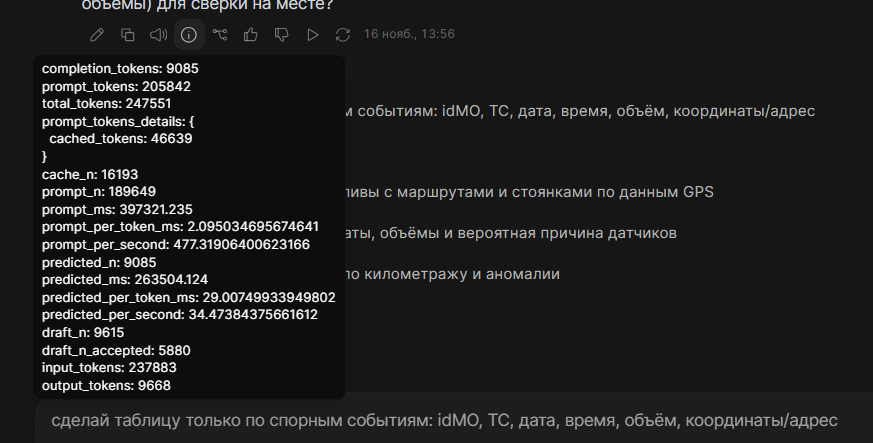
Следующий запрос в поле ввода:
сделай таблицу только по спорным событиям: idMO, ТС, дата, время, объём, координаты/адрес
Видимый фрагмент предыдущего ответа предлагает сверить события с маршрутами, стоянками и показаниями датчиков. GPS — спутниковое определение местоположения — даёт данные о маршруте. Готовой сверенной таблицы событий в материалах нет.
Почему из большого входа повторно использовались только 16 193 токена, не установлено. Для проверки нужно сопоставить полные последовательные запросы; в этих материалах их нет. Журнал с четырьмя отметками времени и показатели вызова сохранены в разделе Ж приложения.
Кейс 9. Что происходило с видеокартой
В предоставленной записи мониторинга было 153 измерения за интервал 11:
| Показатель | Результат |
|---|---|
| Загрузка GPU | Средняя 98,27%; минимум 80%, максимум 100% |
| Занятая видеопамять | 22 937 MiB во всех 153 замерах |
| Потребление GPU | Среднее 337,77 Вт; диапазон 333,59-339,70 Вт |
| Температура GPU | Средняя 71,73 °C; диапазон 70-73 °C |
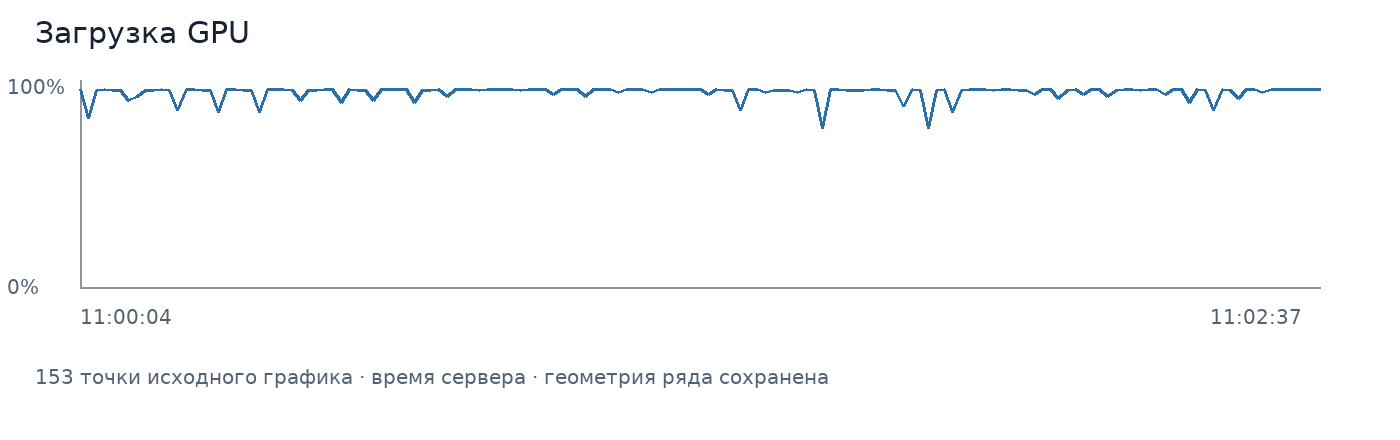
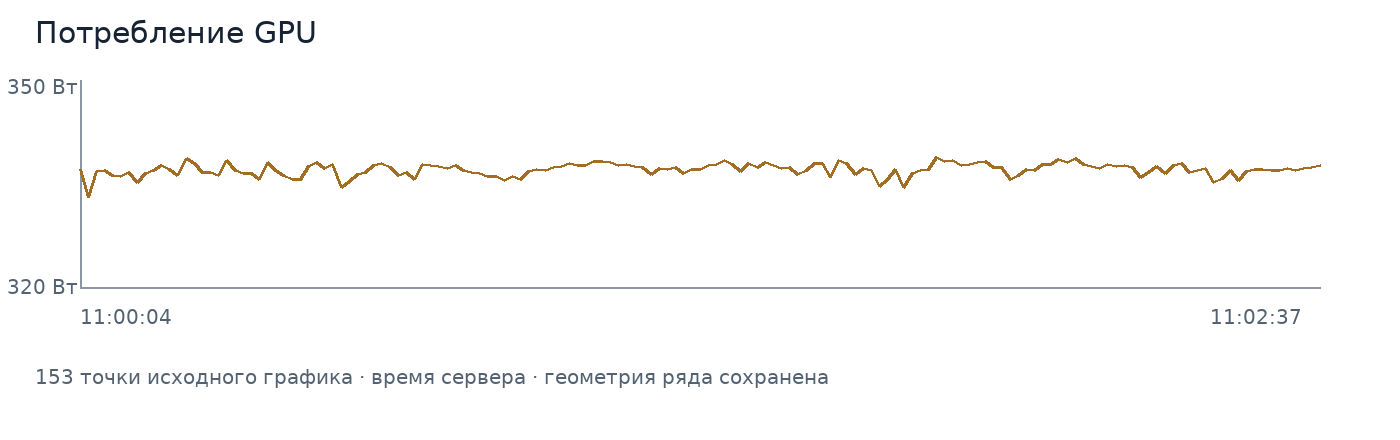
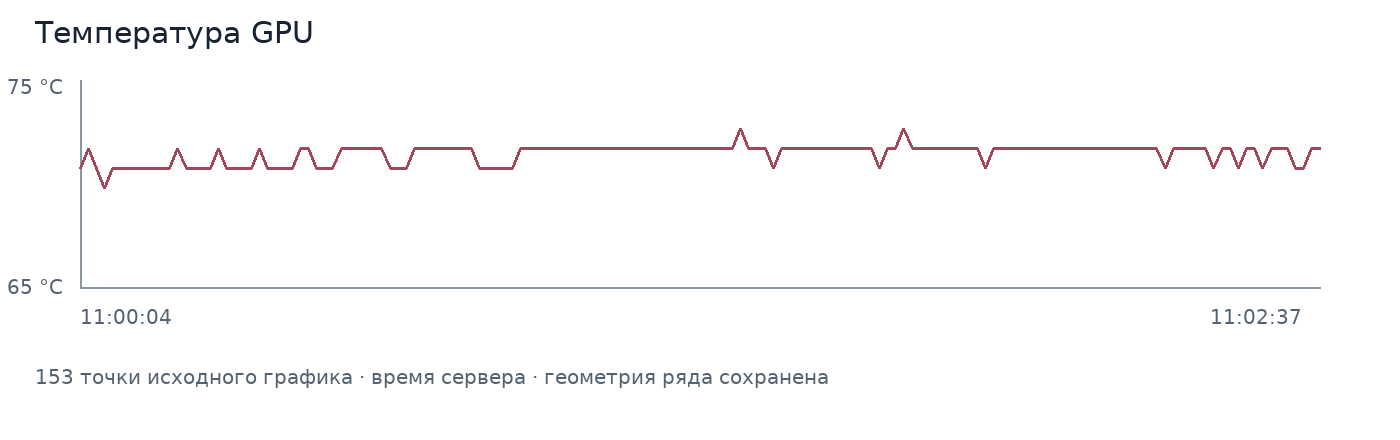
Температуру памяти и снижение рабочей частоты из-за нагрева отдельно не проверяли. Графики сохранены по всем 153 точкам; сведения об исходной таблице вынесены в раздел З приложения.
Как оставили сервер работать
Запуск оформили как фоновую службу Linux llama-gigachat. Ею управляет systemd — механизм запуска и остановки системных служб. Исходный файл службы сохранили, новую команду запуска задали отдельным дополнением 50-model-router.conf. Веб-сервер Nginx и авторизацию не меняли.
Служба была запущена и включена в автозапуск. После устранения конфликта за память через неё прошёл реальный ответ Qwen. Она принимает обращения внутри сервера на порту 8081; порт — номер точки подключения к программе.
Контейнер, отдельное программное окружение сервера, после настройки не перезагружали. Его автозапуск в Proxmox — системе управления такими окружениями и виртуальными машинами — не проверяли. Полный цикл переключения моделей прошёл на тестовом маршрутизаторе; через постоянную службу и чат целиком его ещё не повторили. Файлы настроек и расшифровка параметров находятся в разделе И приложения.
Что проверять перед использованием для анализа топлива
Для такой интеграции нужен набор событий с известным результатом. Тогда можно проверить не только получение данных, но и то, как модель их истолковала. Подходящая проверочная выборка выглядит так:
| Контрольный случай | Что должна сделать система | Что считать ошибкой |
|---|---|---|
| Подтверждённый слив из контрольной выборки | Найти событие, показать подтверждения, не потерять его при объединении данных | Исключить слив только из-за выключенного двигателя и нулевого расхода CAN |
| Заправка или возврат уровня после наклона | Сопоставить направление изменения, стоянку, восстановление уровня и соседние точки | Назвать любое изменение уровня хищением |
| Сбой датчика или связи | Показать разрыв или скачок и ограничение достоверности | Уверенно классифицировать событие, не отметив качество данных |
| Отсутствуют координаты или объём | Оставить значение неизвестным и назвать недостающий источник | Придумать адрес, время или литры |
| Анализ 30 дней по всем нужным машинам | Проверить границы периода, полноту страниц программного интерфейса и список охваченных объектов | Обобщить частичную выгрузку на весь парк |
Это порядок следующей проверки, не её готовый результат. Изменение уровня, подозрение на слив и подтверждённое хищение — разные выводы. В этих испытаниях не получена сверенная таблица событий, по которой можно устанавливать виновность водителя или сумму ущерба.
Один запрос к платформе стоит проследить целиком: что модель запросила, какие сведения пришли и как они использованы в ответе. Такая проверка обнаружит и неполную выгрузку, и вывод, который не следует из показаний.
Что получилось на практике
На RTX 3090 разместилась выбранная Qwen3.8-27B с MTP и почти полностью занятым окном 262K. В синтетическом документе она нашла все три контрольные записи без обрезки входа. Переключение с GigaChat позволяло держать на карте одну модель. Через интеграцию с платформой мониторинга и управления транспортом в чат поступила таблица машин.
Для работы с длинными данными определяющим оказалось время чтения нового входа. На одном большом вызове оно превысило шесть минут; в другом почти весь вход использовался повторно и чтение заняло 2,25 секунды. Поэтому при настройке такого помощника стоит измерять оба этапа и смотреть, не отправляются ли заново большие неизменные массивы.
Следующий вариант организации данных — программно рассчитать изменения уровня топлива, отобрать спорные участки и передавать модели сводку с возможностью запросить исходные точки. В этой серии такой вариант ещё не проверяли. Основание для него конкретное: большой новый вход уже создавал многоминутную задержку, а содержательную ошибку модель допустила даже на коротком задании.
Для повторения запуска ниже сохранены настройки, все показанные фрагменты журналов и их расшифровка. Для принятия аналитики нужен следующий шаг — проверка на известных событиях, начиная со слива при выключенном двигателе.
Техническое приложение
Здесь сохранены исходные записи сервера и настройки. В основных разделах приведён результат каждого вызова; приложение позволяет сопоставить его с конкретными полями. Персональные пути и адреса заменены, сами значения измерений не менялись.
А. Первый ответ: JSON и объяснение каждого поля
Сервер вернул ответ в формате JSON — текстовой записи данных с именованными полями. Ниже сначала приведён сам ответ, затем объяснены его поля.
{
  "finish_reason": "stop",
  "content": "20",
  "usage": {
    "completion_tokens": 3,
    "prompt_tokens": 29,
    "total_tokens": 32
  },
  "timings": {
    "cache_n": 0,
    "prompt_n": 29,
    "prompt_ms": 146.713,
    "predicted_n": 3,
    "predicted_ms": 50.047,
    "predicted_per_second": 39.96243531080784
  }
}
| Поле | Что означает в этом вызове |
|---|---|
| finish_reason: «stop» | Ответ завершён штатно, не по ограничению длины. |
| content: «20» | Текст ответа модели — число 20. |
| usage | Раздел со счётчиками токенов. |
| completion_tokens: 3 | Сервер насчитал три выходных токена. Токены — единицы разбивки текста моделью, не число букв или цифр в видимом ответе. |
| prompt_tokens: 29 | Весь переданный модели вход занял 29 токенов. |
| total_tokens: 32 | Общий счётчик этого ответа API: 29 входных и 3 выходных токена. |
| timings | Раздел со временем обработки и скоростью. |
| cache_n: 0 | Ранее обработанный вход в этом вызове не использовался. |
| prompt_n: 29 | Заново обработаны все 29 входных токенов. |
| prompt_ms: 146.713 | Обработка входа заняла 146,713 миллисекунды, примерно 0,147 секунды. |
| predicted_n: 3 | В разделе времён также указаны три сгенерированных токена. |
| predicted_ms: 50.047 | Генерация заняла 50,047 миллисекунды, примерно 0,05 секунды. |
| predicted_per_second: 39.96243531080784 | Скорость генерации, которую рассчитал сервер: около 40 токенов/с. Для оценки устойчивой скорости ответ слишком короткий. |
Эти времена относятся к вычислениям сервера. Они не включают передачу запроса, очередь и отображение ответа в чате.
Ошибка старой сборки
missing tensor blk.64.ssm_conv1d.weight
missing tensor означает, что программа не нашла ожидаемый массив чисел в модели. В этой проверке файл прошёл контроль целостности, а обновлённая сборка его загрузила. Тензоры дополнительного слоя, о неиспользовании которых программа предупредила при запуске без MTP, загрузке и генерации не помешали.
Б. Объяснение контроля топлива
Параметры запроса: temperature=0.7, max_tokens=1024, enable_thinking=false.
• temperature — степень случайности при выборе продолжения.
• max_tokens — верхний предел длины генерируемого ответа.
• enable_thinking=false — отключено развёрнутое внутреннее рассуждение.
Запись сервера:
prompt_n: 68
prompt_ms: 183.989
prompt_per_second: 369.59
predicted_n: 1024
predicted_ms: 14765.646
predicted_per_second: 69.28244114751227
draft_n: 1296
draft_n_accepted: 590
Вход из 68 токенов обработан за 183,989 мс; скорость чтения — 369,59 токена/с. Выход составил 1 024 токена, генерация заняла 14 765,646 мс. Сервер сообщил finish_reason=length: достигнут заданный предел.
Как читать поля следующих вызовов
| Поле | Значение |
|---|---|
| prompt_tokens | Счётчик длины входа в ответе API. |
| completion_tokens | Счётчик длины выхода в ответе API. |
| cache_n | Сколько входных токенов использовано повторно из сохранённого состояния обработки. |
| prompt_n | Сколько входных токенов обработано заново. |
| prompt_ms | Время обработки нового входа в миллисекундах. |
| prompt_per_second | Скорость обработки нового входа в токенах в секунду. |
| predicted_n | Число сгенерированных токенов в разделе серверных времён. |
| predicted_ms | Время генерации в миллисекундах. |
| predicted_per_second | Скорость генерации по расчёту сервера. |
| draft_n | Число черновых токенов, предложенных механизмом MTP. |
| draft_n_accepted | Число принятых черновых токенов. |
Например, в этом вызове MTP предложил 1 296 токенов, принято 590. Это подтверждает работу режима, но не измеряет его выигрыш относительно одинакового задания без MTP. Сгенерированные токены могут включать рассуждения, если такой режим используется; число выхода не обязательно равно длине окончательного текста, видимого пользователю.
В. Большой синтетический документ
Для подготовки запроса использовались /apply-template — применение шаблона диалога — и /tokenize — подсчёт токенов. Размеры при подборе: 3 734, 248 858 и 257 966 токенов. Полный вывод проверки:
Подготовлено входных токенов: 3734
Подготовлено входных токенов: 248858
Подготовлено входных токенов: 257966
Отправляю большой запрос. Он может занять много минут.
Ответ: 35980e04a2de9031
e5523ca07608bf31
69ab561a2b5c6b33
Все три значения найдены: True
Usage: {'completion_tokens': 47, 'prompt_tokens': 257966,
        'total_tokens': 258013, 'prompt_tokens_details': {'cached_tokens': 0}}
Время, секунд: 589.3
Случайные шестнадцатеричные строки — контрольные значения искусственного документа, не реквизиты доступа. Результат сохранили в qwen-262k-test-result.json.
Запись окончания обработки:
slot release: id 0 | task 436 | stop processing:
n_tokens = 258012, truncated = 0
slot — место обработки запроса, task — номер задачи, n_tokens — счётчик токенов в этой записи журнала. truncated=0 показывает отсутствие обрезки входа. В журнале n_tokens=258012, в API total_tokens=258013: единичное расхождение сохранено, эти два показателя не объявляются идентичными.
В этом вызове чтение заняло 587 874,227 мс при 438,81 токена/с, генерация — 1 091,535 мс при 42,14 токена/с. MTP предложил 36 токенов, принято 34. На таком коротком выходе наблюдений мало.
Г. Сбой при запуске постоянной службы
allocating 15104.40 MiB on device 0: cudaMalloc failed: out of memory
llama_model_load: error loading model: unable to allocate CUDA0 buffer
model name=qwen3.8-27b failed to load
Программа пыталась выделить 15 104,40 MiB на видеокарте и не смогла: карта уже была занята тестовым сервером. cudaMalloc — операция выделения памяти средствами CUDA, а CUDA0 buffer — область памяти на первой видеокарте. После остановки точного тестового процесса постоянный сервер загрузил модель.
Д. Вызов с ответом о погоде
prompt_tokens: 8768
completion_tokens: 368
cache_n: 7636
prompt_n: 1132
prompt_ms: 1073.396
prompt_per_second: 1054.5968123600237
predicted_n: 368
predicted_ms: 5050.233
predicted_per_second: 72.66991443761108
draft_n: 417
draft_n_accepted: 228
Здесь 8 768 входных токенов состоят из 7 636 повторно использованных и 1 132 новых. Чтение новых заняло 1 073,396 мс. Ответ из 368 токенов генерировался 5 050,233 мс. MTP: 417 предложено, 228 принято.
Е. Вызов с таблицей транспорта
prompt_tokens: 14610
cache_n: 9088
prompt_n: 5522
prompt_ms: 5276.489
prompt_per_second: 1046.5292356373371
predicted_n: 1240
predicted_ms: 13249.721
predicted_per_second: 93.51140299481579
draft_n: 1038
draft_n_accepted: 894
Вход: 14 610 токенов, в том числе 9 088 из кэша и 5 522 новых. Чтение заняло 5 276,489 мс, генерация 1 240 токенов — 13 249,721 мс. MTP: 1 038 предложено, 894 принято.
Ж. Длительный вызов и журнал генерации
11:04:04 | task 1737 | n_gen = 1087 | tg = 32.50 t/s
11:05:02 | task 1737 | n_gen = 3022 | tg = 33.13 t/s
11:06:00 | task 1737 | n_gen = 4997 | tg = 33.51 t/s
11:07:00 | task 1737 | n_gen = 7161 | tg = 34.17 t/s
task 1737 — одна и та же задача во всех строках; n_gen — растущий счётчик сгенерированных токенов; tg — показанная в журнале скорость генерации, t/s — токены в секунду. Запись фиксирует генерацию, но не сохраняет её текст.
Полные показатели вызова:
prompt_tokens: 205842
completion_tokens: 9085
cache_n: 16193
prompt_n: 189649
prompt_ms: 397321.235
prompt_per_second: 477.31906400623166
predicted_n: 9085
predicted_ms: 263504.124
predicted_per_second: 34.47384375661612
draft_n: 9615
draft_n_accepted: 5880
У входа 205 842 токена, из них 16 193 повторно использованы и 189 649 обработаны заново. Чтение заняло 397 321,235 мс при 477,32 токена/с, генерация — 263 504,124 мс. MTP: 9 615 предложено, 5 880 принято.
Несогласованные счётчики в клиенте
Рядом с серверными показателями интерфейс показывал ещё один набор полей:
| Пример | Серверные поля последнего вызова | Другие поля клиента |
|---|---|---|
| Погода | prompt_tokens=8768, completion_tokens=368, cache_n=7636 | input_tokens=23650, output_tokens=482, total_tokens=24132, cached_tokens=21925 |
| Таблица транспорта | prompt_tokens=14610, completion_tokens=1240, cache_n=9088 | input_tokens=23702, output_tokens=1459, total_tokens=25161, cached_tokens=9088 |
| Длинный вызов | prompt_tokens=205842, completion_tokens=9085, cache_n=16193 | input_tokens=237883, output_tokens=9668, total_tokens=247551, cached_tokens=46639 |
В примере погоды cached_tokens=21925 больше длины входа последнего вызова. В примере таблицы total_tokens=25161 соответствует 23 702 + 1 459, а не 14 610 + 1 240. В длинном вызове расходятся и наборы счётчиков входа/выхода, и показатели кэша.
Что именно клиент учитывает в каждом наборе, без его исходных данных не установлено. В основной таблице поэтому используются составляющие входа prompt_n + cache_n и времена prompt_ms, predicted_ms, а не смесь полей из двух наборов. Отметки времени клиента и серверного журнала также различались; единая временная шкала не восстанавливалась.
З. Источник графиков GPU
В системных показателях память указана в MiB — мебибайтах. Установленные на карте 24 576 MiB соответствуют 24 GiB, двоичным гигабайтам. В тексте для этой карты используется привычное обозначение «24 ГБ».
Объём занятой видеопамяти не менялся. Температуру памяти GDDR6X и причины ограничения частот не записывали: по этой записи нельзя установить отсутствие троттлинга, то есть снижения рабочей частоты из-за нагрева.
В предоставленном gpu-monitor.xlsx одна колонка содержала строки CSV — текст с разделителями. В исходном разборе из неё извлекли заголовок и 153 наблюдения. На листе 154 строки, но одна из них — названия полей.
Средние, минимумы и максимумы взяты из исходного расчёта. Каждый график сохранён по всем 153 точкам, а его векторная копия включена в комплект. Первичная Excel-книга при редакционной подготовке заново не пересчитывалась.
Разовое измерение перед просмотром журнала показывало 99%, 339 Вт, 71 °C и 22 937 MiB. Отдельная запись мониторинга дала среднюю загрузку 98,27%, потребление 337,77 Вт и температуру 71,73 °C; это разные способы наблюдения, не замена одного значения другим.
И. Настройки обеих моделей и постоянной службы
Три последовательных переключения на тестовом маршрутизаторе заняли 2,3-2,7 секунды каждое вместе с ответом. Файлы весов могли сохраняться в оперативной памяти средствами операционной системы, поэтому эти времена не описывают первую загрузку после перезапуска. Одновременные обращения нескольких пользователей не проверяли.
| Параметр | Qwen3.8-27B | GigaChat 3.1 Lightning |
|---|---|---|
| Имя в программном интерфейсе | qwen3.8-27b | gigachat |
| Веса | Unsloth GGUF UD-Q4_K_M | GigaChat3.1-10B-A1.8B, GGUF Q8_0 |
| Настроенное окно | 262 144 токена | 262 144 токена |
| KV-кэш K / V | q4_0 / q4_0 | q8_0 / q8_0 |
| Flash Attention — режим вычисления внимания | Включён | Включён |
| Параллельные слоты обработки | 1 | 1 |
| MTP | draft-mtp, до трёх черновых токенов | В этих испытаниях не включали |
| batch-size / ubatch-size — размеры порций обработки | 512 / 128 | Вручную в наборе настроек не заданы |
| Проверка большого входа | 257 966 токенов | В текущей серии не проводилась; ранее подтверждался вход 121 282 токена |
Контекст GigaChat в текущей серии на большом входе не испытывали; ранее был подтверждён запрос на 121 282 токена. Для Qwen размеры порций batch-size / ubatch-size задали как 512 / 128. У GigaChat вручную их не задавали. Для обеих моделей включены Flash Attention и один параллельный слот.
Файл models.ini
Пользовательские пути заменены условным /srv/llm. Перед использованием файла нужно указать фактические места хранения весов на своём сервере.
version = 1

[*]
ctx-size = 262144
parallel = 1
n-gpu-layers = 999
flash-attn = on
jinja = true

[gigachat]
model = /srv/llm/models/gigachat/GigaChat3.1-10B-A1.8B-q8_0.gguf
cache-type-k = q8_0
cache-type-v = q8_0

[qwen3.8-27b]
model = /srv/llm/models/qwen3.8-27b/Qwen3.8-27B-UD-Q4_K_M.gguf
cache-type-k = q4_0
cache-type-v = q4_0
batch-size = 512
ubatch-size = 128
spec-type = draft-mtp
spec-draft-n-max = 3
| Настройка | Для чего она здесь |
|---|---|
| ctx-size = 262144 | Размер окна контекста. |
| parallel = 1 | Один параллельный слот обработки. |
| n-gpu-layers = 999 | Настройка переноса слоёв на видеокарту с высоким пределом числа слоёв. |
| flash-attn = on | Включён режим Flash Attention для вычисления внимания — связей между частями текста. |
| jinja = true | Включена обработка шаблона диалога Jinja: оформление сообщений для модели. |
| model = ... | Путь к файлу весов соответствующей модели. |
| cache-type-k / cache-type-v | Точность хранения двух составляющих KV-кэша. |
| batch-size = 512 | Размер порции обработки входа. |
| ubatch-size = 128 | Размер вычислительной подпорции. |
| spec-type = draft-mtp | Выбран механизм чернового продолжения MTP. |
| spec-draft-n-max = 3 | Верхний предел числа черновых токенов — три. |
Qwen проверяли с Q4-кэшем для размещения большого контекста и MTP. У GigaChat сохранили Q8-кэш прежней конфигурации. Влияние точности кэша на качество топливной аналитики отдельно не проверяли.
Дополнение службы systemd
[Service]
WorkingDirectory=/opt/llama-b12431
ExecStart=
ExecStart=/opt/llama-b12431/build/bin/llama-server --models-preset /srv/llm/models.ini --models-max 1 --host localhost --port 8081
WorkingDirectory задаёт рабочий каталог. Пустая строка ExecStart= сбрасывает старую команду запуска, следующая задаёт новую. --models-preset указывает файл наборов настроек, —-models-max 1 ограничивает число загруженных моделей. localhost означает обращение внутри того же сервера, 8081 — выбранный порт подключения.
Каталог /opt/llama-b12431 и адрес localhost заменяют исходный пользовательский путь и числовой адрес локального интерфейса. Публичная копия с этими заменами отдельно не запускалась. Подтверждены работа исходной службы, её включение в автозапуск (active/running/enabled) и ответ Qwen через постоянный интерфейс. Перезапуск контейнера и полный цикл переключения через постоянный чат остаются непроверенными.
Сборка и файл весов
llama.cpp: b12431
commit: a946eb541a6d3051496bdcc451a0fa85772b8dfd
предыдущая сборка: 7cadbfc

GGUF: Qwen3.8-27B-UD-Q4_K_M.gguf
размер: 16564259744 байта
SHA256: 1bce504dfecd84153666928a41d8a66706f0158d3a317bc5196b72819d7dc529
CUDA-сборка b12431 выполнена GNU 13.3 с целевой архитектурой 86. Драйвер не обновляли, старую сборку сохранили. Контрольная сумма файла весов совпала с указанной в репозитории.
К. Что ещё не измерено
В шести вызовах различались содержимое заданий, рассуждения, длина ответа и работа MTP. По строкам с входом около 8K и 14K нельзя заключить, что 14K само по себе быстрее. Для измерения влияния размера контекста нужен отдельный контролируемый тест.
Почему в длинном вызове из большого входа повторно использовались только 16 193 токена, не установлено. Для этого нужно сравнить последовательные запросы: историю сообщений, результаты инструментов и оформление диалога. Полный состав входа и разделение выхода на рассуждения и видимый ответ не зафиксированы.
Сравнения с другими движками или моделями при одинаковых заданиях не проводили. Нет и равного длинного теста с MTP и без него. По этим наблюдениям нельзя приписать MTP определённый процент ускорения.
Отдельно можно сравнить режимы рассуждения. reasoning_effort задаёт требуемую глубину рассуждения; её снижение или отключение рассуждений может изменить и время, и полноту ответа. В проверенных синтетических запросах thinking отключали; фактические настройки большого вызова из интерфейса не установлены.
Проверка структурированных обращений к платформе, известных топливных событий, восстановления службы после согласованной перезагрузки и уменьшения лишнего входа — следующие эксперименты, не уже полученные результаты.
Итог: локальная модель на RTX 3090 пригодна для практических задач
На мой взгляд, результат для одной RTX 3090 получился хорошим: Qwen3.8-27B работала с большим контекстом, правильно нашла контрольные записи в длинном документе и составила таблицу по данным подключённой платформы. На коротких запросах скорости хватало для работы в чате. Такая видеокарта позволяет запускать локальные модели и получать полезный результат.
Главное — подобрать конкретное применение. Поиск сведений в документах, подготовка сводок и работа с данными через подключённые инструменты дают понятную основу для собственного помощника. Начать стоит с одной задачи с известным правильным ответом, проверить результат и измерить полное время выполнения. В этом тесте ошибки в объяснении контроля топлива показали, что выводы модели требуют проверки; при правильно выбранной задаче локальная модель на RTX 3090 вполне может быть полезным рабочим инструментом.
Другие мои статьи по теме
Почти 90 токенов/с на мини-ПК: тест Qwen3.8 Flash Next на Ryzen AI Max+ 395 — запуск другой локальной модели на мини-ПК, сравнение программ запуска и реальные замеры скорости.
Почему токенов в секунду недостаточно: как оценивать скорость локальной нейросети — что измерять помимо генерации текста и как учитывать время выполнения всей задачи.
Q4, Q6 или Q8: что меняется при сжатии локальной нейросети — как связаны размер модели, расход памяти и проверка качества на собственных заданиях.
Источник: Встроенный генератор iXBT Live; иллюстрация, не фото тестового экземпляра
1 комментарий
Добавить комментарий