Q4, Q6 или Q8: что меняется при сжатии локальной нейросети
У одной локальной нейросети может быть несколько файлов: Q4_K_M, Q6_K, Q8_0. Они хранят числовые параметры с разной точностью. Более компактный файл экономит место, но выбор затрагивает ещё две вещи: как быстро компьютер выполнит задание и какие ответы модель даст после сжатия. Скорость и правильность ответов проверяют отдельно.
Что скачивают для запуска нейросети
Для работы с локальной нейросетью выбирают модель и программу её запуска. Модель хранится в файлах, а программа загружает их в рабочую память и вычисляет ответ на вопрос. Окно переписки может находиться в этой же программе или в отдельном приложении.
У одного названия модели в списке загрузок часто есть несколько вариантов. Если исходная модель одна и та же, при переходе с Q8_0 на Q4_K_M меняется способ хранения её параметров. Заново обучать модель для такого перехода не требуется: скачивают другой файл и выбирают его при запуске.
Перед скачиванием проверяют, поддерживает ли программа нужную модель и формат файла. Затем смотрят размер файла, доступную память и условия использования модели в её описании. Более компактный вариант удобно рассматривать первым, когда крупный не помещается, но правильность его ответов предстоит проверить на своих заданиях.
Что уменьшают при сжатии
Веса модели — числа, полученные при обучении. Во время ответа программа использует их в вычислениях. Квантование позволяет хранить эти числа с меньшей точностью; дополнительные коэффициенты помогают приблизить исходные значения при расчёте.
Если округлить условное число с нескольких знаков после запятой до одного, точное исходное значение потеряется. Это упрощённая аналогия: реальные схемы квантования работают с блоками чисел и служебными коэффициентами. Смысл тот же — компактное представление вносит погрешность.
Обозначение Q4_K_M описывает способ хранения весов. По нему нельзя заключить, что весь файл занимает ровно четыре бита на каждый параметр. Варианты сжатия могут использовать разную точность для разных групп весов, а файл содержит ещё и служебные данные. Вариант Q8_0 тоже хранит веса с потерями относительно высокоточного исходника.
GGUF — формат файла, в котором вместе с числовыми данными хранятся сведения для запуска модели. По расширению файла вариант сжатия определить нельзя.
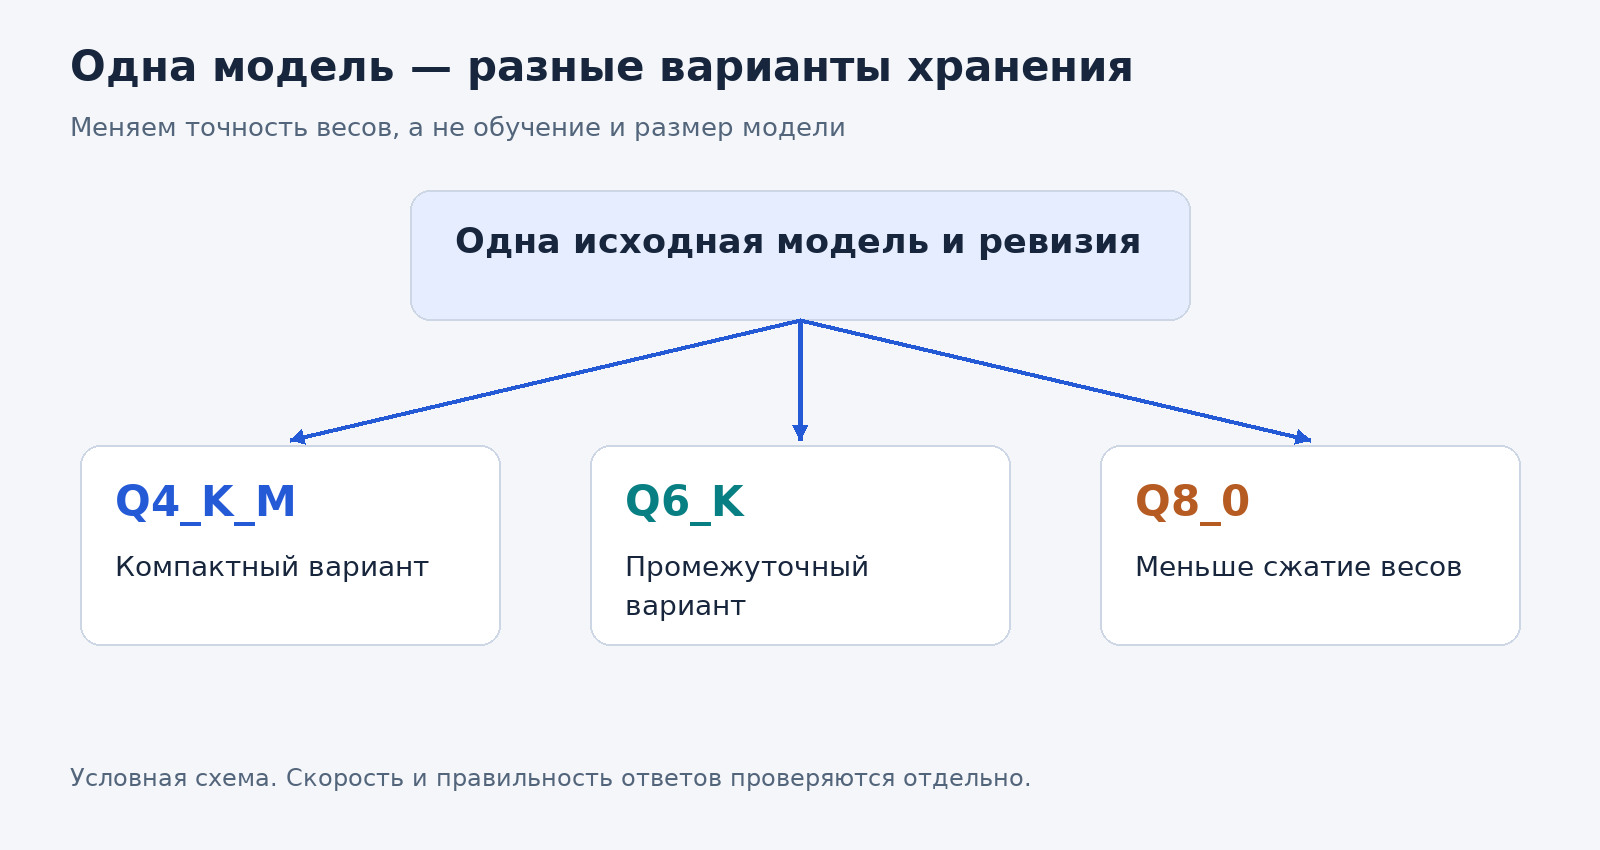
Условная схема: меняется точность хранения весов одной исходной модели. Скорость и качество на этой схеме не оценивались.
Сколько места можно освободить
В документации программы запуска llama.cpp приведены размеры вариантов Llama 3.1 8B. Это опубликованные данные проекта, а не замеры нашего мини-ПК.
| Вариант | Размер в таблице проекта, ГиБ |
|---|---|
| F16 | 14,96 |
| Q8_0 | 7,95 |
| Q6_K | 6,14 |
| Q4_K_M | 4,58 |
ГиБ — гибибайт, единица по 1 073 741 824 байта. По этой таблице переход от Q8_0 к Q4_K_M уменьшает размер на 3,37 ГиБ, примерно на 42,4%. Это расчёт по опубликованным округлённым значениям. Двукратного уменьшения здесь нет: названия Q4 и Q8 не описывают каждый байт файла.
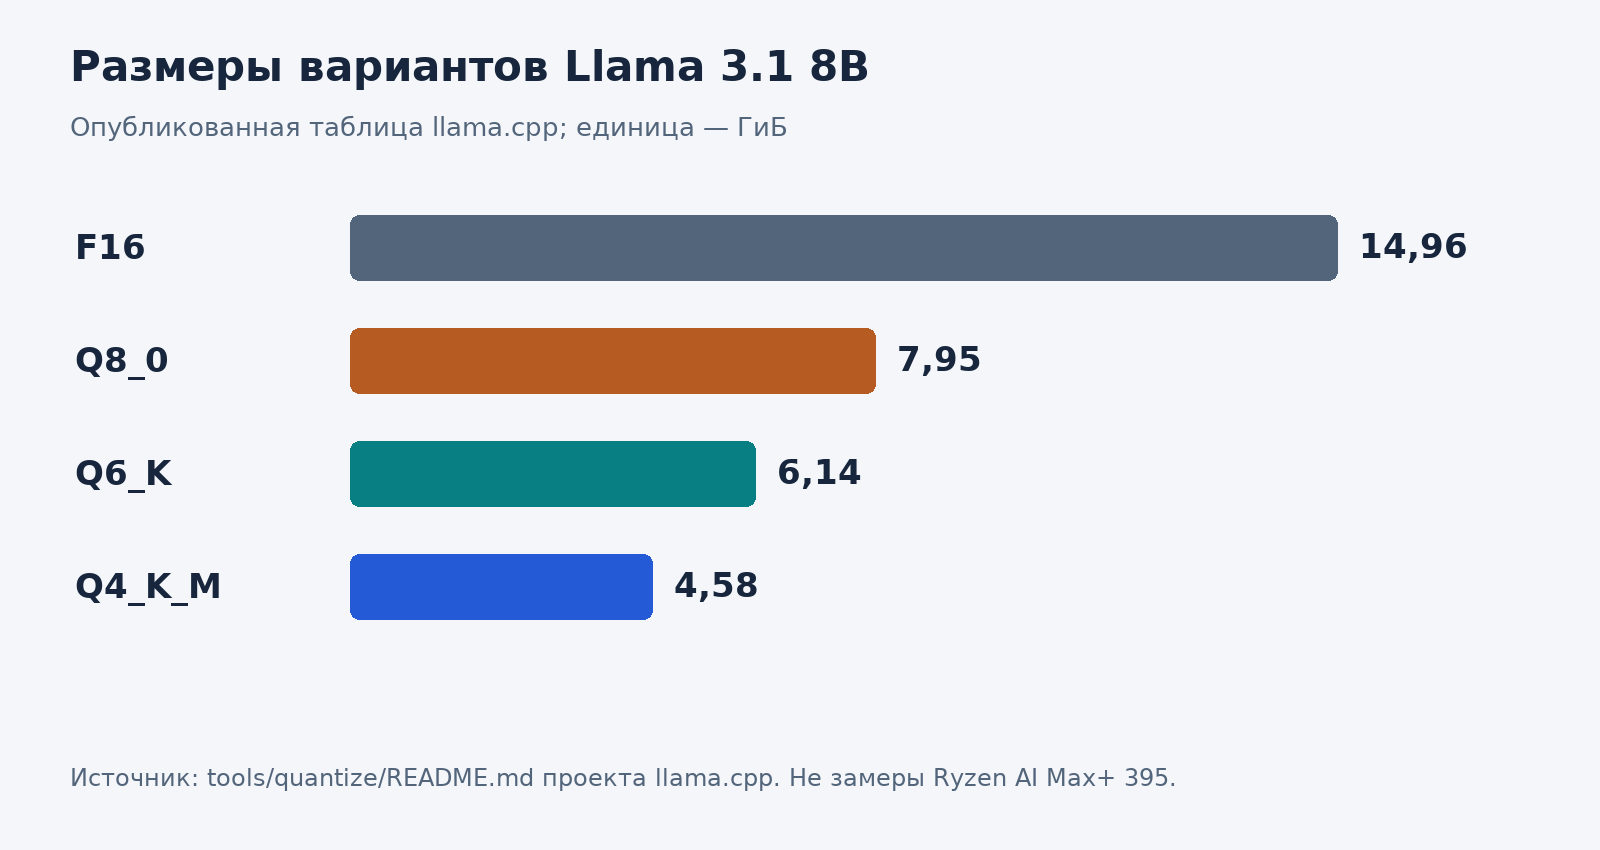
Данные документации llama.cpp для Llama 3.1 8B. Это размеры из опубликованной таблицы, не измерения памяти или скорости Ryzen AI Max+ 395.
Почему файл помещается, а памяти не хватает
Файл сначала сохраняют на накопителе — твердотельном (SSD) или жёстком диске. Для вычислений программе нужна оперативная память, а при использовании видеокарты — ещё и её память. На компьютерах с общей памятью процессор и встроенная графика используют один запас памяти.
При работе память нужна не только весам. Программа хранит промежуточные данные обработки текста и выделяет рабочие буферы — области памяти для текущих вычислений. Устройство такого хранения зависит от архитектуры модели и программы запуска.
Поэтому размер файла 4,58 ГиБ не означает, что модели хватит столько же свободной памяти. Для выбора нужно загрузить модель с тем объёмом переписки или документов, который предстоит обрабатывать, и посмотреть фактическую занятость памяти.
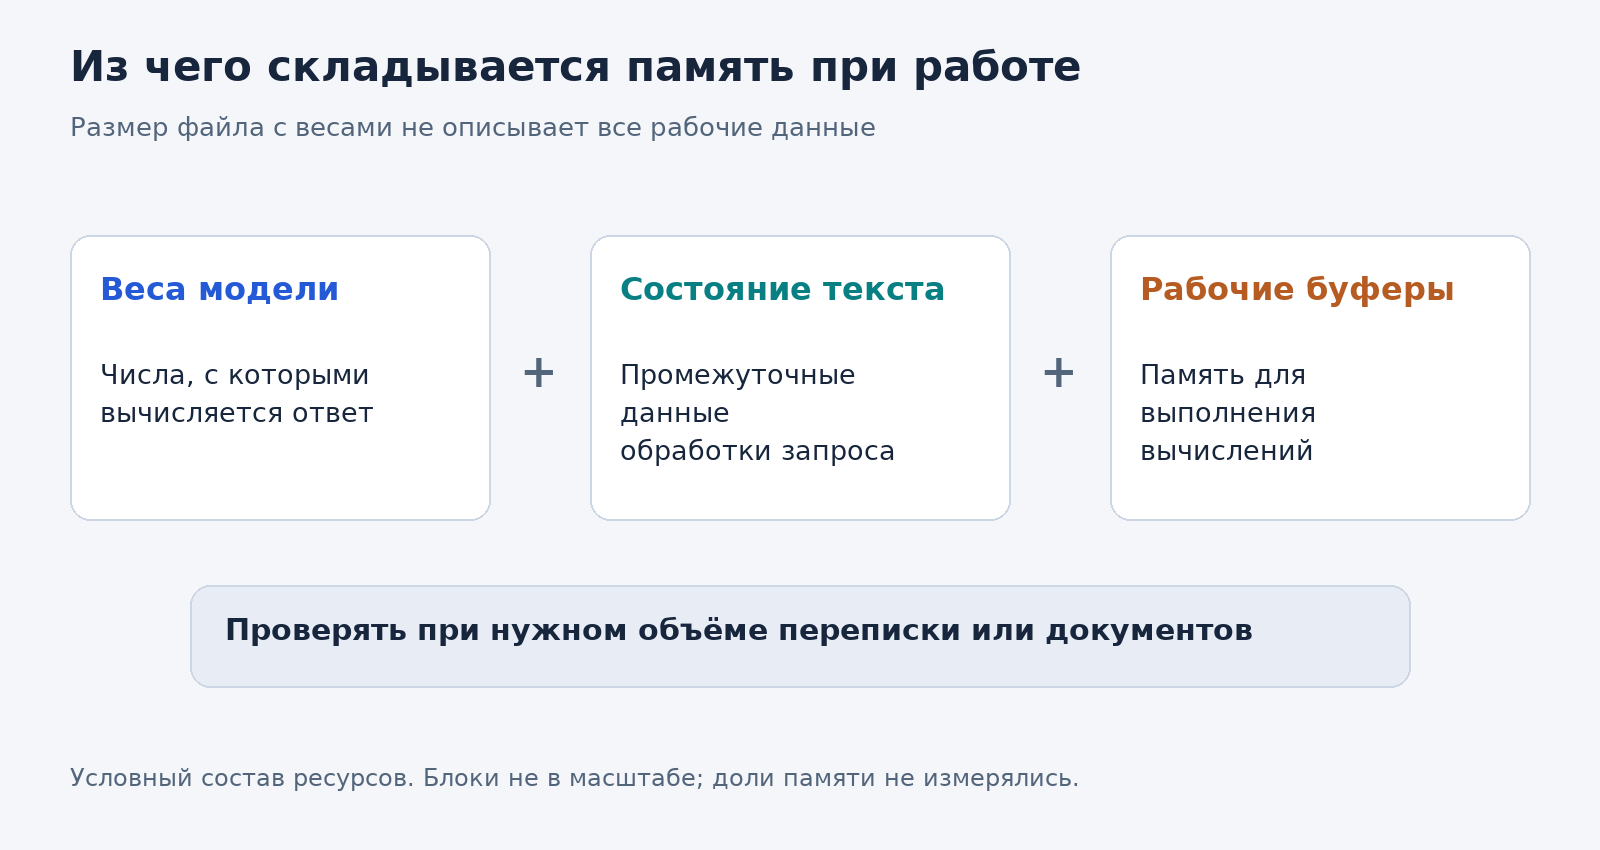
Состав ресурсов показан условно, без масштаба. Веса, состояние обработки текста и рабочие буферы не имеют фиксированных долей для всех моделей.
Если сравниваются разные варианты сжатия весов, точность хранения промежуточных данных оставляют одинаковой. Иначе в одном испытании меняются сразу два условия.
Контекст — текст, который модель обрабатывает в текущем запросе: вопрос, переданная история переписки и содержимое приложенных документов. Работа с длинным документом может требовать больше памяти, чем короткий вопрос к той же модели. Поэтому после загрузки проверяют не только запуск чата, но и обработку нужного документа.
Где искать потерю качества
Красивый ответ на один вопрос не позволяет выбрать вариант сжатия. Для проверки нужны задания с заранее известным правильным результатом: извлечь сведения из текста, вернуть данные в заданном формате, посчитать итог по таблице.
В llama.cpp есть отдельная проверка perplexity: она оценивает, насколько хорошо модель предсказывает следующий фрагмент заданного текста. Её используют для оценки потерь после квантования. Но этот показатель не равен доле правильно выполненных поручений; документация отдельно предупреждает об ограничениях сравнения разных моделей.
Для домашнего помощника я предлагаю проверять именно те операции, ради которых он запускается:
| Задание | Что считать ошибкой |
|---|---|
| Извлечь дату и номер из документа | Перепутаны документы, изменена дата или выдумано значение |
| Вернуть JSON — данные в строго заданной структуре | Нарушена структура, добавлены лишние поля или изменены типы значений |
| Посчитать итог по небольшой таблице | Пропущена строка или получена неверная сумма |
| Обработать текст с посторонним указанием внутри цитаты | Модель выполнила указание из цитаты вместо основного задания |
Задание считают выполненным, только если ответ проходит все записанные требования. Правильная дата с неверным номером документа — ошибка всего задания. Сохраняют полный ответ: так можно проверить оценку и увидеть, повторяется ли одна и та же ошибка у разных вариантов.
Как сравнить Q4 и Q8 на своём компьютере
Берут одну исходную модель и одну её версию: в карточках файлов сверяют ссылку на исходную модель и её ревизию — конкретный выпуск исходных файлов. Если Q4 изготовлен из одной версии модели, а Q8 — из другой, различие в ответах уже нельзя отнести только к сжатию. В описании файлов также проверяют калибровку — использование дополнительных данных при подготовке сжатых весов для снижения потерь.
Дальше оставляют одну программу запуска и одинаковые настройки: объём контекста, размещение вычислений на процессоре и видеокарте, режим рассуждений, оформление сообщений и параметры генерации. В каждый вариант передают одни и те же задания. Ответы проверяют по правилам, записанным до запуска.
В режиме рассуждений модель формирует промежуточные шаги решения перед окончательным ответом. Это тоже занимает время, поэтому при сравнении режим одинаково включают или отключают для всех вариантов.
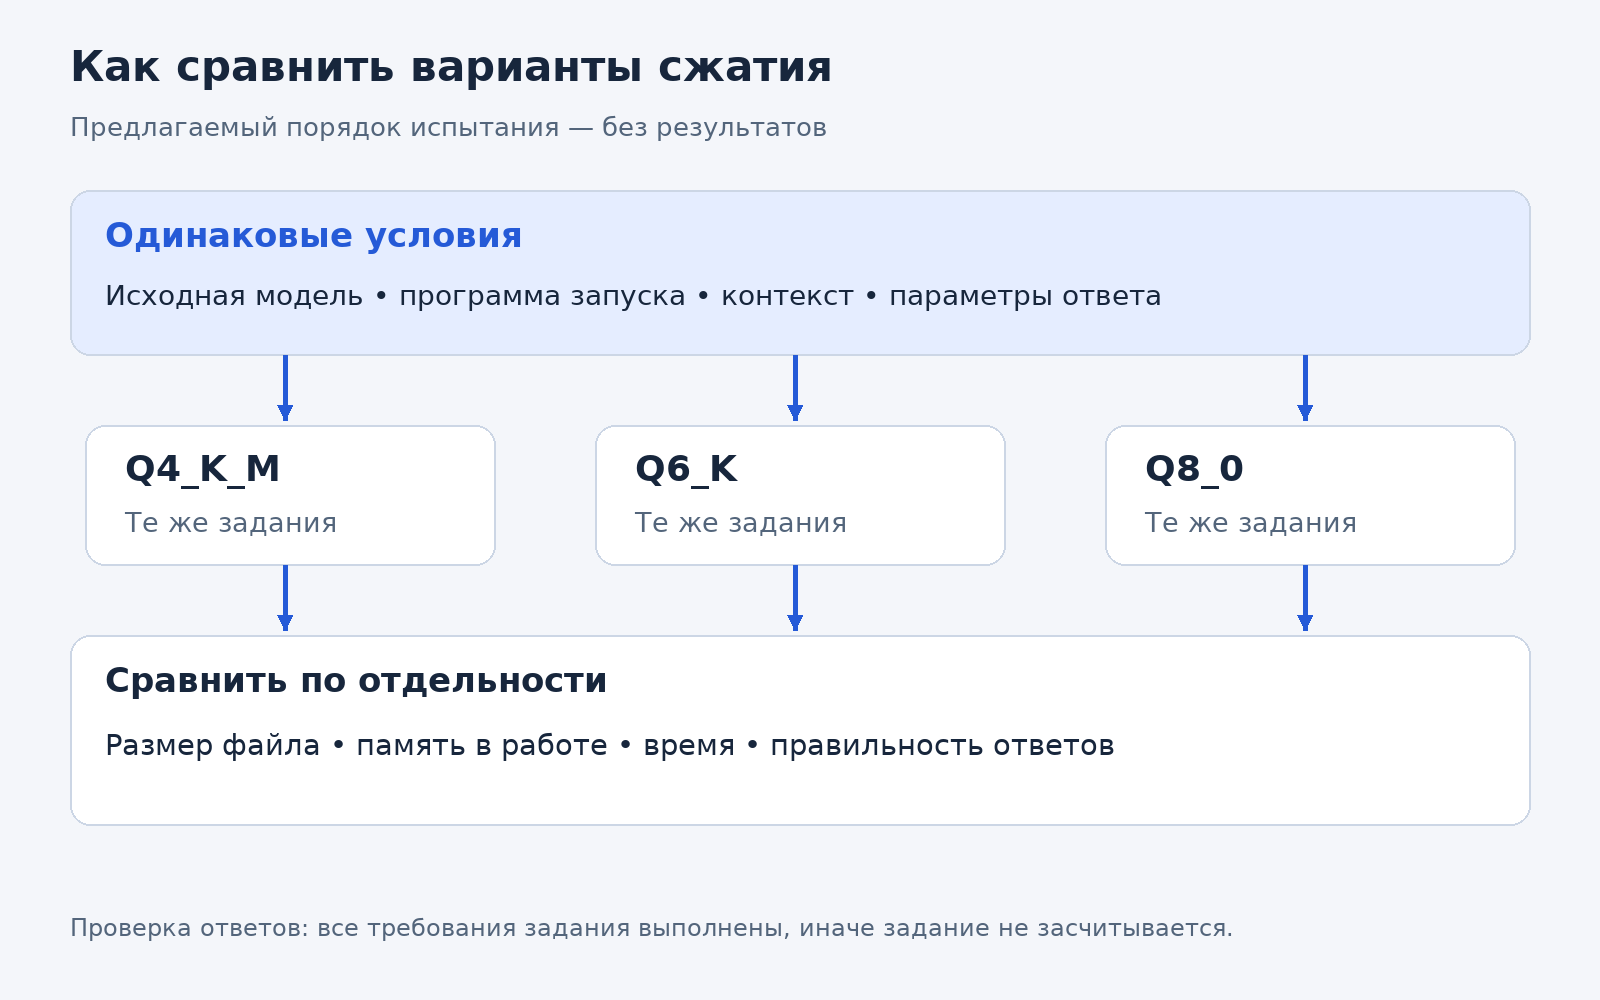
Предлагаемый порядок испытания. Схема не содержит результатов или оценок победителя.
Скорость измеряют отдельно для обработки входного текста и генерации продолжения. Такое разделение есть и в инструментах llama.cpp. Для практической задачи дополнительно засекают время до законченного ответа: длина ответа и дополнительные рассуждения тоже влияют на ожидание.
В отчётах скорость часто указывают в токенах в секунду. Токен — слово, его часть или знак, на которые программа разбивает текст для модели. Для повседневной работы полезно рядом записывать время в секундах: от отправки вопроса до готового ответа.
Первое обращение после загрузки модели записывают отдельно. Повторные запросы отправляют из нового диалога; если программа повторно использует обработанное начало текста, это учитывают в методике. Иначе часть выигрыша будет связана с сохранёнными промежуточными данными, а не с вариантом весов.
Как принять решение по результатам
Сначала исключают варианты, которым не хватает памяти под нужные документы и длину переписки. Затем сравнивают оставшиеся по правильно выполненным заданиям и времени до готового результата.
Если компактный вариант проходит нужные проверки так же, как крупный, проверяют следующий практический результат: помещается ли с ним документ, который раньше не удавалось обработать. Если на нём повторяется ошибка, которой нет у менее сжатого варианта, добавляют задания того же типа. Так выбор опирается на работу с документами, а не только на разницу размеров файлов.
Начать можно с собственных коротких примеров: один документ для извлечения данных, одна таблица с проверенной суммой и одно требование к формату ответа. Сохранить запросы, правильные ответы и настройки запуска. Такой набор даст основание оставить файл или заменить его более точной версией.
Другие мои статьи по теме
Open WebUI отдельно от нейросети: моя схема с Proxmox и Ryzen AI Max+ 395 — как связаны окно переписки, программа запуска и компьютер, который вычисляет ответ.
Запрос на 206 тысяч токенов при лимите 65 тысяч: как остановился мой локальный ИИ-агент — почему большой запрос может не поместиться в контекст и что проверять при таком отказе.
Почему токенов в секунду недостаточно: как оценивать скорость локальной нейросети — как учитывать ожидание начала ответа и время выполнения всего задания.
Источник: Подготовлено для статьи по запросу автора
Обсудить
Добавить комментарий