Автоматизация создания документов Word через Markdown и Python
Проблема шаблонов Word
Традиционный подход к созданию документов в Word предполагает использование шаблонов (.dotx/.dotm). Шаблон содержит предопределённые стили, форматы и настройки, которые применяются ко всем документам, созданным на его основе.
Технические ограничения подхода
Бинарный формат. Шаблоны Word — бинарные файлы. Системы контроля версий (Git, SVN) не могут отслеживать изменения на уровне отдельных свойств стилей. Diff показывает только факт изменения файла, но не содержание правок.
Глобальное состояние. Шаблон — это глобальный объект. Изменение стиля в шаблоне влияет на все документы, созданные на его основе. Откатить изменение для конкретного документа без затрагивания остальных невозможно.
Ручное управление. Для изменения стиля необходимо:
- Открыть шаблон в Word.
- Найти нужный стиль в диалоге управления стилями.
- Внести изменения через графический интерфейс.
- Сохранить шаблон.
- Пересоздать документы, если требуется применить изменения к существующим файлам.
Зависимость от среды. Результат зависит от версии Word, локали, настроек темы. Документ, созданный в Word 2016, может отличаться от документа, созданного в Word 2021, даже при использовании одного шаблона.
Ограниченная автоматизация. Макросы VBA позволяют автоматизировать некоторые операции, но:
- VBA имеет ограниченные возможности работы с OOXML.
- Макросы не версионируются (хранятся внутри .dotm).
- Отладка макросов сложнее, чем обычных скриптов.
Существующие решения
На рынке есть инструменты конвертации Markdown → DOCX:
Pandoc — универсальный конвертер документов. Поддерживает Markdown, LaTeX, HTML, DOCX и десятки других форматов. Команда:
▼pandoc input.md -o output.docx --reference-doc=template.docx
Pandoc использует --reference-doc для применения стилей из шаблона Word. Это решает часть проблем, но:
- Стили всё равно хранятся в бинарном шаблоне.
- Настройка стилей требует редактирования .docx вручную.
- Сложная логика (условия, циклы) реализуется через фильтры Lua, что добавляет сложность.
markdown2docx, mammoth, docxtemplater — другие варианты конвертеров. Каждый имеет свои ограничения: неполная поддержка OOXML, зависимость от шаблонов, отсутствие гибкости в управлении стилями.
Когда эти инструменты подходят:
- Простая конвертация без сложной настройки стилей.
- Один шаблон на все документы.
- Не требуется версионирование описания стилей.
Когда требуется другой подход:
- Каждый документ имеет уникальные стили.
- Нужна автоматизация с условиями и циклами.
- Требуется версионирование описания стилей в Git.
- Необходим полный контроль над OOXML.
Альтернативный подход: документ как код
Решение — хранить описание стилей и контент в текстовом формате, который можно версионировать, автоматизировать и воспроизводить независимо от среды выполнения.
Архитектура
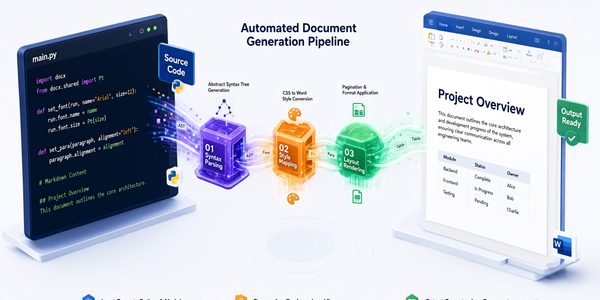
Формат контента: Markdown — текстовый формат с простой разметкой.
Управление стилями: Python-блоки внутри Markdown-файла. Скрипт извлекает эти блоки, выполняет их и настраивает стили Word через библиотеку python-docx.
Сборка документа: Скрипт md_to_docx.py обрабатывает .md файл и генерирует .docx.
Структура проекта
▼project/
├── md_to_docx.py          # основной скрипт сборки
├── py_block.py            # модуль выполнения Python-блоков
├── helpers.py             # опционально: переиспользуемые функции
├── document.md            # исходный документ
└── document.docx          # результат сборки
Зависимости
На компьютере должен быть установлен Python, например, версии 3.13. Следующая консольная команда устанавливает нужные пакеты:
▼pip install mistune python-docx pywin32
- mistune — парсер Markdown.
- python-docx — генерация DOCX, работа со стилями.
- pywin32 — опционально, для управления открытыми файлами Word.
Реализация
Модуль py_block.py
Извлекает Python-блоки из Markdown и выполняет их в контексте документа.
# -*- coding: utf-8 -*-
"""py_block.py — выполнение Python-блоков ```py ... ``` из Markdown."""

import re
import sys
import traceback
from dataclasses import dataclass
from typing import Callable

from docx import Document
from docx.enum.style import WD_STYLE_TYPE
from docx.enum.text import (WD_ALIGN_PARAGRAPH, WD_COLOR_INDEX,
                            WD_LINE_SPACING, WD_UNDERLINE)
from docx.oxml import parse_xml
from docx.oxml.ns import qn
from docx.oxml.shared import OxmlElement
from docx.shared import Cm, Emu, Inches, Mm, Pt, RGBColor


@dataclass
class PyBlock:
    code: str
    line: int


# Регэксп: ```py / ```python ... ``` (не жадный, многострочный)
_RE = re.compile(r"^```(?:py|python)s*n(.*?)^```s*$", re.M | re.S)


def norm(name: str) -> str:
    return " ".join(str(name).split()).casefold()

def extract(md_text: str) -> tuple[str, list[PyBlock]]:
    """Вырезает py-блоки, возвращает очищенный текст и список блоков."""
    blocks = []
    for m in _RE.finditer(md_text):
        line_no = md_text.count("n", 0, m.start()) + 1
        blocks.append(PyBlock(code=m.group(1), line=line_no))
    cleaned = _RE.sub("", md_text)
    return cleaned, blocks


def make_sandbox(doc: Document, generator) -> dict:
    # Импорт алиасов из md_to_docx
    import sys
    md_to_docx = sys.modules.get("__main__")
    ALIASES = getattr(md_to_docx, "ALIASES", {})

    def black():
        """Возвращает RGBColor для черного."""
        return RGBColor(0, 0, 0)

    def style(name):
        """Ищет стиль по любому имени (рус/англ/ID)."""
        # Прямой поиск
        try:
            return doc.styles[name]
        except KeyError:
            pass
        # Через алиасы
        from py_block import norm
        key = norm(name)
        if key in ALIASES:
            try:
                return doc.styles[ALIASES[key]]
            except KeyError:
                pass
        # Перебор всех стилей
        for s in doc.styles:
            if norm(s.name) == key or norm(s.style_id) == key:
                return s
        raise KeyError(f"Стиль '{name}' не найден")

    """Переменные, доступные внутри ```py блоков."""
    return {
        # Документ и генератор (чтобы можно было вызывать render_inline и т.п.)
        "doc": doc,
        "gen": generator,
        "style": style,

        # Типы стилей
        "PARAGRAPH": WD_STYLE_TYPE.PARAGRAPH,
        "CHARACTER": WD_STYLE_TYPE.CHARACTER,
        "TABLE":     WD_STYLE_TYPE.TABLE,
        "LIST":      WD_STYLE_TYPE.LIST,

        # OOXML
        "OxmlElement": OxmlElement,
        "parse_xml":   parse_xml,
        "qn":          qn,

        # Единицы и цвета
        "Pt": Pt, "Cm": Cm, "Mm": Mm, "Inches": Inches, "Emu": Emu,
        "RGBColor": RGBColor,

        # Константы
        "ALIGN": {
            "left": WD_ALIGN_PARAGRAPH.LEFT, "center": WD_ALIGN_PARAGRAPH.CENTER,
            "right": WD_ALIGN_PARAGRAPH.RIGHT, "justify": WD_ALIGN_PARAGRAPH.JUSTIFY,
        },
        "UNDERLINE": {k: getattr(WD_UNDERLINE, k) for k in
                      ("SINGLE", "DOUBLE", "DOTTED", "DASH", "WAVY", "WORDS")},
        "LINE_SPACING": {k: getattr(WD_LINE_SPACING, k) for k in
                         ("SINGLE", "ONE_POINT_FIVE", "DOUBLE", "AT_LEAST",
                          "EXACTLY", "MULTIPLE")},

        # Хелперы
        "add_style": lambda name, stype=WD_STYLE_TYPE.PARAGRAPH, base=None: _add_style(doc, name, stype, base),
        "set_font":  _set_font,
        "set_para":  _set_para,
        "set_border": _set_border,
        "set_shading": _set_shading,
        "set_outline_level": _set_outline_level,

        # Стандартные библиотеки
        "re": re, "os": __import__("os"), "sys": sys,
        "Path": __import__("pathlib").Path,
    }


def _add_style(doc, name, stype, base=None):
    s = doc.styles.add_style(name, stype)
    if base:
        s.base_style = doc.styles[base] if isinstance(base, str) else base
    return s


def _set_font(style, *, name=None, size=None, bold=None, italic=None,
              color=None, underline=None):
    f = style.font
    if name is not None:
        rpr = style.element.get_or_add_rPr()
        fonts = rpr.find(qn("w:rFonts"))
        if fonts is None:
            fonts = OxmlElement("w:rFonts")
            rpr.append(fonts)
        for a in ("ascii", "hAnsi", "eastAsia", "cs"):
            fonts.set(qn("w:" + a), name)
        for a in ("asciiTheme", "hAnsiTheme", "eastAsiaTheme", "cstheme"):
            fonts.attrib.pop(qn("w:" + a), None)
    if size is not None:      f.size = size
    if bold is not None:      f.bold = bold
    if italic is not None:    f.italic = italic

    # Обработка цвета
    if color is not None:
        if color == "auto":
            # Сбросить цвет — наследуется от стиля
            rpr = style.element.find(qn("w:rPr"))
            if rpr is not None:
                for el in rpr.findall(qn("w:color")):
                    rpr.remove(el)
        else:
            f.color.rgb = color

    if underline is not None: f.underline = underline


def _set_para(style, *, align=None, left_indent=None, right_indent=None,
              first_line_indent=None, space_before=None, space_after=None,
              line_spacing=None, line_spacing_rule=None,
              keep_with_next=None, keep_together=None, page_break_before=None,
              widow_control=None, outline_level=None):
    pf = style.paragraph_format
    if align is not None:              pf.alignment = align
    if left_indent is not None:        pf.left_indent = left_indent
    if right_indent is not None:       pf.right_indent = right_indent
    if first_line_indent is not None:  pf.first_line_indent = first_line_indent
    if space_before is not None:       pf.space_before = space_before
    if space_after is not None:        pf.space_after = space_after
    if line_spacing is not None:       pf.line_spacing = line_spacing
    if line_spacing_rule is not None:  pf.line_spacing_rule = line_spacing_rule
    if keep_with_next is not None:     pf.keep_with_next = keep_with_next
    if keep_together is not None:      pf.keep_together = keep_together
    if page_break_before is not None:  pf.page_break_before = page_break_before
    if widow_control is not None:      pf.widow_control = widow_control
    if outline_level is not None:
        ppr = style.element.get_or_add_pPr()
        ol = ppr.find(qn("w:outlineLvl"))
        if ol is None:
            ol = OxmlElement("w:outlineLvl")
            ppr.append(ol)
        ol.set(qn("w:val"), str(int(outline_level)))


def _set_border(style, side="all", *, style_name="single", size_pt=0.5,
                color="000000", space_pt=1):
    """side: 'all' | 'top' | 'bottom' | 'left' | 'right' | 'between'."""
    sz = int(round(size_pt * 8))
    sp = int(round(space_pt))
    attrs = {"val": style_name, "sz": sz, "color": color, "space": sp}
    ppr = style.element.get_or_add_pPr()
    bdr = ppr.find(qn("w:pBdr"))
    if bdr is None:
        bdr = OxmlElement("w:pBdr")
        ppr.append(bdr)
    sides = ("top", "left", "bottom", "right") if side == "all" else (side,)
    for s in sides:
        el = bdr.find(qn("w:" + s))
        if el is None:
            el = OxmlElement("w:" + s)
            bdr.append(el)
        for k, v in attrs.items():
            el.set(qn("w:" + k), str(v))


def _set_shading(style, fill, color="auto", val="clear"):
    ppr = style.element.get_or_add_pPr()
    shd = ppr.find(qn("w:shd"))
    if shd is None:
        shd = OxmlElement("w:shd")
        ppr.append(shd)
    shd.set(qn("w:fill"), fill.lstrip("#"))
    shd.set(qn("w:color"), color)
    shd.set(qn("w:val"), val)


def _set_outline_level(style, level):
    ppr = style.element.get_or_add_pPr()
    ol = ppr.find(qn("w:outlineLvl"))
    if ol is None:
        ol = OxmlElement("w:outlineLvl")
        ppr.append(ol)
    ol.set(qn("w:val"), str(int(level)))


def run_blocks(blocks: list[PyBlock], sandbox: dict, verbose: bool = True) -> int:
    """Выполняет все блоки. Возвращает количество ошибок."""
    errors = 0
    for i, b in enumerate(blocks, 1):
        if verbose:
            print(f"n[py #{i}] строка {b.line} ({len(b.code)} симв.)")
        try:
            exec(b.code, sandbox)        # noqa: S102 — локальный инструмент
        except Exception:
            errors += 1
            print(f"!!! Ошибка в блоке #{i} (строка MD {b.line}):")
            traceback.print_exc()
    return errors
Основной скрипт md_to_docx.py
# -*- coding: utf-8 -*-
"""md_to_docx.py — Markdown -> DOCX. Запуск: py -3.13 md_to_docx.py file.md"""

import os
import re
import sys

import mistune
from docx import Document
from docx.oxml.ns import qn
from docx.oxml.shared import OxmlElement
from docx.shared import Cm, Pt
from docx.enum.style import WD_STYLE_TYPE
from py_block import extract as py_extract, make_sandbox, run_blocks

# ============================================================
# СТИЛИ И ПАРАМЕТРЫ
# ============================================================
STYLE_HEADING_PREFIX = "Heading"
STYLE_IMAGE          = "Картинка"
STYLE_FIGURE_CAPTION = "Подпись картинки"
STYLE_TABLE_CAPTION  = "Название таблицы"
STYLE_TABLE          = "Table Grid"
STYLE_NORMAL         = "Normal"

CUSTOM_BULLET_STYLE = "Custom Bullet List"
CUSTOM_NUMBER_STYLE = "Custom Number List"

SEQ_FIGURE     = "Рисунок"
SEQ_TABLE      = "Таблица"
IMAGE_WIDTH_CM = 14

ALIASES = {}
for _i in range(1, 10):
    ALIASES[f"заголовок {_i}"] = f"Heading {_i}"
    ALIASES[f"heading{_i}"] = f"Heading {_i}"
ALIASES.update({
    "обычный": "Normal",
    "сетка таблицы": "Table Grid",
})


def norm(name):
    return " ".join(name.split()).casefold()


def add_word_field(paragraph, instr):
    run = paragraph.add_run()
    begin = OxmlElement("w:fldChar")
    begin.set(qn("w:fldCharType"), "begin")
    run._r.append(begin)
    code = OxmlElement("w:instrText")
    code.set(qn("xml:space"), "preserve")
    code.text = f" {instr} "
    run._r.append(code)
    separate = OxmlElement("w:fldChar")
    separate.set(qn("w:fldCharType"), "separate")
    run._r.append(separate)
    cached = OxmlElement("w:t")
    cached.text = "1"
    run._r.append(cached)
    end = OxmlElement("w:fldChar")
    end.set(qn("w:fldCharType"), "end")
    run._r.append(end)


def close_word_file(filepath):
    if not os.path.exists(filepath):
        return True
    try:
        with open(filepath, "r+b"):
            return True
    except PermissionError:
        pass

    try:
        import win32com.client as win32
        word = win32.GetActiveObject("Word.Application")
        abs_path = os.path.abspath(filepath).lower()
        for doc in word.Documents:
            if doc.FullName.lower() == abs_path:
                doc.Close(SaveChanges=0)
                print(f"  [ОК] Файл закрыт в Word: {os.path.basename(filepath)}")
                return True
        print(f"  [!] Файл занят другим процессом. Закройте его вручную.")
        return False
    except ImportError:
        print(f"  [!] Файл '{os.path.basename(filepath)}' открыт в Word.")
        print(f"      Установите pywin32 (py -3.13 -m pip install pywin32),")
        print(f"      чтобы скрипт закрывал его автоматически.")
        return False
    except Exception as e:
        print(f"  [!] Не удалось закрыть файл через Word: {e}")
        return False


class DocxGenerator:
    def __init__(self, md_path, template_path=None):
        self.md_path = md_path
        self.base_dir = os.path.dirname(os.path.abspath(md_path))

        if template_path and os.path.exists(template_path):
            self.doc = Document(template_path)
            self.clear_document()
        else:
            self.doc = Document()

        self._style_index = {}
        for s in self.doc.styles:
            self._style_index.setdefault(norm(s.name), s)
            self._style_index.setdefault(norm(s.style_id), s)
        self._warned = set()
        self.bookmark_id = 1

        settings = self.doc.settings.element
        upd = settings.find(qn("w:updateFields"))
        if upd is None:
            upd = OxmlElement("w:updateFields")
            settings.append(upd)
        upd.set(qn("w:val"), "true")

    def clear_document(self):
        body = self.doc.element.body
        for child in list(body):
            if child.tag in (qn("w:p"), qn("w:tbl")):
                body.remove(child)

    def _find_style(self, name):
        s = self._style_index.get(norm(name))
        if s is not None: return s
        alias = ALIASES.get(norm(name))
        return self._style_index.get(norm(alias)) if alias else None

    def _warn(self, name):
        if name not in self._warned:
            self._warned.add(name)
            print(f"!!! Стиль '{name}' не найден. Применяется 'Normal'.")

    def apply_style(self, paragraph, name):
        s = self._find_style(name)
        if s is None:
            self._warn(name)
            s = self._find_style(STYLE_NORMAL)
        if s is not None:
            paragraph.style = s

    def _create_bullet_style(self):
        """Создаёт стиль маркированного списка с маркером — (длинное тире)."""
        # Проверяем через norm, что стиль уже есть
        existing = self._find_style(CUSTOM_BULLET_STYLE)
        if existing:
            return existing

        # Создаём новый стиль
        style = self.doc.styles.add_style(CUSTOM_BULLET_STYLE, WD_STYLE_TYPE.PARAGRAPH)
        style.base_style = self.doc.styles[STYLE_NORMAL]

        # Настраиваем отступы
        style.paragraph_format.left_indent = Cm(1.25)
        style.paragraph_format.first_line_indent = Cm(-0.63)

        # Добавляем в индекс
        self._style_index[norm(CUSTOM_BULLET_STYLE)] = style

        return style

    def _create_number_style(self):
        """Создаёт стиль нумерованного списка."""
        existing = self._find_style(CUSTOM_NUMBER_STYLE)
        if existing:
            return existing

        style = self.doc.styles.add_style(CUSTOM_NUMBER_STYLE, WD_STYLE_TYPE.PARAGRAPH)
        style.base_style = self.doc.styles[STYLE_NORMAL]

        style.paragraph_format.left_indent = Cm(1.25)
        style.paragraph_format.first_line_indent = Cm(-0.63)

        self._style_index[norm(CUSTOM_NUMBER_STYLE)] = style

        return style

    def _get_list_style(self, is_ordered):
        """Ищет стиль списка в шаблоне. Если не находит — создаёт фолбэк."""
        if is_ordered:
            candidates = ["Список маркеров", "List Number", "Нумерованный список"]
        else:
            candidates = ["Список маркеров", "List Bullet", "Маркированный список"]

        for name in candidates:
            s = self._find_style(name)
            if s is not None:
                return s, False  # (стиль, использовать_фолбэк)

        # Стиль не найден — создаём фолбэк
        if is_ordered:
            return self._create_number_style(), True
        else:
            return self._create_bullet_style(), True

    def _caption(self, style_name, label, seq_name, text):
        p = self.doc.add_paragraph()
        self.apply_style(p, style_name)
        p.add_run(f"{label} ")
        bm_id = str(self.bookmark_id)
        start = OxmlElement("w:bookmarkStart")
        start.set(qn("w:id"), bm_id)
        start.set(qn("w:name"), self.pending_label)
        p._p.append(start)
        add_word_field(p, f"SEQ {seq_name} \* ARABIC")
        end = OxmlElement("w:bookmarkEnd")
        end.set(qn("w:id"), bm_id)
        p._p.append(end)
        self.bookmark_id += 1
        p.add_run(f". {text}")

    def render_figure_caption(self, text, label_id):
        self.pending_label = label_id
        self._caption(STYLE_FIGURE_CAPTION, SEQ_FIGURE, SEQ_FIGURE, text)

    def render_table_caption(self, text, label_id):
        self.pending_label = label_id
        self._caption(STYLE_TABLE_CAPTION, SEQ_TABLE, SEQ_TABLE, text)

    def get_text(self, children):
        out = ""
        for c in children:
            if c["type"] == "text":
                out += c.get("raw", "")
            elif "children" in c:
                out += self.get_text(c["children"])
        return out

    def render_inline(self, children, paragraph, bold=False, italic=False, underline=False):
        for c in children:
            t = c["type"]
            if t == "text":
                self._render_text(c.get("raw", ""), paragraph, bold, italic, underline)
            elif t == "strong":
                self.render_inline(c["children"], paragraph, True, italic, underline)
            elif t == "emphasis":
                self.render_inline(c["children"], paragraph, bold, True, underline)
            elif t == "codespan":
                paragraph.add_run(c.get("raw", "")).font.name = "Courier New"
            elif t == "link":
                self.render_inline(c.get("children", []), paragraph, bold, italic, underline)
            elif t == "image":
                self.render_image(c)

    def _render_text(self, text, paragraph, bold, italic, underline):
        for part in re.split(r'(++[^+]+++)', text):
            if part.startswith('++') and part.endswith('++') and len(part) > 4:
                self._render_text_with_links(part[2:-2], paragraph, bold, italic, True)
            else:
                self._render_text_with_links(part, paragraph, bold, italic, underline)

    def _render_text_with_links(self, text, paragraph, bold, italic, underline):
        for part in re.split(r'(@(?:fig|tbl)-[w-]+)', text):
            if re.fullmatch(r'@(?:fig|tbl)-[w-]+', part):
                add_word_field(paragraph, f"REF {part[1:]} \h")
            elif part:
                r = paragraph.add_run(part)
                r.bold = bold
                r.italic = italic
                r.underline = underline

    def render_image(self, child):
        attrs = child.get("attrs", {})
        src = attrs.get("url", "")
        if not os.path.isabs(src):
            src = os.path.join(self.base_dir, src)
        caption = self.get_text(child.get("children", []))
        m = re.search(r"{#([w-]+)}", caption)
        p = self.doc.add_paragraph()
        self.apply_style(p, STYLE_IMAGE)
        try:
            p.add_run().add_picture(src, width=Cm(IMAGE_WIDTH_CM))
        except Exception as e:
            print(f"!!! Картинка не вставлена ({src}): {e}")
        if m:
            text = caption.replace(m.group(0), "").strip()
            self.render_figure_caption(text, m.group(1))

    def render_table(self, token):
        # Собираем строки как списки AST-ячеек (с детьми), а не как строки
        rows = []
        for section in token.get("children", []):
            children = section.get("children", [])
            if not children:
                continue
            if children[0]["type"] == "table_row":
                for row in children:
                    rows.append(list(row.get("children", [])))
            else:
                rows.append(list(children))
        if not rows:
            return

        cols = max(len(r) for r in rows)
        for r in rows:
            r += [None] * (cols - len(r))

        table = self.doc.add_table(rows=len(rows), cols=cols)
        s = self._find_style(STYLE_TABLE)
        if s is not None:
            table.style = s

        for i, row_cells in enumerate(rows):
            for j, cell_ast in enumerate(row_cells):
                try:
                    cell = table.cell(i, j)
                    is_empty = self._cell_is_empty(cell_ast)

                    # Merge пустых ячеек с предыдущей (как было)
                    if is_empty and j > 0 and not self._cell_is_empty(row_cells[j - 1]):
                        cell.merge(table.cell(i, j - 1))
                        continue

                    # Очищаем дефолтный параграф ячейки
                    for p in list(cell.paragraphs):
                        p_element = p._element
                        p_element.getparent().remove(p_element)

                    # Создаём новый параграф и рендерим инлайн-разметку
                    p = cell.add_paragraph()
                    if cell_ast is not None and "children" in cell_ast:
                        self.render_inline(cell_ast["children"], p)
                except Exception as e:
                    print(f"!!! Ячейка {i},{j}: {e}")

    def _cell_is_empty(self, cell_ast):
        """Проверяет, пуста ли ячейка (для логики merge)."""
        if cell_ast is None:
            return True
        children = cell_ast.get("children", [])
        if not children:
            return not (cell_ast.get("text") or cell_ast.get("raw") or "").strip()
        return not self.get_text(children).strip()
        def _cell_text(self, cell):
            if "children" in cell:
                return self.get_text(cell["children"])
            return cell.get("text", cell.get("raw", ""))

    def render_block(self, token):
        t = token["type"]
        if t == "paragraph":
            content = self.get_text(token.get("children", []))
            if content.startswith(("Таблица: ", "Table: ")):
                text = re.sub(r"^(Таблица: |Table: )", "", content)
                m = re.search(r"{#([w-]+)}", text)
                label = m.group(1) if m else f"tbl-{self.bookmark_id}"
                text = text.replace(m.group(0), "").strip() if m else text
                self.render_table_caption(text, label)
                return
            p = self.doc.add_paragraph()
            self.render_inline(token.get("children", []), p)
        elif t == "heading":
            level = token["attrs"]["level"]
            p = self.doc.add_paragraph()
            self.apply_style(p, f"{STYLE_HEADING_PREFIX} {level}")
            self.render_inline(token.get("children", []), p)
        elif t == "list":
            self.render_list(token, counter=[1])
        elif t == "table":
            self.render_table(token)

    def render_list(self, token, counter=None):
        """Рекурсивная отрисовка списков."""
        if counter is None:
            counter = [1]

        is_ordered = token["attrs"].get("ordered", False)
        style, use_fallback = self._get_list_style(is_ordered)

        items_count = 0
        for item in token.get("children", []):
            for block in item.get("children", []):
                if block["type"] == "paragraph":
                    p = self.doc.add_paragraph()
                    p.style = style

                    # Отступы
                    p.paragraph_format.first_line_indent = Cm(1.25)
                    p.paragraph_format.left_indent = Cm(0)

                    # Только если стиль не найден — рисуем маркер вручную
                    if use_fallback:
                        if is_ordered:
                            marker = f"{counter[0]}. "
                            counter[0] += 1
                        else:
                            marker = "— "
                        r = p.add_run(marker)
                        r.bold = False

                    self.render_inline(block.get("children", []), p)
                    items_count += 1
                elif block["type"] == "list":
                    self.render_list(block, counter=counter)

        fallback_msg = " (фолбэк: маркер рисуется вручную)" if use_fallback else ""
        print(f"  [ОК] Список ({'нумерованный' if is_ordered else 'маркированный'}), элементов: {items_count}{fallback_msg}")

    def render(self, md_text):
        # 1. Вытаскиваем и выполняем Python-блоки
        md_text, py_blocks = py_extract(md_text)
        if py_blocks:
            print(f"nНайдено Python-блоков: {len(py_blocks)}")
            sandbox = make_sandbox(self.doc, self)
            errors = run_blocks(py_blocks, sandbox)
            if errors:
                print(f"!!! Ошибок в Python-блоках: {errors}")

        md_text = md_text.replace("—»", "→").replace("-->", "→").replace("->", "→")
        md_text = re.sub(r'([^n])n([ t]*[-*]|d+.)', r'1nn2', md_text)
        md_text = re.sub(r'^([ t]*)[–—]([ t]+)', r'1-2', md_text, flags=re.MULTILINE)

        md = mistune.create_markdown(renderer=None, plugins=["table", "strikethrough"])
        tokens = list(md(md_text))

        list_count = sum(1 for t in tokens if t["type"] == "list")
        print(f"nНайдено списков в тексте: {list_count}")

        for token in tokens:
            self.render_block(token)

        out = os.path.splitext(self.md_path)[0] + ".docx"

        if not close_word_file(out):
            print("  [!] Сохранение невозможно. Повторите после закрытия файла.")
            sys.exit(1)

        self.doc.save(out)
        print(f"Успешно сохранено: {out}")

        # Открываем файл
        try:
            os.startfile(out)
            print(f"  [ОК] Файл открыт: {os.path.basename(out)}")
        except Exception as e:
            print(f"  [!] Не удалось открыть файл: {e}")


if __name__ == "__main__":
    if len(sys.argv) < 2:
        print("Использование: py -3.13 md_to_docx.py input.md")
        sys.exit(1)

    input_file = sys.argv[1]
    template = os.path.join(os.path.dirname(os.path.abspath(input_file)), "template.docx")
    if not os.path.exists(template):
        template = None

    with open(input_file, "r", encoding="utf-8") as f:
        text = f.read()

    DocxGenerator(input_file, template).render(text)
Пример использования
Исходный файл document. md
▼```py
# Настройка стилей
set_font(style("Heading 1"), name="Times New Roman", size=Pt(16),
         bold=True, color=RGBColor(0x1F, 0x38, 0x64))
set_para(style("Heading 1"), align=ALIGN["center"],
         space_before=Pt(12), space_after=Pt(6))

for lvl in range(2, 7):
    s = style(f"Heading {lvl}")
    set_font(s, name="Times New Roman", size=Pt(16 - lvl), bold=True)

set_font(style("Normal"), name="Times New Roman", size=Pt(14))
set_para(style("Normal"), align=ALIGN["justify"],
         first_line_indent=Cm(1.25), line_spacing=1.5,
         line_spacing_rule=LINE_SPACING["MULTIPLE"])
```

# Введение

Текст документа с автоматической настройкой стилей.

## Архитектура

Описание архитектуры системы.
Выполнение
▼python md_to_docx.py document.md
Результат: document. docx с настроенными стилями.
При открытии документа скорее всего появится модальное окошко:
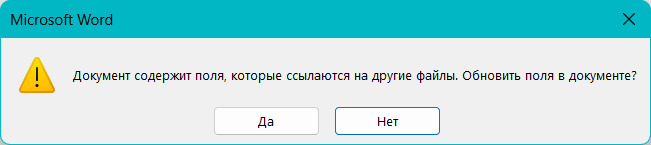
Кликаем «Да».
Интеграция с Sublime Text
Build System
В Sublime text необходимо создать новую систему сборки. Для этого идем по меню: Tools➡Build System➡New Build System…:
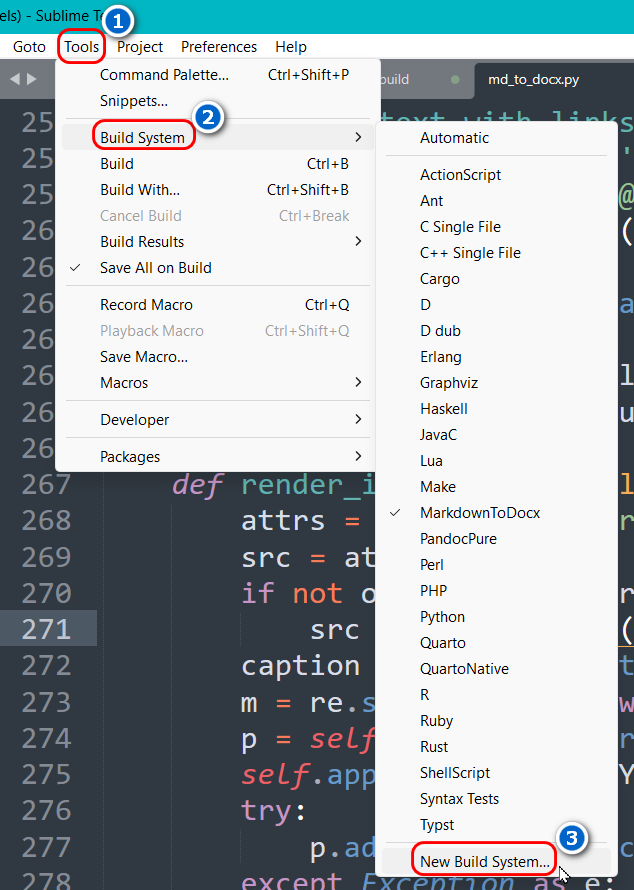
Полностью заменяем содержимое файл на следующее, но путь к скрипту md_to_docx.py у каждого будет свой, поэтому пишем нужную версию Пайтона вместо 3.13 и правильный путь вместо f:\\PyScripts\\md_to_docx.py:
▼{
    "shell_cmd": "py -3.13 -X utf8 "f:\PyScripts\md_to_docx.py" "$file"",
    "selector": "text.html.markdown",
    "working_dir": "$file_path",
    "encoding": "utf-8"
}
и сохраняем под именем, например MarkdownToDOCX. sublime-build. Никакие пути сохранения не трогаем, куда редактор по умолчанию предлагает сохранить, там и сохраняем. После этого в меню Tools➡Build System появится новый пункт с названием, например, MarkdownToDOCX, если сохранение было в файл MarkdownToDOCX. sublime-build. Название пункта меню соответствует имени файла. И пройдя в меню Tools➡Build надо по этому пункту кликнуть, чтобы по горячей клавише (хоткею) Ctrl+B (в настройках именно такая, если ничего не менялось) запустился бы на выполнение md_to_docx.py с передачей ему файла в активной вкладке редактора.
Использование
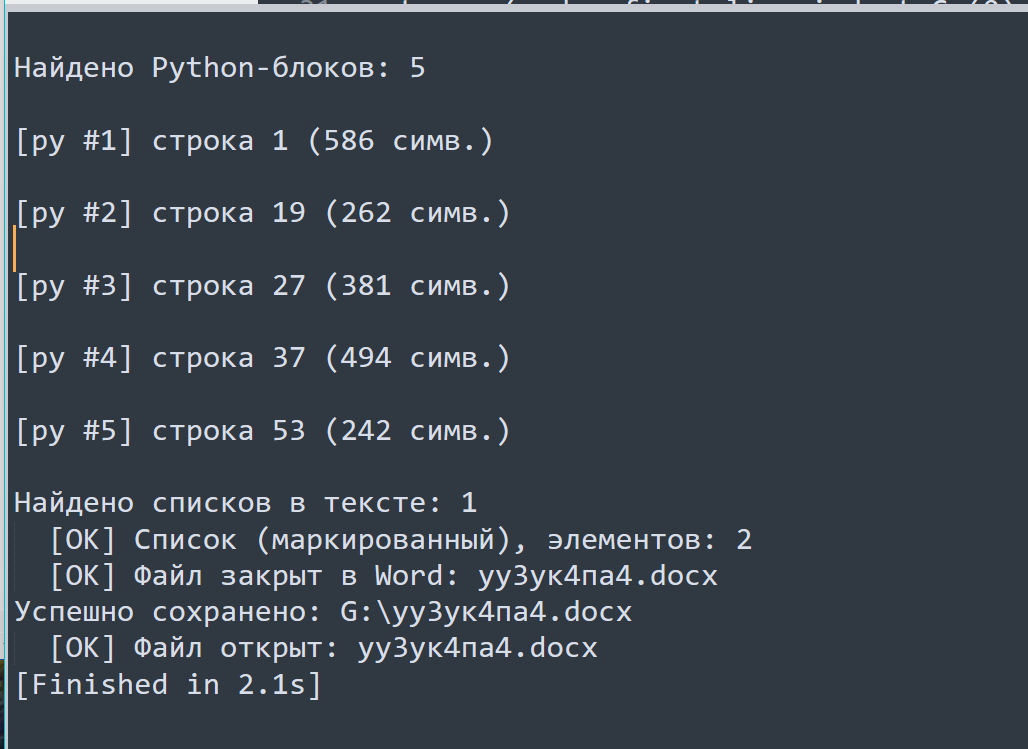
- Открыть .md файл в Sublime Text.
- Нажать Ctrl+B.
- Получить готовый .docx файл.
Преимущества подхода
Версионирование
Markdown-файлы — текст. Git отслеживает изменения:
▼- set_font(style("Heading 1"), size=Pt(14))
+ set_font(style("Heading 1"), size=Pt(16))
Возможны ветки, слияния, откаты.
Воспроизводимость
Документ собирается из исходников. Результат не зависит от версии Word или настроек среды.
Изоляция изменений
Каждый документ содержит собственное описание стилей. Изменение в одном файле не влияет на другие.
Автоматизация
Доступны все возможности Python:
▼# Циклы
for lvl in range(2, 7):
    set_font(style(f"Heading {lvl}"), size=Pt(16 - lvl))

# Условия
if doc.styles["Heading 1"].font.bold:
    set_font(style("Heading 1"), bold=False)

# Функции
def apply_gost_style(style_name):
    set_font(style(style_name), name="Times New Roman", size=Pt(14))
    set_para(style(style_name), align=ALIGN["justify"])

apply_gost_style("Normal")
Сравнение подходов
| Критерий | Шаблоны Word | Markdown + Python |
|---|---|---|
| Версионирование | Нет (бинарный формат) | Да (текст, Git) |
| Воспроизводимость | Зависит от среды | Независима |
| Изоляция изменений | Нет (глобальное состояние) | Да (каждый документ) |
| Автоматизация | VBA (ограниченно) | Полный Python |
| Переиспользование | Копирование шаблонов | Функции, модули |
| Порог входа | Низкий (GUI) | Средний (Python) |
| Гибкость | Ограничена GUI | Без ограничений |
Ограничения
Требуются навыки Python. Пользователь должен знать основы Python для настройки стилей.
Отсутствие визуального редактора стилей. Настройки задаются кодом, а не через диалоговые окна.
Неполная поддержка OOXML. Библиотека python-docx покрывает не все возможности Word. Для сложных случаев требуется прямая работа с XML.
Заключение
Подход Markdown + Python заменяет шаблоны Word на версионируемые, воспроизводимые и автоматизируемые исходники. Стили описываются кодом, хранятся в текстовом формате, управляются через Git.
Обсудить
Добавить комментарий