Сколько «стоит» русский язык в нейросетях: посчитал токены одного текста в пяти токенизаторах
Нейросети по API тарифицируются не за слова и не за символы, а за токены. Токен — это кусочек текста, на которые модель режет всё, что ей отправляют. Английское слово часто укладывается в один токен, а вот с русским всё сложнее, и об этом редко пишут с цифрами. Поскольку я сам занимаюсь шлюзом к языковым моделям (проект называется Heli), вопрос «почему русский текст съедает больше» мне задают регулярно. Я решил не пересказывать чужие оценки, а посчитать сам.
Методика простая. Я написал два обычных рабочих текста: коммерческое письмо о поставке складского оборудования и инструкцию по сбросу пароля. Каждый — на русском и в близком по смыслу переводе на английский. Никакой экзотики, именно такие тексты компании гоняют через нейросети каждый день.
Потом прогнал все четыре текста через пять токенизаторов. Два из них принадлежат OpenAI: старый cl100k_base, которым пользуются GPT-4 и GPT-3.5, и новый o200k_base, который стоит в GPT-4o и более поздних моделях. Ещё три — открытые токенизаторы моделей DeepSeek-V3, Qwen2.5 и Mistral Nemo. Токенизаторы Claude и Gemini в открытом виде не опубликованы, поэтому их в сравнении нет.
Считал локально, без обращения к самим моделям: токенизатор — это отдельный словарь, и для подсчёта токенов модель не нужна. Весь замер занимает пару секунд.
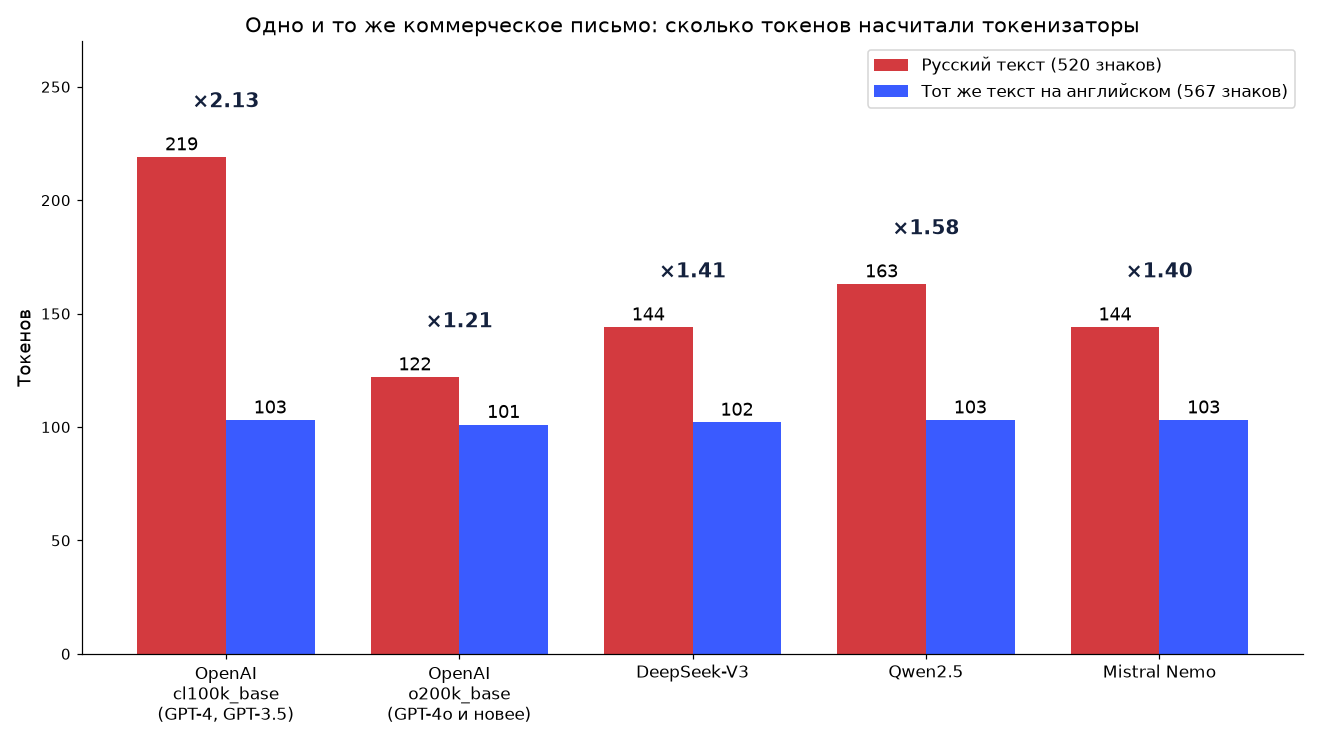
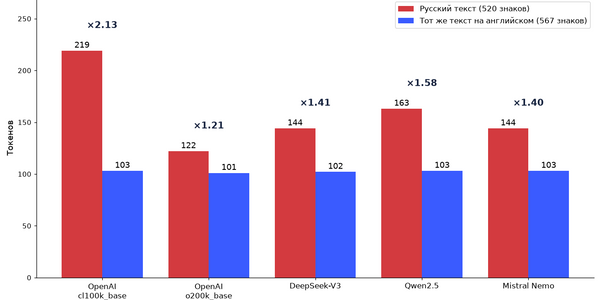
Главный результат на графике ниже: одно и то же письмо на русском и на английском, разница в разах подписана над столбцами.
Результаты
Русская версия письма занимает 520 знаков, английская — 567. Английский текст все пять токенизаторов посчитали почти одинаково: от 101 до 103 токенов. С русским разброс огромный.
| Токенизатор | Письмо RU | Письмо EN | RU/EN | Инструкция RU | Инструкция EN | RU/EN |
|---|---|---|---|---|---|---|
| OpenAI cl100k_base (GPT-4, GPT-3.5) | 219 | 103 | 2,13 | 181 | 94 | 1,93 |
| OpenAI o200k_base (GPT-4o и новее) | 122 | 101 | 1,21 | 113 | 93 | 1,22 |
| DeepSeek-V3 | 144 | 102 | 1,41 | 136 | 95 | 1,43 |
| Qwen2.5 | 163 | 103 | 1,58 | 142 | 94 | 1,51 |
| Mistral Nemo | 144 | 103 | 1,40 | 132 | 96 | 1,38 |
Самое заметное — разница между двумя поколениями токенизаторов OpenAI. Старый cl100k_base режет русский текст почти вдвое мельче английского: около 2,4 знака на токен против 5 с лишним у английского. Новый o200k_base справляется с кириллицей намного лучше, у него около 4 знаков на токен, и отрыв от английского сокращается примерно до 20%. Словарь у него примерно вдвое больше, чем у предшественника, и, судя по результату, в нём нашлось место для частых русских слов и их кусков целиком.
Открытые модели DeepSeek, Qwen и Mistral оказались посередине: русский текст у них выходит на 40-60% «дороже» английского. Интересно, что Qwen, при всей его популярности, в этом замере кириллицу кодирует хуже остальных открытых.
Вторая пара текстов, инструкция по сбросу пароля, дала очень близкие соотношения. Значит, это не особенность конкретного письма.
Что это значит на практике
Цена в прайсах указывается за миллион токенов. Если две модели стоят одинаково за миллион, но одна режет ваш русский текст на 60% мельче, то и платить за неё вы будете больше. Причём это касается и входа, и выхода: ответ модели на русском тоже раскладывается на токены её же словарём.
Отсюда два вывода. Первый: сравнивать модели по строчке в прайсе для русскоязычных задач некорректно, нужно прогонять свои реальные тексты и смотреть на итоговое число токенов. Второй: если у вас старый проект, который до сих пор работает на модели с cl100k_base, то переезд на новое поколение может заметно сократить расход токенов на русских текстах, даже при той же цене за миллион.
Есть и побочный эффект, о котором часто забывают. Контекстное окно модели тоже меряется в токенах. Чем мельче нарезан текст, тем меньше русских страниц влезает в тот же лимит.
Как повторить
Для токенизаторов OpenAI нужна библиотека tiktoken — она открыта и ставится одной командой: https://github.com/openai/tiktoken. Я пользовался версией 0.14.0. Нужный словарь выбирается по имени модели или напрямую по названию кодировки, а длина текста в токенах — это просто длина списка, который возвращает encode.
Для открытых моделей достаточно скачать файл tokenizer. json из репозитория модели на Hugging Face и загрузить его библиотекой tokenizers. Например, DeepSeek-V3 лежит здесь: https://huggingface.co/deepseek-ai/DeepSeek-V3, а Qwen2.5 — здесь: https://huggingface.co/Qwen/Qwen2.5-7B-Instruct. Служебные токены при подсчёте я не добавлял, чтобы сравнивать только сам текст.
Оговорки
Выборка маленькая, два текста, и я не претендую на научную точность. Соотношения для художественной литературы, юридических документов или текста с кодом могут быть другими. Кроме того, реальный запрос к модели всегда содержит ещё и служебную разметку диалога, а для рассуждающих моделей добавляются скрытые токены размышлений, которые тоже оплачиваются. Но общий порядок цифр, по-моему, показательный, и проверить его на своих текстах можно за пять минут.
Если у вас есть под рукой другие токенизаторы или свои рабочие тексты, напишите в комментариях, какие соотношения получились. Особенно интересно было бы сравнить с моделями, которые сделаны специально под русский язык.

1 комментарий
Добавить комментарий