Тест gpu-unlock на RTX 3060 Ti: SDXL тратит на 11% меньше времени, а llama.cpp не ускорился
Проверили gpu-unlock на RTX 3060 Ti с 8 ГБ видеопамяти. В отдельных матричных вычислениях прирост достиг почти 94%, время прогона SDXL сократилось примерно на 11%, а две локальные языковые модели заметно быстрее не стали. Сравнивали одну карту с одинаковыми настройками до и после разблокировки.
У меня RTX 3060 Ti с 8 ГБ памяти. Она используется для генерации изображений и запуска языковых моделей — программ, похожих по назначению на ChatGPT, но работающих на своём компьютере. Поэтому проект gpu-unlock заинтересовал меня с практической стороны: будет ли меньше ожидание картинки и быстрее ли начнёт отвечать локальный помощник?
Проверили оба сценария. Результат оказался разным.
Что именно разблокировали
Речь о проекте gpu-unlock. По описанию разработчика, он снимает ограничение некоторых вычислений на тензорных ядрах NVIDIA. Это специальные блоки видеокарты, которые используются в том числе нейросетями.
Здесь легко неправильно понять слово «ускорение». Видеокарта выполняет много разных операций. Если ускорить одну из них, остальные не обязательно станут быстрее. Больше видеопамяти тоже не появится: мои 8 ГБ так и остались 8 ГБ.
В нашем эксперименте разблокировка выполнялась модулем ядра Linux при загрузке системы. BIOS видеокарты не перепрошивали, драйвер NVIDIA между сравниваемыми режимами не обновляли.
Это не кнопка в настройках нейросети. Установка затрагивает загрузку операционной системы, поэтому перед ней нужен способ отката. Статья описывает результат проверки, а не предлагает запускать случайный установщик из ролика.
Как проверяли
Сравнили одну и ту же карту без разблокировки и с ней. Модели и настройки тестов между режимами не меняли.
Проверки разделили на три части:
• специальный вычислительный тест, чтобы убедиться, что разблокировка вообще действует;
• генерацию картинок;
• работу локальных языковых моделей.
В тесте изображений сначала выполняли прогрев, а затем три измеренных прогона. Для каждой языковой модели записали по три повтора в каждом режиме. Это небольшой домашний эксперимент, не исследование всех видеокарт и всех нейросетей.
Первый запуск SDXL не завершился из-за ошибки NameError: tag в проверочном скрипте. Исправили только передачу параметра скрипта, после чего выполнили четыре успешные генерации с исходными служебными добавками к запросам: один прогрев и три измерения. Неудачный запуск в среднее не включали.
Где проходил эксперимент
Программы работали в Linux-контейнере на Proxmox — изолированной среде для запуска программ. Контейнер использует ядро хоста, поэтому модуль разблокировки устанавливали на сам хост Proxmox, а не внутрь ComfyUI. Ядро в сравниваемых режимах: 7.0.14-8-pve. При переключении режимов перезагружался весь этот хост.
При дополнительной проверке стенда обнаружены AMD Ryzen 5 3600 (6 ядер, 12 потоков) и около 39,1 ГиБ памяти, видимой Linux на хосте. Для контейнера сейчас выделены 8 логических процессоров, лимит памяти 32 ГиБ и 8 ГиБ swap — подкачки на диске. ГиБ — двоичные гигабайты. Это конфигурация, прочитанная после тестов, а не отдельная запись аппаратных параметров в момент каждого прогона. Для сравнения скорости 35B с другой машиной процессор и память особенно важны.
Вычислительный тест: разблокировка работает
Нейросеть работает с числами: и текст, и изображение во время обработки представлены числовыми данными. Один из видов вычислений, которые она выполняет, — умножение матриц, то есть таблиц чисел. Сначала мы проверили именно эту операцию отдельно, без создания картинки или ответа чат-бота. Так можно увидеть, ускорилась ли та часть вычислений, на которую рассчитана разблокировка.
Для проверки видеокарте давали большие таблицы чисел и измеряли скорость их перемножения. Сначала выполняли два пробных запуска для прогрева, затем пять измерений. Проверили два способа хранения чисел, которые применяются в нейросетях: BF16 и FP16. Эти обозначения в таблице — варианты вычислений, а не разные видеокарты или нейросети.
В таблице показаны результаты основной серии после перезагрузки. Размер матрицы — число строк и столбцов в таблице: например, 4096 x 4096. Скорость указана в TFLOPS — триллионах арифметических операций в секунду. Чем больше число в одной строке, тем быстрее карта выполняла этот конкретный тест. Это не оценка скорости всех программ сразу.
| Тест | Без разблокировки | С разблокировкой | Изменение |
|---|---|---|---|
| BF16, матрица 10240 x 10240 | 37,60 TFLOPS | 65,19 TFLOPS | +73,38% |
| FP16, матрица 4096 x 4096 | 37,31 TFLOPS | 72,35 TFLOPS | +93,92% |
В этих двух тестах прирост составил примерно 73% и 94%. Но готовая программа выполняет не только умножение матриц: она ещё загружает данные и делает другие вычисления. Поэтому почти двукратный прирост здесь не обещает такого же ускорения генерации картинок или текста. Перед проверкой языковых моделей выполнили отдельный контрольный замер BF16: он дал 37,99 → 64,28 TFLOPS. Это другая серия прогонов, поэтому значения немного отличаются от основной таблицы.
Численную точность результата умножения матриц отдельно не измеряли. Совпадение изображений SDXL подтверждено, но оно не заменяет проверку точности матричного теста.
После перезагрузки включение разблокировки подтвердили по журналу системы. Дополнительный вычислительный тест перед проверкой текста тоже показал прирост. Поэтому отсутствие ускорения у языковых моделей нельзя объяснить тем, что разблокировка просто не включилась.
Генерация картинок: ждать действительно меньше
Для изображений использовали SDXL 1.0 в ComfyUI. SDXL — модель, которая создаёт картинку по текстовому описанию, а ComfyUI — программа для её запуска.
Выбрали изображение размером 1024 x 1024 пикселя и 20 шагов генерации. В каждой сравниваемой паре сохраняли одинаковые текстовое описание, исходное случайное значение и остальные настройки. Проверяли, что программа заново генерирует изображение, а не возвращает готовое из кеша. Перед каждым прогоном выгружали модель и освобождали память, поэтому полное время включает повторную загрузку модели.
| Проверка | Среднее время одной генерации |
|---|---|
| Без разблокировки | 26,214 с |
| С разблокировкой | 23,357 с |
| Повторная проверка с разблокировкой | 23,214 с |
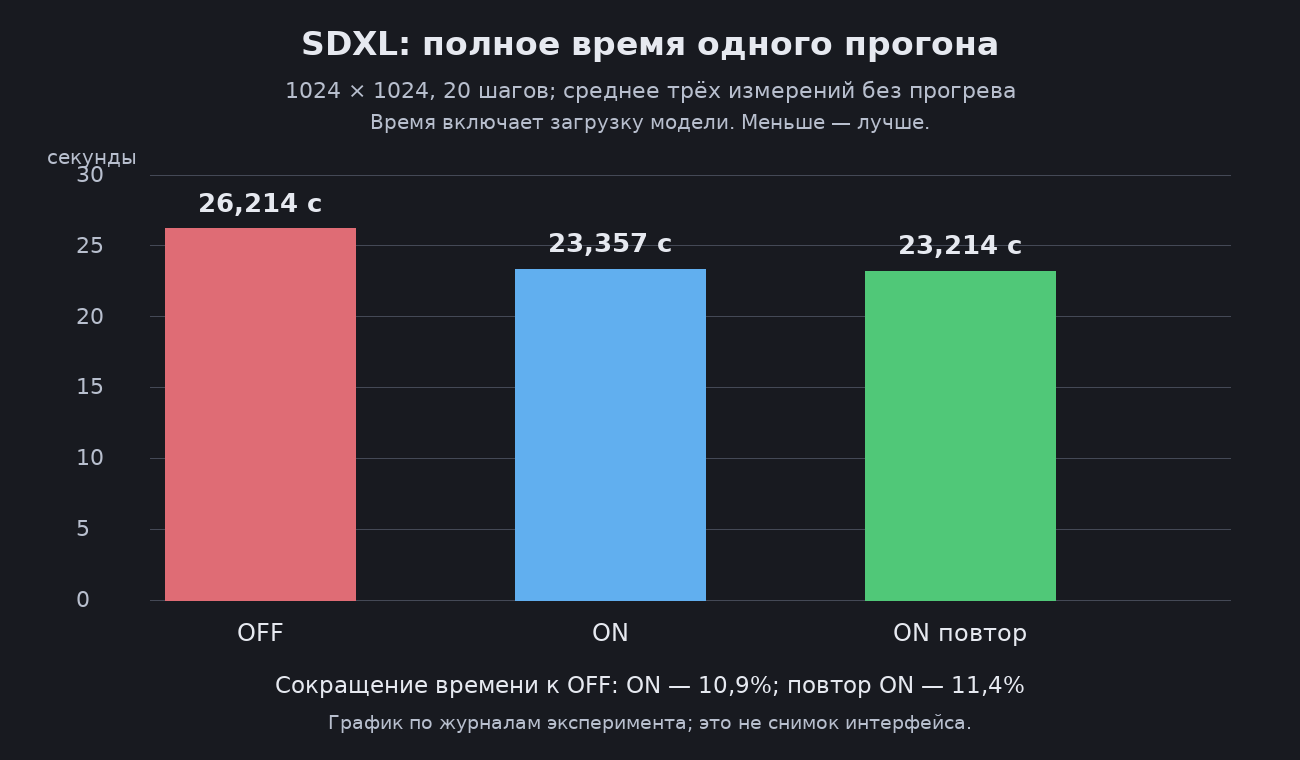
График построен по журналам измерений. OFF — без разблокировки, ON — с ней. Это не скриншот интерфейса.
Повторный замер подтвердил первоначальный результат: время ожидания сократилось примерно на 11% относительно исходного теста без разблокировки.
Превращения старой карты в новую модель не произошло. Но выигрыш есть, и он воспроизводится. В этих сериях экономия составила примерно три секунды на прогон. Непрерывную очередь с моделью, постоянно загруженной в память, отдельно не проверяли.
Проверили и сами картинки. Во всех четырёх сравниваемых наборах, включая прогрев, изображения без разблокировки, с ней и при повторной проверке совпали попиксельно. В этих прогонах результат генерации не изменился. Для любых других моделей и настроек такую идентичность мы не гарантируем.
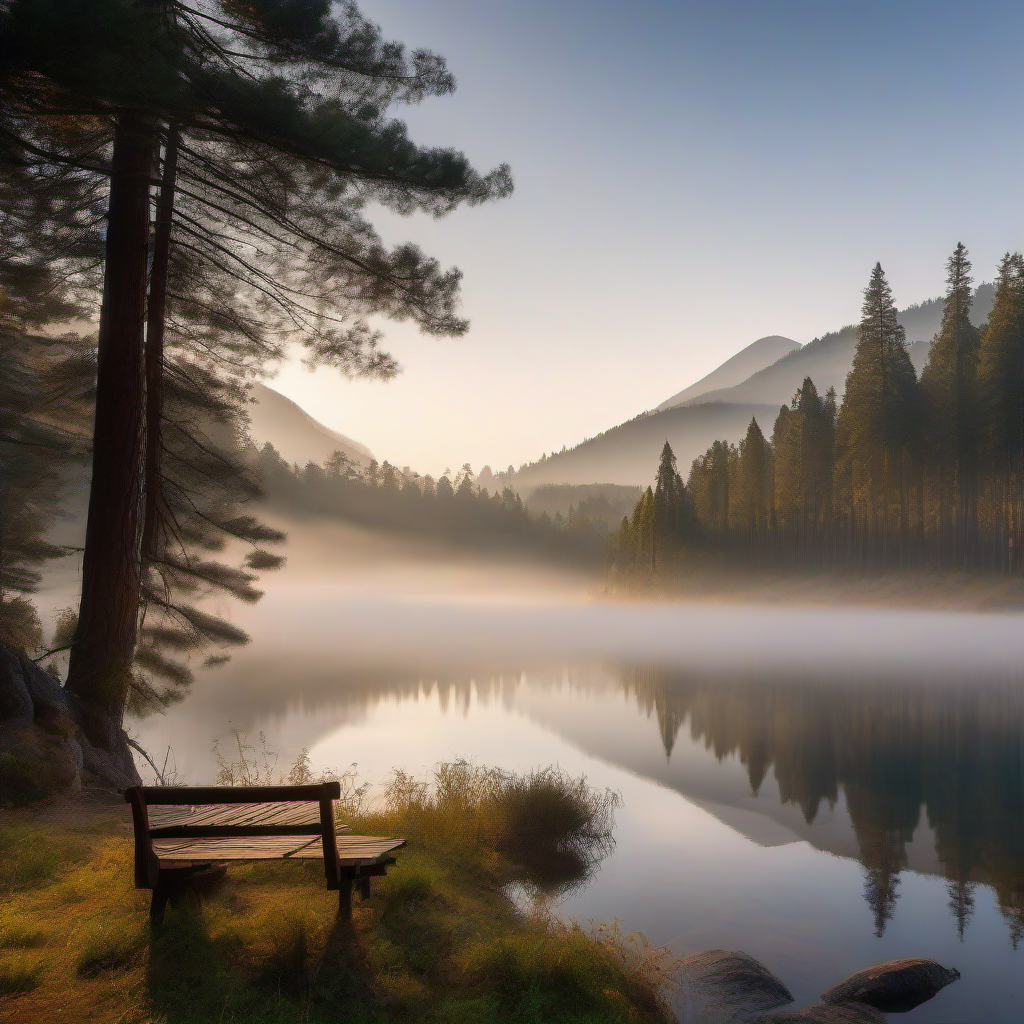
Изображение получено в SDXL во время теста. Оно сгенерировано нейросетью, а не снято камерой. Для соответствующей пары OFF/ON проверено попиксельное совпадение.
Локальный чат-бот: почти ничего не изменилось
Затем проверили две языковые модели семейства Qwen: 9B и 35B. Числа в названии обозначают приблизительное количество параметров в миллиардах. Обе использовались в уменьшенном по объёму формате Q4_K_M, чтобы требовать меньше памяти. Для модели 35B часть вычислений выполнял процессор компьютера.
У языковой модели замеряли два этапа: обработку входного текста и последующую генерацию ответа. В первом случае модель читает запрос, во втором выдаёт ответ небольшими фрагментами — токенами. Токен может быть словом, частью слова или знаком, поэтому токены в секунду не равны словам в секунду.
| Модель | Генерация без разблокировки | Генерация с разблокировкой |
|---|---|---|
| Qwen 9B | 66,90 токена/с | 66,95 токена/с |
| Qwen 35B, с участием процессора | 33,52 токена/с | 33,35 токена/с |
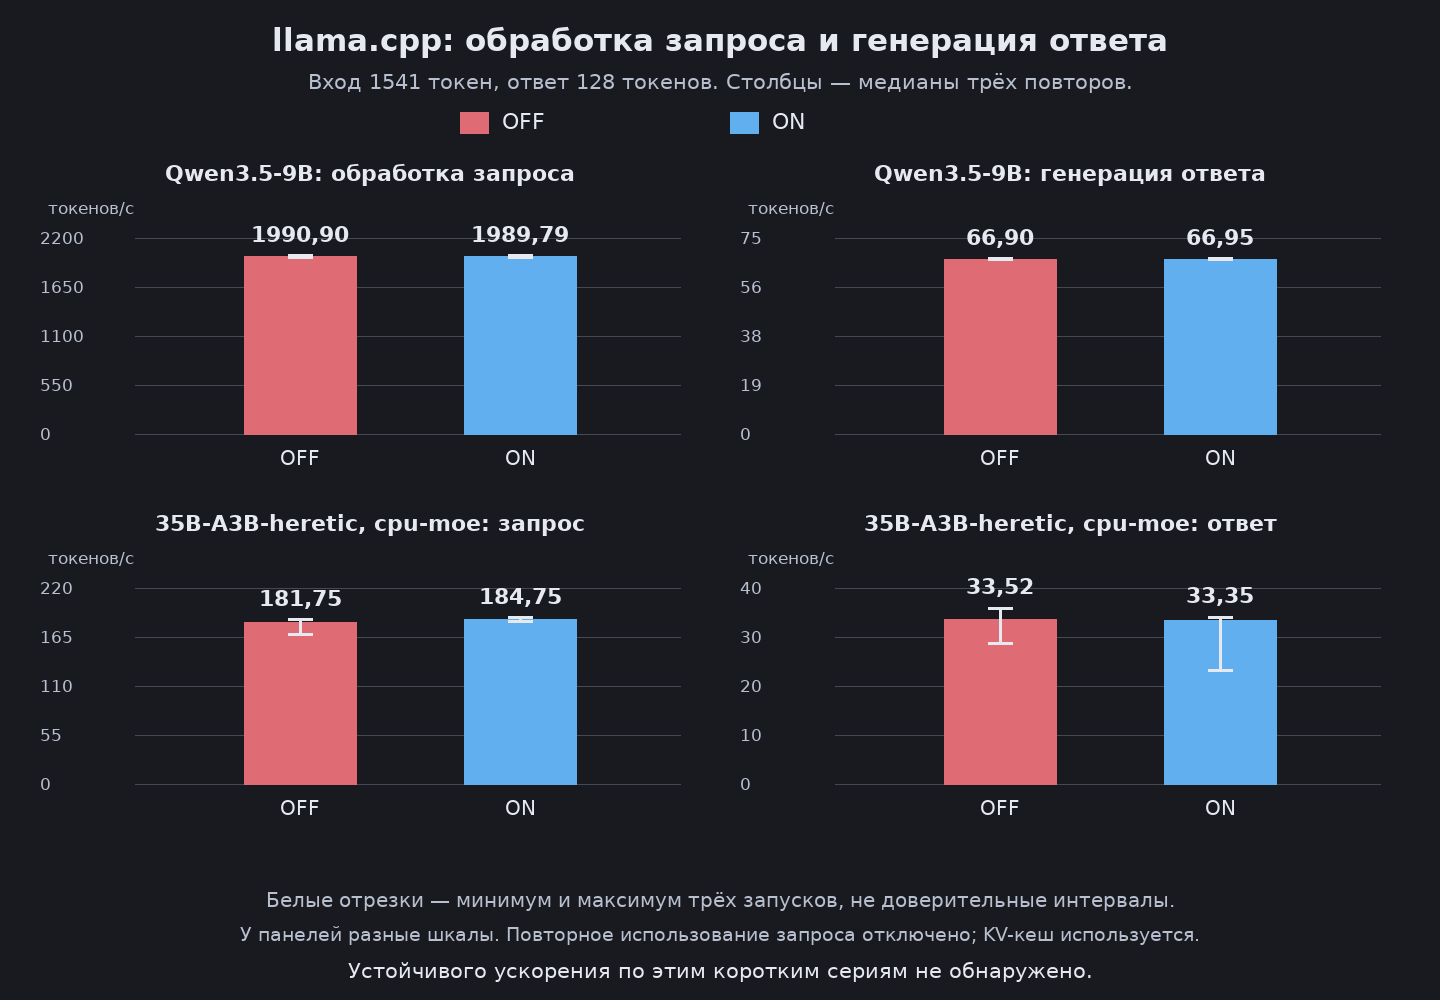
Столбцы показывают медианы, белые отрезки — минимум и максимум трёх повторов. У панелей разные шкалы.
Отдельно измерили скорость обработки входного запроса:
| Модель | Обработка запроса без разблокировки | С разблокировкой |
|---|---|---|
| Qwen3.5-9B | 1990,897 токена/с | 1989,792 токена/с |
| Qwen3.5-35B-A3B-heretic, с участием процессора | 181,747 токена/с | 184,749 токена/с |
Практически одинаково. Обработка входного текста тоже не показала убедительного улучшения: у 9B результат почти не изменился, у 35B разница составила около 1,65% и не дала оснований заявлять заметное ускорение.
В каждом режиме модель получала один и тот же текст на 1541 токен и генерировала 128 токенов. Повторное использование уже обработанного запроса отключили, чтобы не принять работу кеша за ускорение видеокарты.
Возможное объяснение: эти задачи ограничены не теми вычислениями, которые ускоряет разблокировка. Для уменьшенных моделей важна скорость чтения данных из памяти, а у 35B часть работы дополнительно выполняется на центральном процессоре (CPU). Точную причину без отдельного профилирования мы не устанавливаем. Но практический результат понятен: быстрее отвечать эти две модели не стали.
Температура и потребление
Во время повторного теста картинок записывали показатели видеокарты примерно раз в секунду. За сессию получили 124 записи.
Максимальные зарегистрированные значения:
| Показатель | Значение |
|---|---|
| Температура GPU | 50 °C |
| Потребление | 199,86 Вт |
| Установленный лимит мощности | 200 Вт |
| Загрузка GPU | 100% |
| Занятая видеопамять | 7203 МиБ из 8192 МиБ |
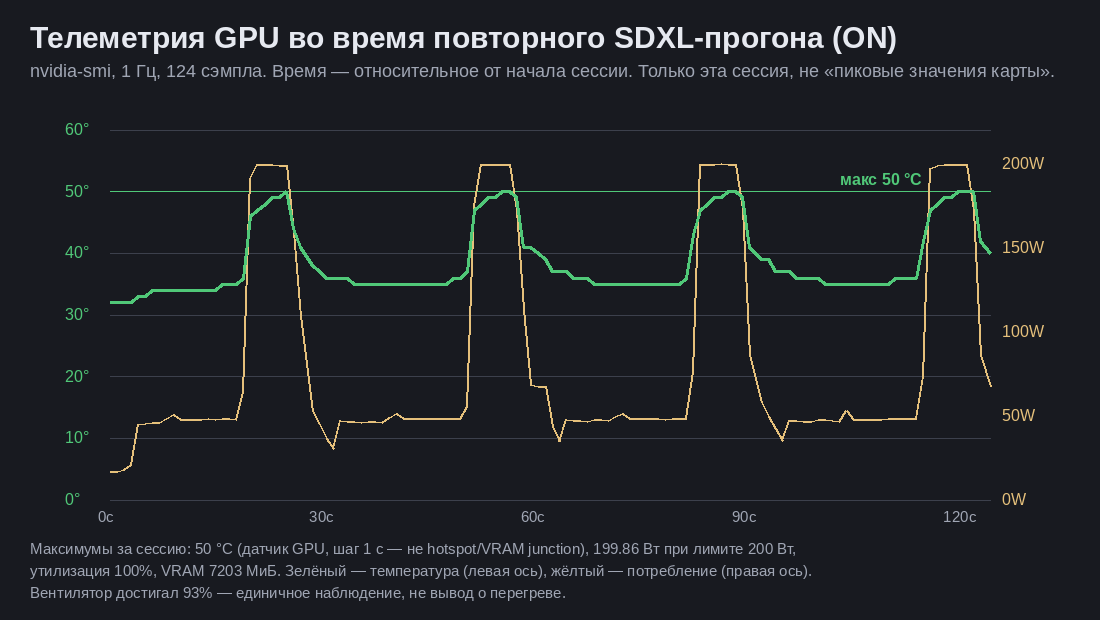
График построен по 124 отсчётам в повторной сессии с включённой разблокировкой.
Это показания одной сессии с включённой разблокировкой. Сопоставимой записи температуры и потребления без неё у нас нет, поэтому утверждать, что карта стала горячее или экономичнее, нельзя. Опрос раз в секунду также может пропустить короткий пик. Температуру самой горячей точки кристалла (hotspot) и памяти отдельно не измеряли.
В записи повторной SDXL-сессии частота графического ядра достигала 2040 МГц, частота памяти — 7001 МГц по показаниям nvidia-smi, утилиты мониторинга NVIDIA. Максимальная скорость вентилятора в этой записи составляла 93%. Это зарегистрированные значения, а не доказательство того, что после разблокировки частоты или обороты выросли: сопоставимой записи OFF нет.
Стоило ли пробовать
Для моего использования результат получился вполне конкретным: время одного прогона SDXL сократилось примерно на 11%, а проверенные локальные языковые модели работают с прежней скоростью.
Заголовок «видеокарта стала вдвое быстрее» здесь вводил бы в заблуждение. Заметный рост в одном вычислительном тесте не превращается автоматически в такой же выигрыш во всех программах.
Если основной интерес — локальный чат-бот на похожих уменьшенных моделях, наши замеры не дают повода ожидать чуда. Для генерации изображений польза оказалась заметнее. Но решение об установке всё равно стоит принимать с учётом риска вмешательства в загрузку системы.
Разблокировку после эксперимента оставили включённой. Возможность отката сохранили.
Для тех, кто захочет сравнить со своей системой
Тестировали RTX 3060 Ti 8 ГБ, драйвер NVIDIA 595.71.05, PyTorch 2.11.0+cu130, SDXL Base 1.0 и llama. cpp b10232. Языковые модели: Qwen3.5-9B Q4_K_M и Qwen3.5-35B-A3B-heretic Q4_K_M с переносом части вычислений на процессор.
Подробности для повторения проверки
Генерация изображений: все измеренные повторы
| Режим | Прогон 1 | Прогон 2 | Прогон 3 |
|---|---|---|---|
| Без разблокировки | 26,193 с | 26,249 с | 26,199 с |
| С разблокировкой | 23,500 с | 23,267 с | 23,303 с |
| Повтор с разблокировкой | 23,174 с | 22,823 с | 23,645 с |
Прогрев в эти средние значения не включали. Полное время прогона определяли по событиям начала и успешного завершения вычислений ComfyUI, а не по секундомеру загрузки веб-страницы. Оно включает выполнение графа генерации, в том числе загрузку модели; время работы отдельных узлов сохранено отдельно.
Все настройки генерации в каждой сравниваемой паре оставляли одинаковыми. Перед новым запуском модель выгружали из памяти, чтобы повторная загрузка учитывалась и до разблокировки, и после неё. Меняли небольшую служебную добавку к описанию картинки: это заставляло программу выполнить вычисления заново, а не вернуть уже готовый результат.
В разных повторах служебные добавки отличались, но для каждого варианта повторяли точно такое же задание и без разблокировки, и с ней. Генерировали горное озеро на рассвете с лесом и туманом над водой. Поэтому сравнивали не случайные картинки с разной сложностью, а время выполнения соответствующих одинаковых заданий.
Дополнительные условия теста языковых моделей
Каждую языковую модель проверяли по три раза в каждом режиме. В итоговую таблицу брали результат, который оказывался посередине между самым быстрым и самым медленным. Такой показатель называется медианой. У модели 35B скорость между повторами заметно колебалась; более медленные запуски из результатов не исключали.
Во всех запусках модель получала одинаковый входной текст и должна была выдать одинаковое количество токенов. Программе не позволяли сократить работу за счёт повторного использования уже обработанного запроса. Так проверяли скорость вычислений, а не скорость выдачи сохранённого результата.
Модели проверяли по очереди; генерация картинок в это время не работала. Скорость брали из отчёта самой программы, а не измеряли по появлению текста в браузере. Ответы на проверенный запрос до и после разблокировки совпали. Это наблюдение для одного задания, а не проверка общего качества ответов.
Границы эксперимента
Игры, другие видеокарты, другие модели генерации изображений и все возможные настройки языковых моделей не тестировались. Один конкретный результат нельзя переносить на них автоматически. Долговременную стабильность под многосуточной нагрузкой также не проверяли.
Графики к статье построены по сохранённым измерениям. Картинки «до/после» — реальные результаты генераций. Скриншотов интерфейса во время тестов получить не удалось; графики не следует выдавать за такие снимки.
Исходный код проекта: gpu-unlock на GitHub.
Источник: Результат авторского теста SDXL, не фотография
Обсудить
Добавить комментарий