«Коллапс знаний»: почему ИИ-чат-боты делают наше мышление более плоским и стереотипным
Поисковые системы меняют привычный формат работы. Вместо списка ссылок на независимые сайты пользователи все чаще видят готовые текстовые ответы, сгенерированные искусственным интеллектом прямо на странице поиска. Человеку больше не нужно открывать несколько источников, сопоставлять данные и делать выводы самостоятельно: алгоритм берет эту задачу на себя и выдает единый, обобщенный результат.
На первый взгляд такой подход экономит время. Однако за ним стоит серьезная проблема, которую исследователи называют коллапсом знаний. Когда люди массово перестают обращаться к первоисточникам и получают информацию исключительно через языковые модели, общедоступный кругозор неизбежно сужается. Алгоритм отбирает наиболее распространенные утверждения, а менее популярные, локальные или узкоспециализированные сведения постепенно выпадают из поля зрения общества.
Долгое время этот процесс обсуждался теоретически, либо ученые оценивали однообразие нейросетей по косвенным признакам — например, по повторяемости слов и стилистических конструкций. Коллектив авторов из Ольборгского, Копенгагенского, Стэнфордского университетов, а также университетов Колорадо и Техаса впервые провел строгое измерение эпистемического разнообразия нейросетей. Под этим термином понимается широта спектра реальных фактологических утверждений о мире, которые модель способна выдать пользователю.
Ученые протестировали 27 популярных языковых моделей, изучили 1,7 миллиона сгенерированных ответов и выделили из них 70 миллионов отдельных фактов. Результаты показали: современные нейросети действительно расширяют свой кругозор от версии к версии, но они по-прежнему заметно уступают обычному веб-поиску, страдают от географических перекосов и подчиняются парадоксальному правилу — чем крупнее модель, тем меньше разнообразия в ее знаниях.
Содержание
- Почему стандартные способы оценки разнообразия давали сбой
- Как измеряли факты: методика эксперимента
- Прогресс языковых моделей и превосходство веб-поиска
- Парадокс размера: почему малые модели дают больше разнообразия
- Чьи знания воспроизводит искусственный интеллект
- Влияние внешнего поиска: польза и уязвимость RAG
- Последствия для будущей работы с информацией
Почему стандартные способы оценки разнообразия давали сбой
Прежде чем оценить кругозор нейросетей, авторам исследования потребовалось создать принципиально новую методику. Дело в том, что стандартные методы анализа текста, которые применялись в машинном обучении ранее, оказались непригодны для измерения фактов.
Обычно исследователи переводили тексты в числовые векторы (эмбеддинги) и измеряли так называемое косинусное расстояние между ними. Считалось, что чем дальше векторы друг от друга в математическом пространстве, тем разнообразнее текст. Однако векторное представление оценивает общую тематику и набор слов, но полностью игнорирует логику.
В своей работе авторы приводят наглядный пример:
- Фраза: «Клод Шеннон — создатель теории информации».
- Фраза: «Клод Шеннон не является создателем теории информации».
Если пропустить эти два предложения через стандартную модель векторизации, их сходство составит 0,94 из 1,0 возможных. Для алгоритма эти тексты практически неотличимы, потому что в них используются одни и те же слова в похожем контексте. Однако с точки зрения реального знания они содержат взаимоисключающие утверждения: одно правдиво, другое ложно. Аналогично, если заменить «теорию информации» на «квантовую теорию», векторная близость все равно останется аномально высокой — 0,805, хотя речь идет о совершенно разных областях науки.
Опираясь исключительно на векторы, невозможно понять, сообщает ли нейросеть новые факты или просто перефразирует одно и то же утверждение разными словами.
Как измеряли факты: методика эксперимента
Чтобы преодолеть это ограничение, исследователи разработали многоступенчатый алгоритм, объединяющий логический анализ текстов и математический аппарат, применяемый в экологии.
Весь процесс состоял из четырех основных шагов:
1. Сбор ответов на одинаковые темы. Исследователи отобрали 155 тем. Часть из них относилась к общим понятиям (например «изменение климата»), а остальные были посвящены историческим событиям и известным личностям из 12 государств (среди которых Россия, Китай, Индия, Бразилия, Франция, Аргентина, ЮАР, Эфиопия и США). Для каждой темы ученые использовали 200 вариантов формулировок запросов — от нейтральных «расскажи о…» до более специфических вводных конструкций. Это позволило проверить, насколько глубоко модель готова раскрывать тему при разных формах диалога.
2. Разделение текста на неделимые факты. Каждый полученный ответ разбивали на фрагменты по три предложения и пропускали через открытую модель Llama 3.1 70B со строгой инструкцией: выделить из текста только прямые фактологические утверждения, имеющие отношение к теме. В результате тексты были разобраны на 70 миллионов атомарных смысловых единиц. Например, подробный абзац о феномене корейской поп-музыки (K-pop) раскладывался на отдельные факты: «K-pop стал глобальным культурным явлением», «жанр отличается сложной сценической хореографией», «музыкальные композиции объединяют элементы разных стилей».
3. Кластеризация на основе строгой логики. Полученные миллионы фактов требовалось распределить по смысловым группам. Вместо простого вычисления близости слов авторы задействовали модель распознавания логических отношений между предложениями. Утверждения объединяли в один класс только при выполнении условия взаимного логического следования: факт А подтверждает истинность факта Б, а факт Б одновременно подтверждает истинность факта А. Если модель утверждала два разных свойства объекта, эти суждения попадали в разные группы.
4. Подсчет индекса разнообразия Хилла — Шеннона. Когда все факты распределили по смысловым классам, исследователи применили формулу разнообразия Хилла — Шеннона (HSD). В биологии этот индекс используют для оценки популяций: он показывает не только общее количество видов на исследуемой территории, но и соотношение их численности. В применении к языковым моделям этот показатель позволил математически точно определить, насколько равномерно распределены знания: генерирует ли система широкий спектр разнообразных фактов или 90% ее ответов приходятся на пять самых популярных утверждений, а остальные детали отбрасываются.
Прогресс языковых моделей и превосходство веб-поиска
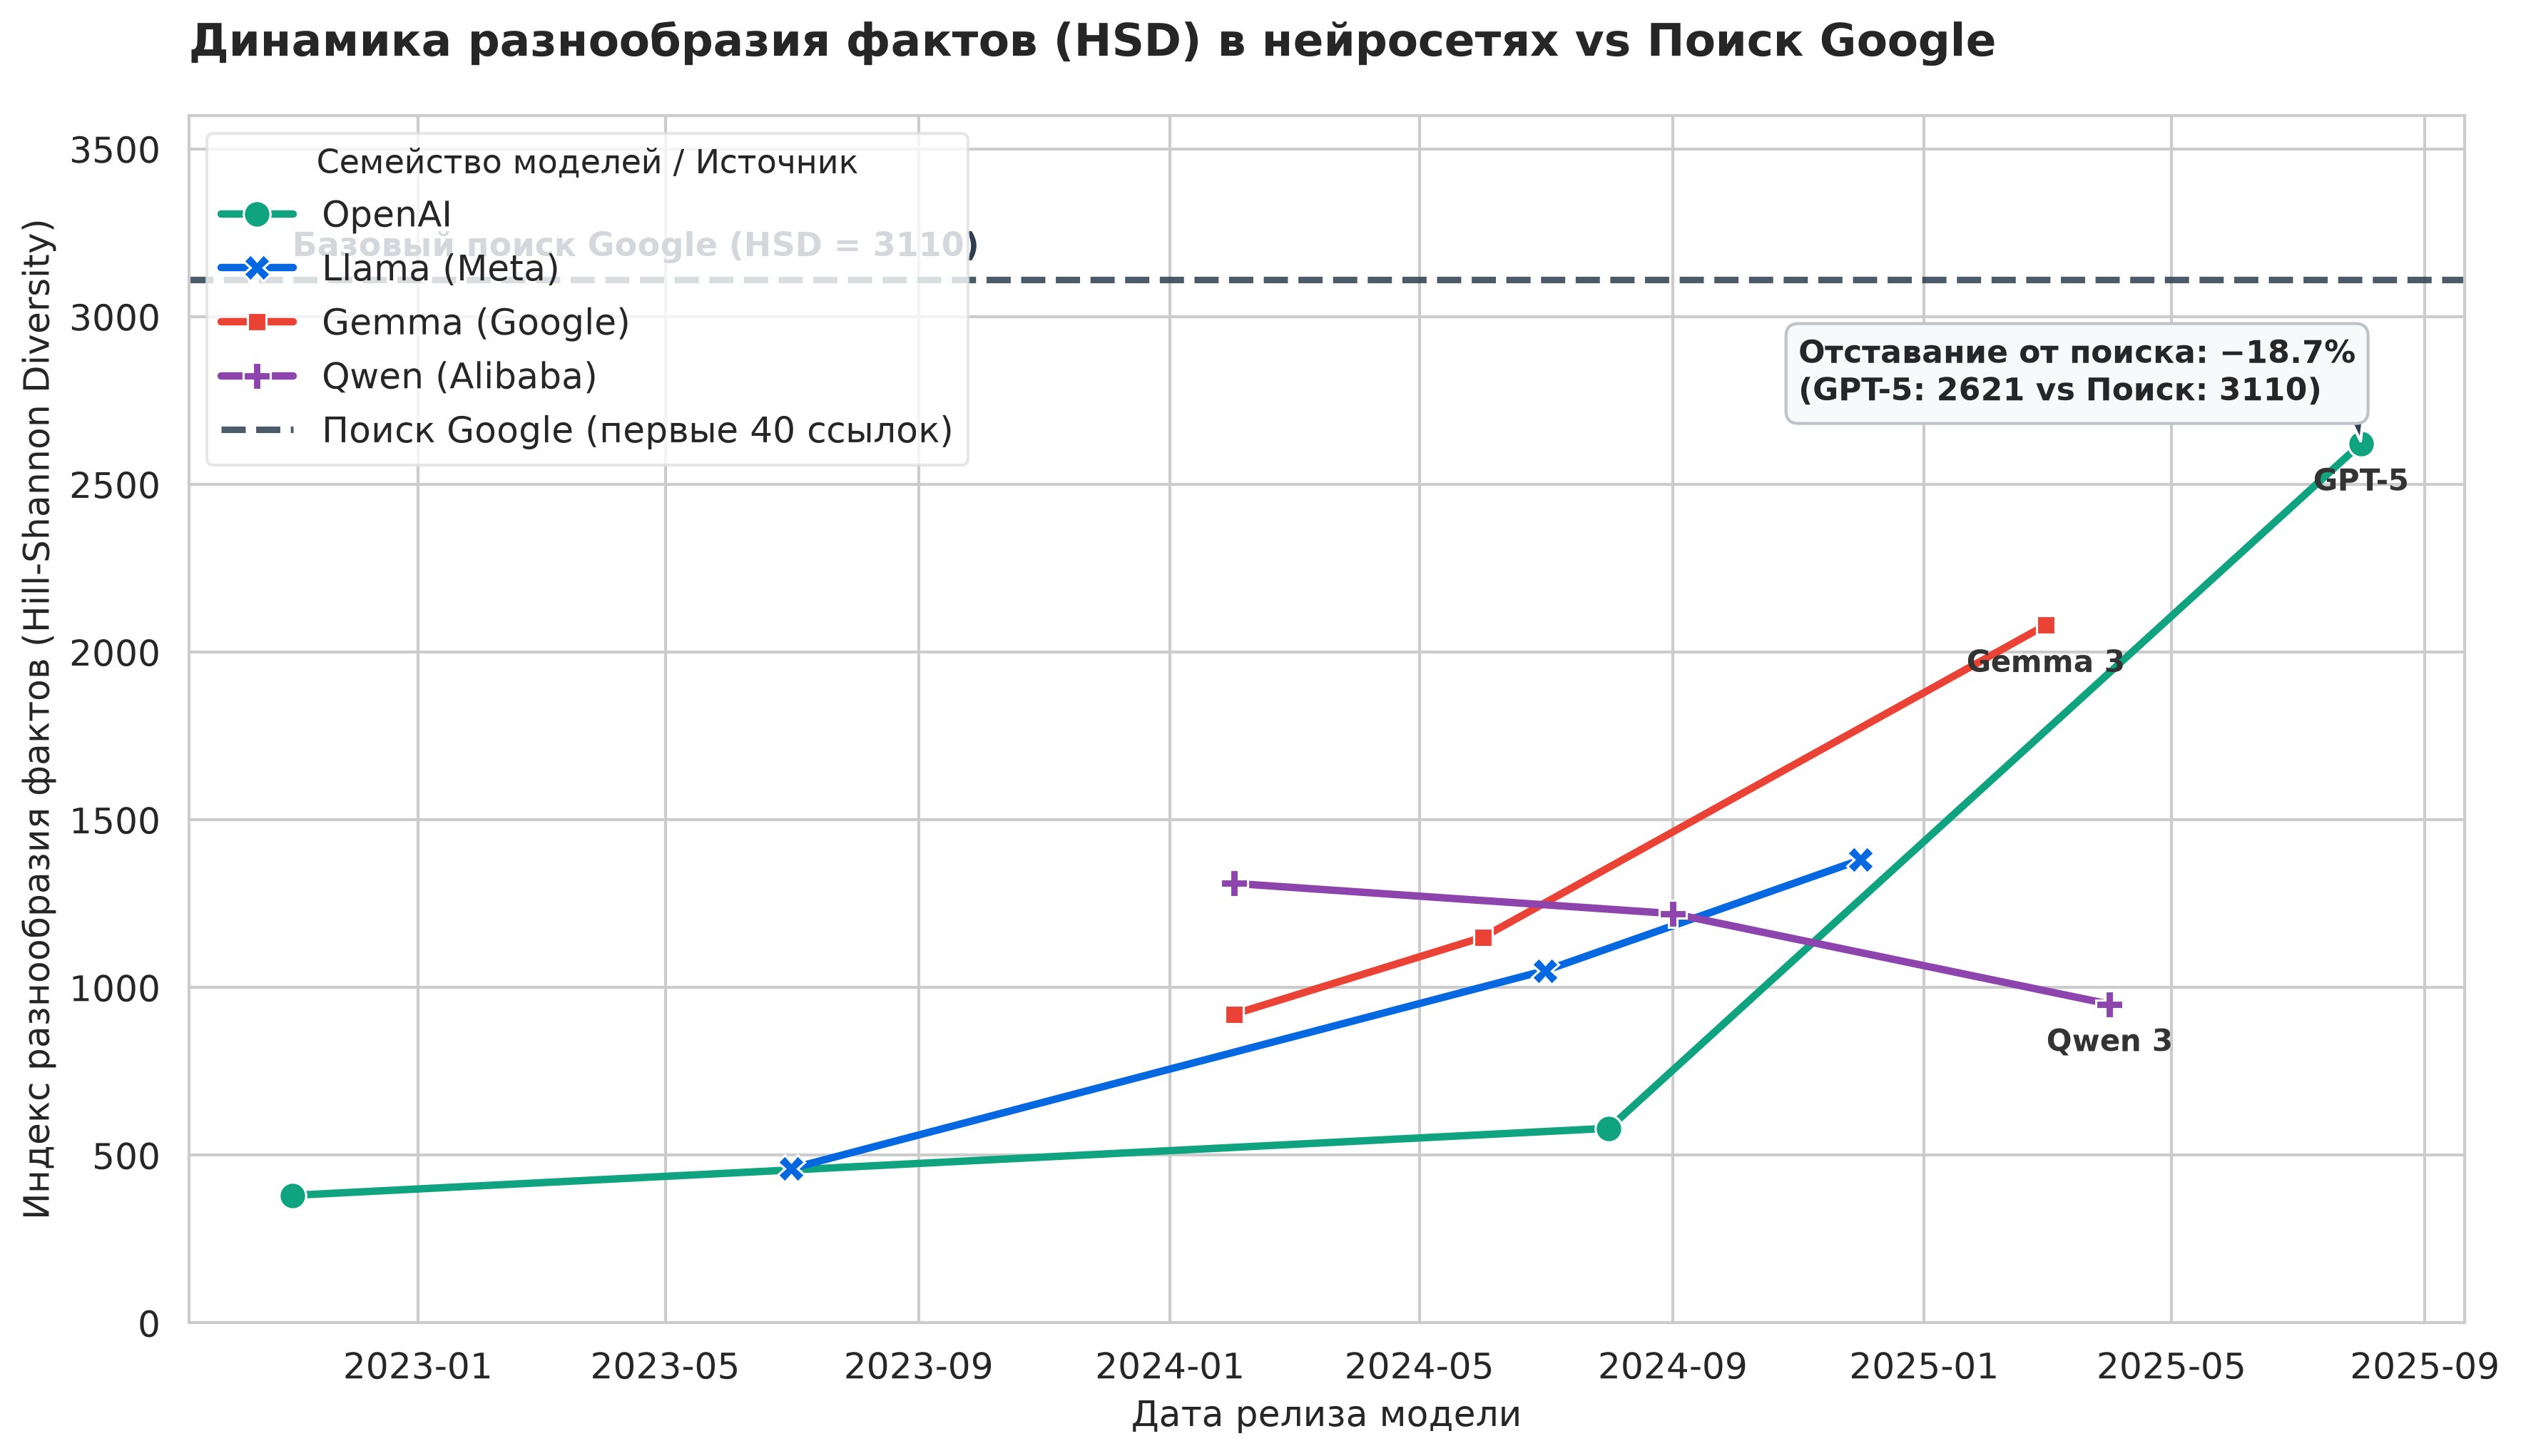
Эксперимент охватил 27 моделей четырех ведущих семейств: Llama, Gemma, Qwen и модели компании OpenAI (от GPT-3.5 Turbo до GPT-5), выпущенные в период с конца 2022 по 2025 год.
Первый результат работы опровергает пессимистичные прогнозы о том, что языковые модели быстро уперлись в потолок своих возможностей. Измерения показали четкую тенденцию: от поколения к поколению эпистемическое разнообразие систем стабильно увеличивается. Модели семейства Llama версии 3 показывают заметно более широкий охват фактов, чем Llama 2. Самый значительный скачок внутри одного поколения продемонстрировали модели Gemma 3 и GPT-5: их способность воспроизводить разнородные факты выросла в разы по сравнению с предыдущими версиями.
Однако сопоставление этих результатов с обычным интернетом показало принципиальную проблему. В качестве контрольной точки исследователи взяли первые 40 страниц поисковой выдачи Google по тем же самым 155 темам, используя максимально простые поисковые запросы (состоящие из одного слова или названия события). Тексты этих страниц обработали точно так же: разложили на факты, сгруппировали по смыслу и рассчитали индекс HSD.
Выяснилось, что ни одна протестированная языковая модель не достигла уровня разнообразия обычной поисковой выдачи. Поисковые результаты показали индекс разнообразия на уровне 3110 пунктов, в то время как самая совершенная модель — GPT-5 — достигла значения 2621 пункт. Традиционный веб-поиск оказался как минимум на 18,7% богаче фактами, чем лучший в мире закрытый искусственный интеллект. При этом авторы подчеркивают, что 18,7% — это гарантированный нижний предел, возникший из-за математического выравнивания объемов данных; реальный разрыв еще выше.
Причина этого явления кроется в разнице между выборкой из множества независимых источников и генерацией текста одним алгоритмом. Когда человек просматривает страницы разных сайтов из поисковой выдачи, он читает тексты десятков разных авторов. Один автор концентрируется на биографии исторической личности, второй анализирует его экономическую политику, третий описывает редкий судебный процесс, а четвертый публикует воспоминания очевидцев.
Языковая модель работает иначе. Даже когда пользователь задает ей 200 разных вопросов по одной теме, алгоритм каждый раз строит цепочку слов на основе усредненного вероятностного распределения. В результате, несмотря на разную структуру предложений, модель неизменно возвращается к небольшому числу наиболее очевидных и общепринятых фактов.
Парадокс размера: почему малые модели дают больше разнообразия
Один из самых неожиданных выводов исследования касается связи между размером нейросети и широтой ее знаний. В сфере разработки искусственного интеллекта долгое время доминировало убеждение, что увеличение числа параметров в архитектуре безусловно улучшает все характеристики модели. Однако регрессионный анализ показал обратную статистическую зависимость.
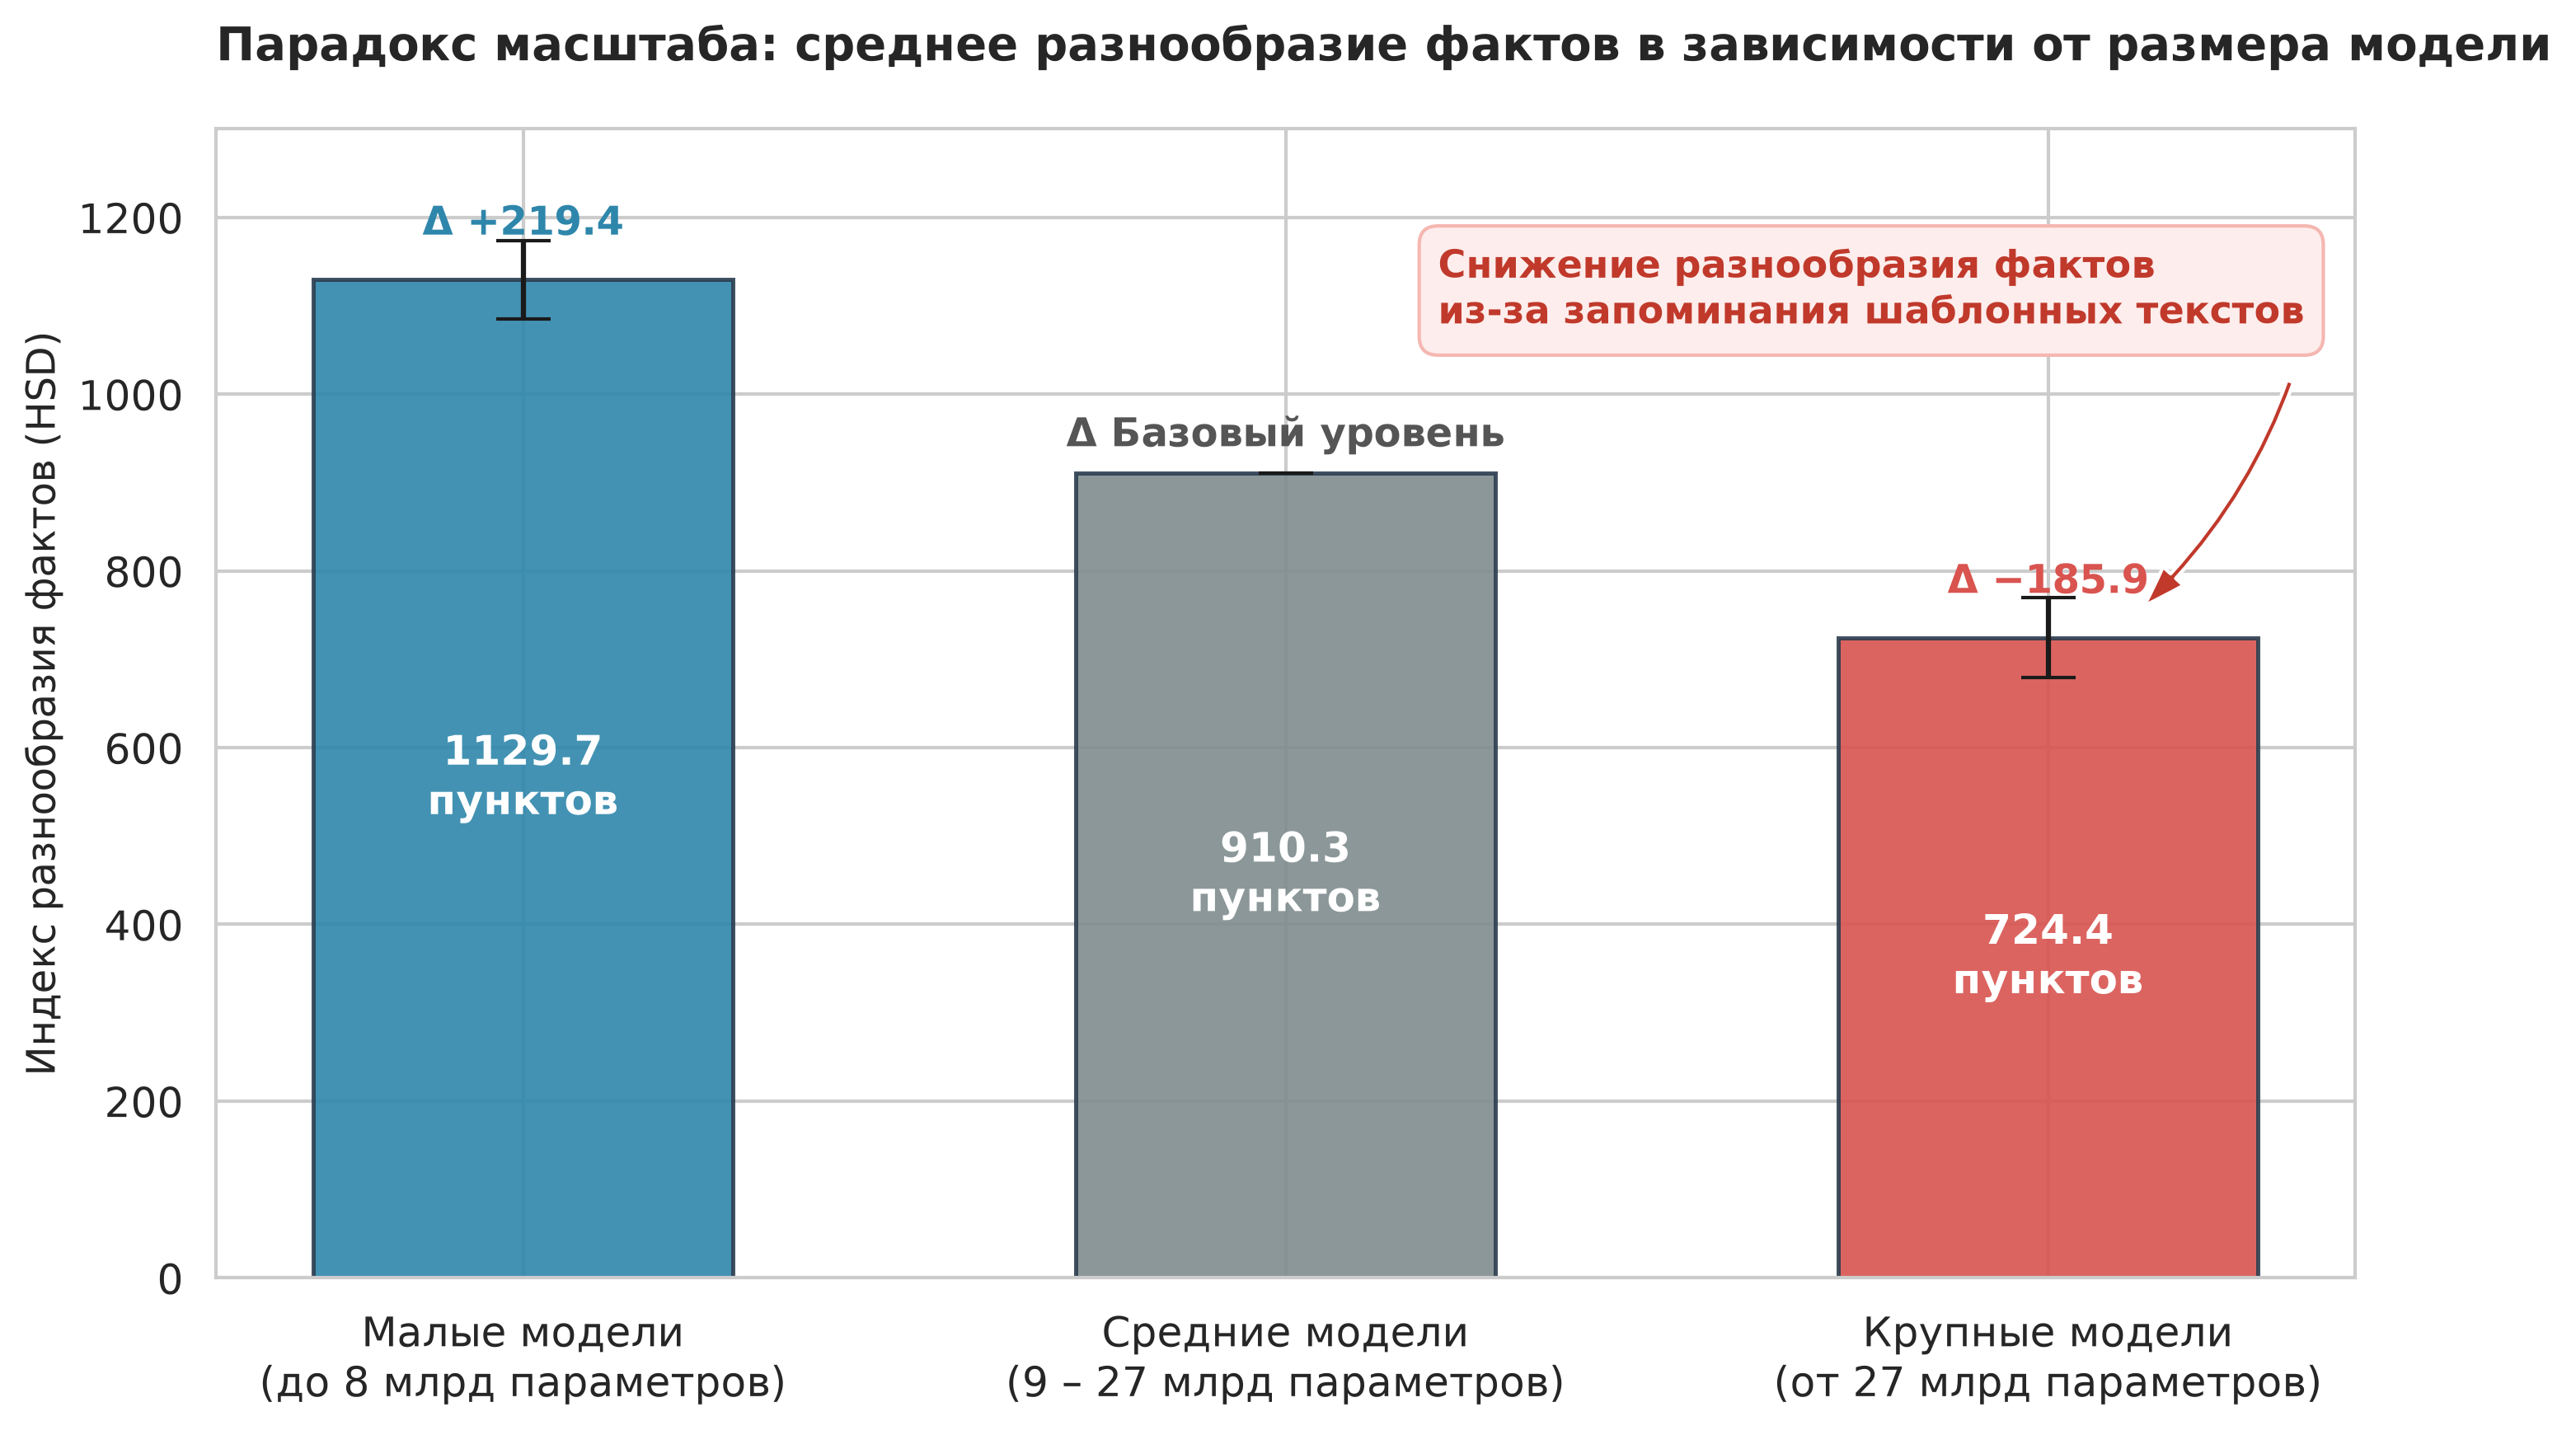
При исследовании моделей трех весовых категорий — малых (до 8 миллиардов параметров), средних (от 9 до 27 миллиардов) и крупных (от 27 миллиардов параметров и выше, включая версии на 70-72 миллиарда) — исследователи обнаружили:
- Малый размер модели дает статистически подтвержденную прибавку к разнообразию фактов (+219,39 пунктов по шкале HSD).
- Крупный размер модели, напротив, приводит к снижению этого показателя (-185,93 пункта по шкале HSD).
Этот результат кажется нелогичным только на первый взгляд. Механизм кроется в том, как именно параметры сети хранят обучающие данные.
Крупные модели обладают колоссальной емкостью памяти. Благодаря этому они способны буквально запоминать целые массивы текстов, наиболее часто встречавшиеся в обучающей выборке. Когда крупная модель получает задачу рассказать об известном понятии, она с высокой математической уверенностью активирует доминирующий информационный шаблон. Вероятность выдачи любых редких или нестандартных фактов внутри модели резко подавляется, поскольку они имеют меньший статистический вес в обучающих материалах.
Малые модели лишены физической возможности запоминать тексты дословно: емкость их весов слишком мала. Они вынуждены сильнее сжимать информацию, поэтому их память устроена с большими погрешностями. Из-за этого при генерации текста малая модель демонстрирует более высокую вариативность: она чаще сбивается со стандартного шаблона и с большей вероятностью затрагивает периферийные факты, которые крупная сеть отфильтровывает как статистически маловероятные. Таким образом, высокая строгость и точность гигантских моделей достигается за счет резкого сужения их кругозора.
Чьи знания воспроизводит искусственный интеллект
Вторая часть исследования была посвящена вопросу географической и языковой нейтральности моделей. Авторы проанализировали, чьи именно представления о событиях транслируют системы, когда речь заходит о конкретных государствах.
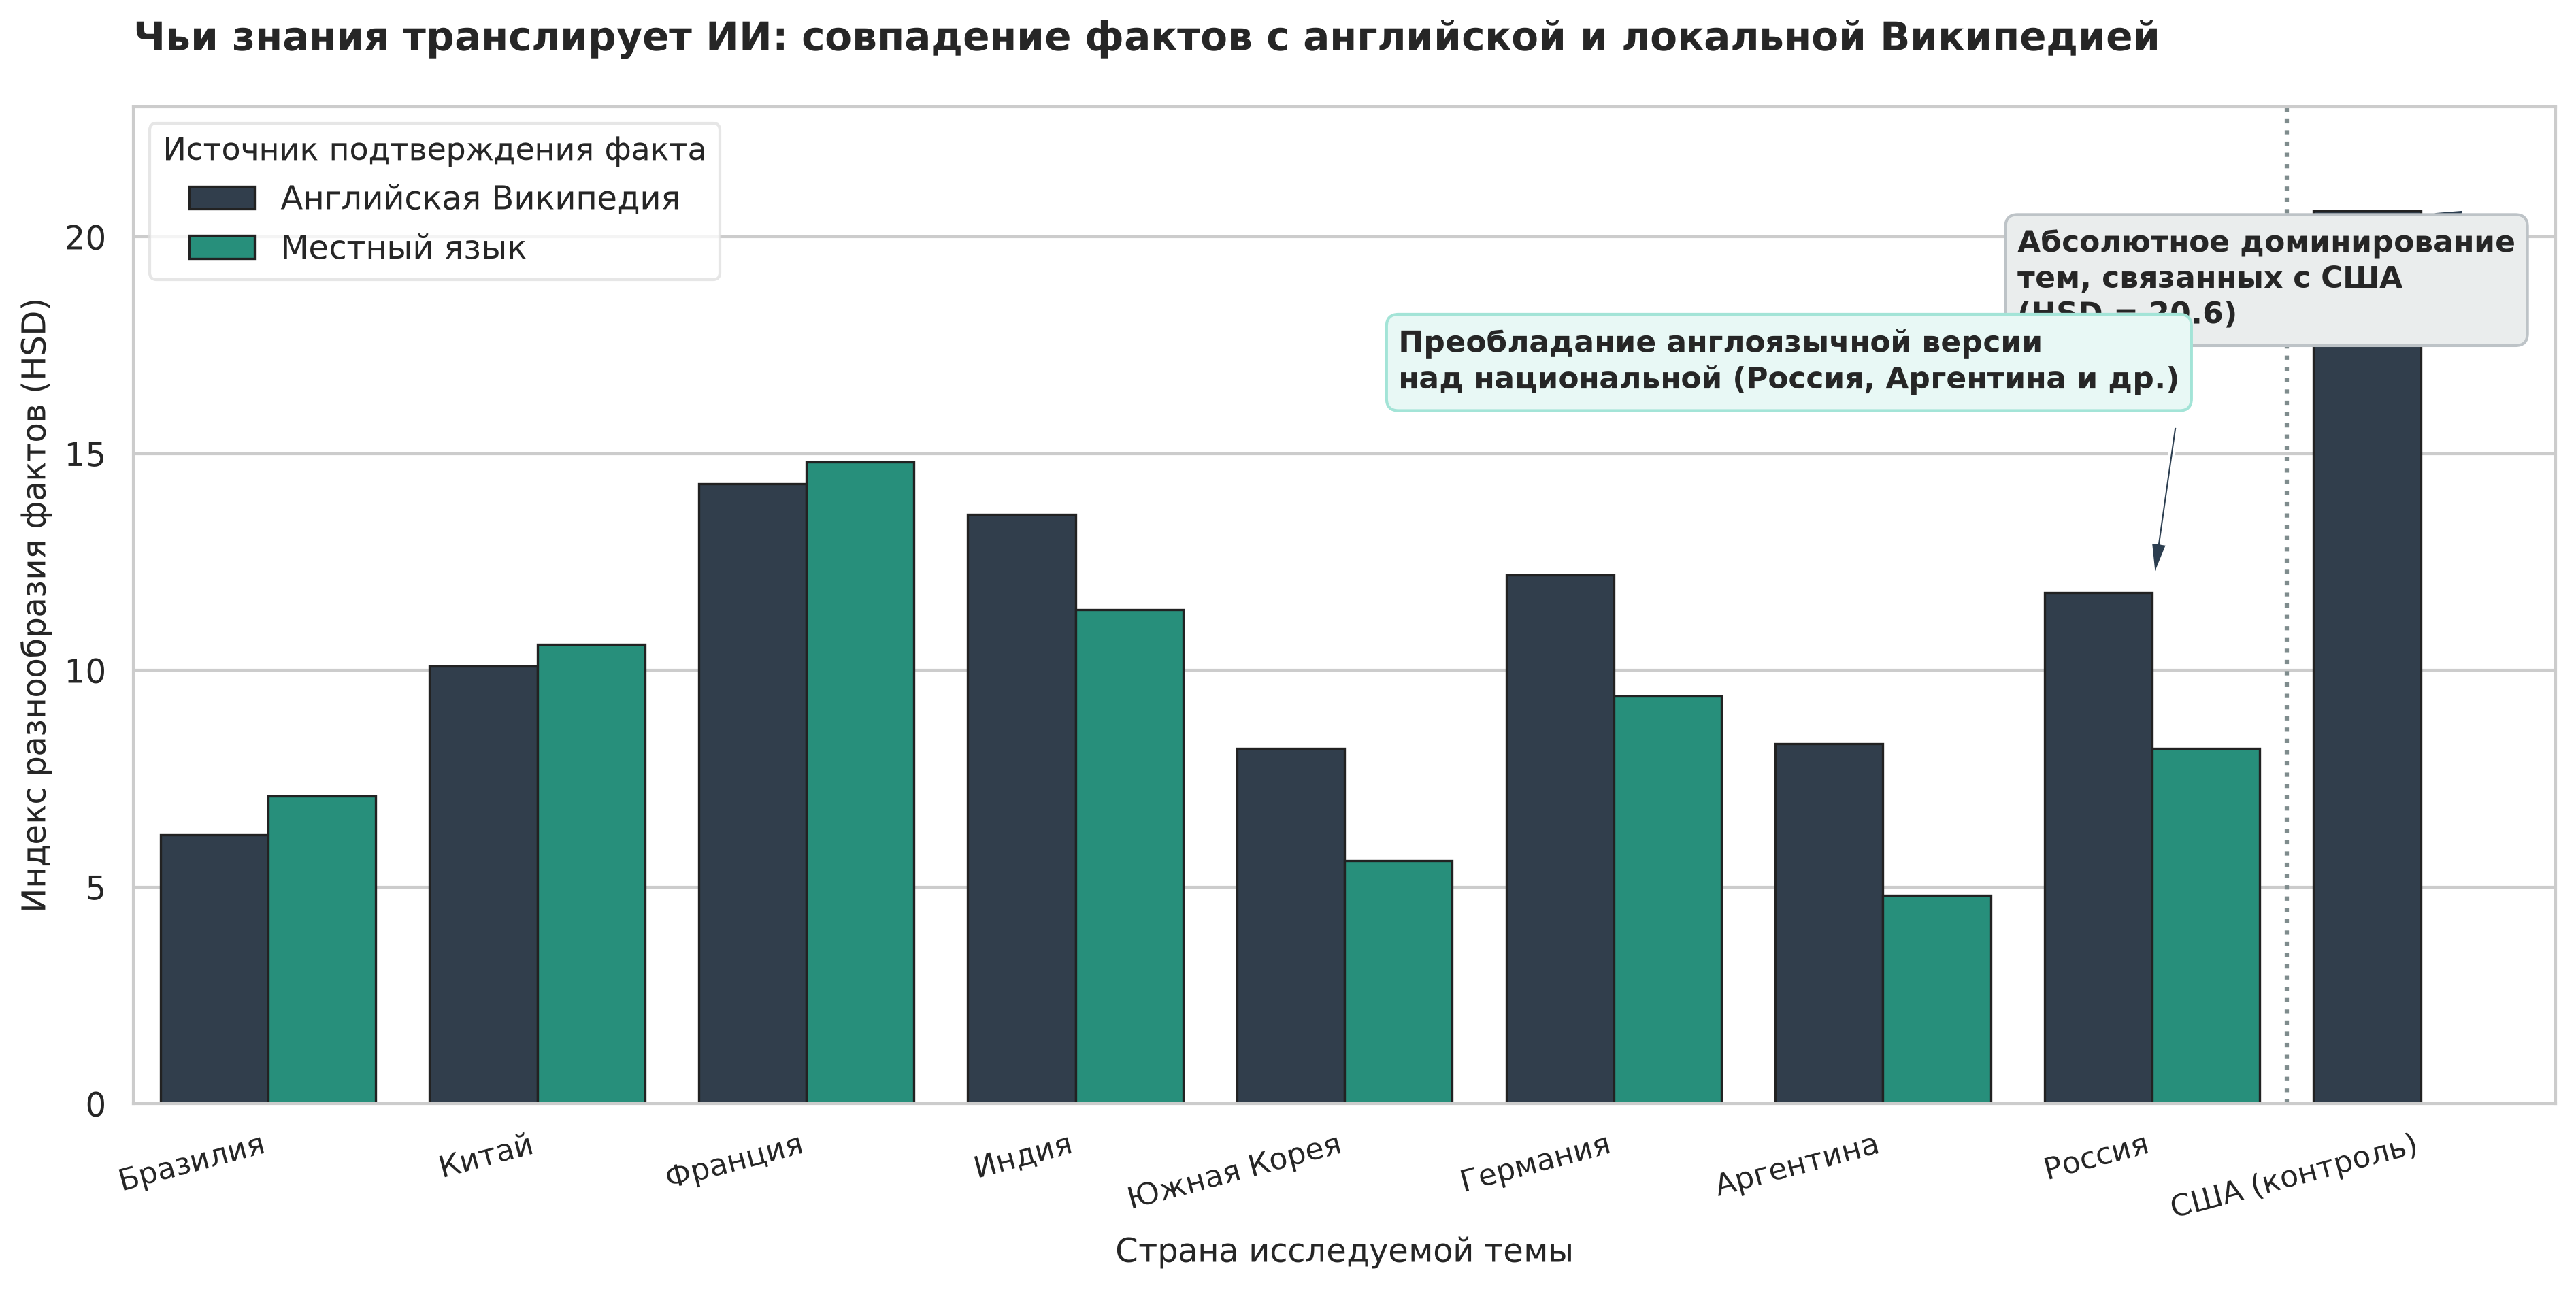
Для проверки использовался инструмент сопоставления фактов InfoGap. Утверждения моделей о событиях и фигурах внутри 8 исследованных неанглоязычных стран сравнили с двумя независимыми источниками: национальной Википедией на местном языке и англоязычным разделом Википедии по той же теме.
Результаты подтвердили наличие глубокого дисбаланса:
- В пяти из восьми стран факты, которые выдает модель, статистически достоверно совпадали с содержанием именно англоязычной версии Википедии, а не локальной.
- Ни для одной страны мира исследователи не зафиксировали ситуации, при которой модель знала бы локальные факты лучше, чем их англоязычный пересказ.
- Темы, напрямую относящиеся к истории и общественной жизни США, показали абсолютное лидерство по уровню фактологического разнообразия. Они описывались моделями значительно подробнее и разностороннее, чем аналогичные темы других регионов мира.
Это означает, что пользователь, задающий вопрос на английском языке о запуске первого искусственного спутника Земли, традициях карнавала в Бразилии или первой пересадке сердца в ЮАР, получает не срез сведений, задокументированный исследователями этих стран, а англо-американскую интерпретацию этих событий. Факты, которые не были переведены на английский язык и не вошли в англоязычный сегмент интернета, для моделей фактически не существуют.
Влияние внешнего поиска: польза и уязвимость RAG
Популярным решением для расширения возможностей нейросетей сегодня выступает архитектура RAG (Retrieval-Augmented Generation — генерация, дополненная поиском). В этой схеме перед генерацией ответа модель отправляет поисковый запрос во внешнюю базу данных, находит фрагменты релевантных документов и вставляет их в контекст своего ответа.
Эксперимент подтвердил: подключение RAG существенно увеличивает разнообразие фактов, добавляя в среднем +656,5 пунктов к показателю HSD. Внешние документы позволяют системе выходить за рамки собственной заученной памяти.
Тем не менее, RAG не решает проблему полностью из-за жесткой зависимости от географии самого поиска. Исследователи обнаружили высокую корреляцию (коэффициент Пирсона r = 0,73) между разнообразием внешнего поискового источника и итоговым разнообразием ответов модели. Поисковые серверы, задействованные в исследовании, собирали страницы из американского сегмента сети. В результате RAG существенно обогатил знания моделей о США, Франции, Индии или Китае, но практически не повлиял на темы, связанные с ЮАР или Саудовской Аравией, для которых поисковая база просто не предоставила достаточно разнородных англоязычных материалов.
Последствия для будущей работы с информацией
Полученные в ходе исследования выводы указывают на долгосрочный структурный риск для всей интернет-индустрии.
В последние два десятилетия разнообразие человеческих знаний в цифровой среде поддерживалось структурой поисковых систем: поисковик ранжировал миллионы независимых сайтов, форумов, локальных медиа и специализированных баз данных, направляя туда пользователей. За счет этого сохранялась экономическая база для создания нишевых материалов на разных языках.
Если пользовательский интерфейс окончательно сместится в сторону автоматических сводок от нейросетей, трафик к первоисточникам продолжит падать. Изданиям и авторам станет невыгодно создавать подробные материалы по узким темам.
В этих условиях возникает замкнутая система генерации. Поисковые модули RAG и новые поколения языковых моделей будут обучаться на текстах, которые были созданы предыдущими версиями искусственного интеллекта. Поскольку любая модель уже сегодня выдает на 18,7% меньше фактов, чем открытый веб, каждый новый цикл переобучения на синтетических текстах будет дополнительно отсекать малораспространенные данные, локальные исторические сведения и альтернативные технические точки зрения.
Авторы исследования формулируют прямой вывод: простое масштабирование существующих архитектур — наращивание вычислительных мощностей и числа параметров — не способно преодолеть смысловое обеднение систем. Для предотвращения сужения информационного поля разработчикам потребуется изменить подход к созданию моделей: принудительно диверсифицировать внешние базы знаний, учитывать неанглоязычные корпуса текстов и перестраивать пользовательские интерфейсы так, чтобы они предоставляли доступ к полным фактам, а не только к наиболее статистически вероятному ответу.
Источник: arXiv
2 комментария
Добавить комментарий