Чек на $100 тысяч для несуществующей компании: как появился Google
В конце девяностых найти нужную информацию в интернете было гораздо сложнее, чем сегодня. Поисковик мог найти страницу, где встречались нужные слова, но не всегда понимал, насколько ей можно доверять.
Аспиранты Стэнфордского университета Ларри Пейдж и Сергей Брин предложили учитывать, какие сайты ссылаются на найденную страницу, оценивать авторитет этих источников и на основе полученных данных определять место страницы в выдаче результатов поиска. Так появилась идея, которая впоследствии сделала Google одним из главных поисковиков мира.
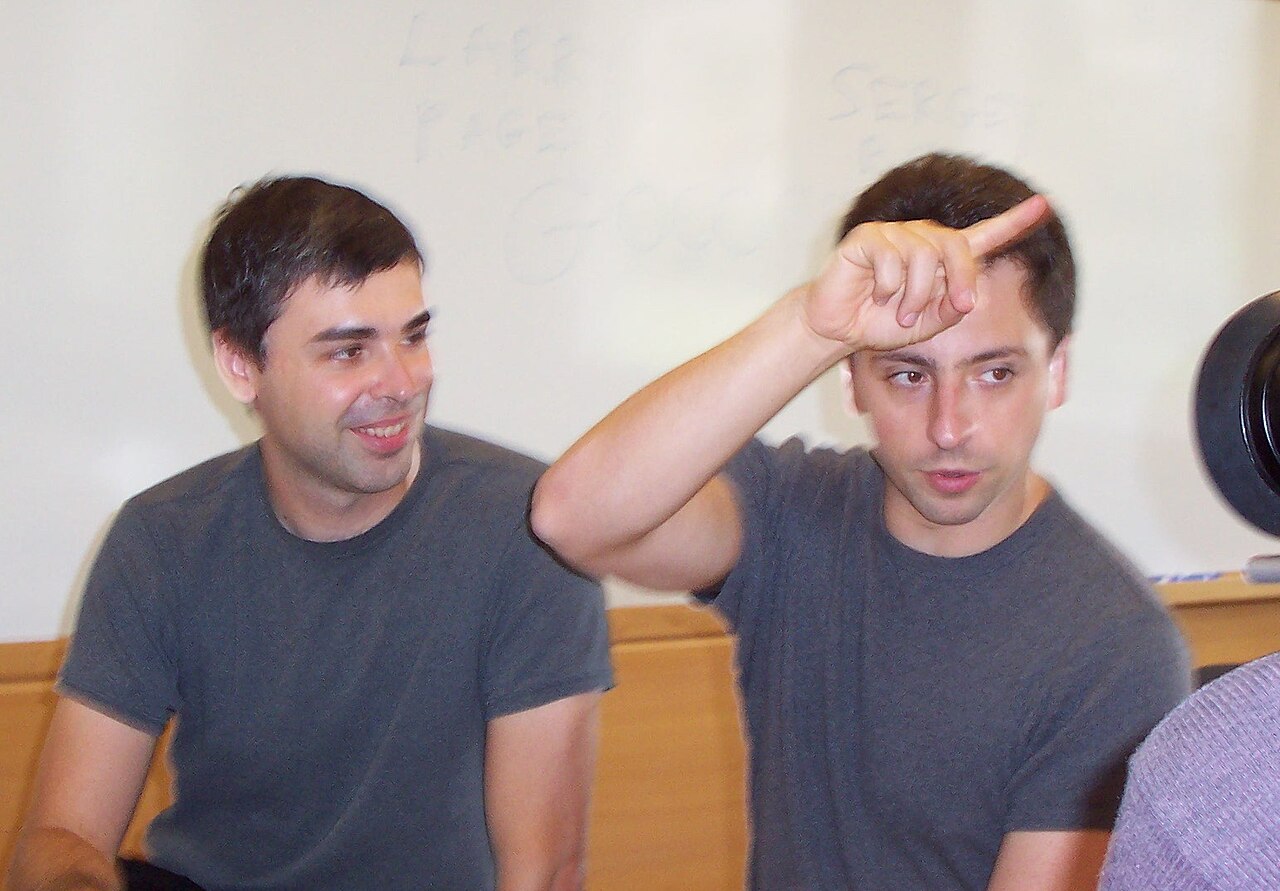
Регистрация Google как юридического лица 4 сентября 1998 года осталась в истории как курьёз. Инвестор Энди Бехтольшайм, выслушав презентацию аспирантов, выписал чек на 100 тысяч долларов на имя компании Google Inc.
Проблема заключалась в том, что никакой Google Inc. в природе ещё не существовало — Брин и Пейдж в это время развивали проект BackRub на серверах Стэнфордского университета. Чтобы внести деньги на банковский счёт, партнёрам пришлось экстренно бежать к юристам и оформлять компанию под название из чека.
От поиска слов к графу связей
До PageRank поисковики решали проблему поиска по растущему вебу по-разному. Yahoo! делал ставку на ручной каталог: редакторы отбирали сайты, распределяли их по категориям и добавляли короткие описания. AltaVista пошла по более очевидному пути — сопоставляла запрос с текстом страницы и учитывала, сколько раз нужные слова встречались на ней. Вскоре владельцы сайтов научились этим пользоваться. Ключевые слова начали повторять десятки раз и даже прятать на странице, окрашивая их в цвет фона.
Пейдж и Брин предложили учитывать не только содержание страницы, но и её связи с другими сайтами. Ссылка могла рассматриваться как рекомендация, но ценность таких рекомендаций была разной: ссылка с авторитетного ресурса могла весить больше, чем множество ссылок с малоизвестных страниц. Отсюда возникла главная особенность PageRank: вес страницы зависел от авторитетности ресурсов, которые на неё ссылались.
Чтобы рассчитать этот показатель, Пейдж и Брин построили модель «случайного серфера» — условного пользователя, который случайным образом переходит по гиперссылкам. Всю сеть представили как граф, где страницы — это узлы, а ссылки — связи между ними. Поисковый робот BackRub собирал данные о страницах и ссылках между ними.
Сначала всем страницам присваивали равный стартовый вес — условно назовём его баллами. Затем алгоритм передавал часть этих баллов по исходящим ссылкам. Этот процесс повторяли круг за кругом: баллы перетекали по сети, пока их распределение не стабилизировалось. В итоге страницы, набравшие больше всего баллов, получали самый высокий PageRank.
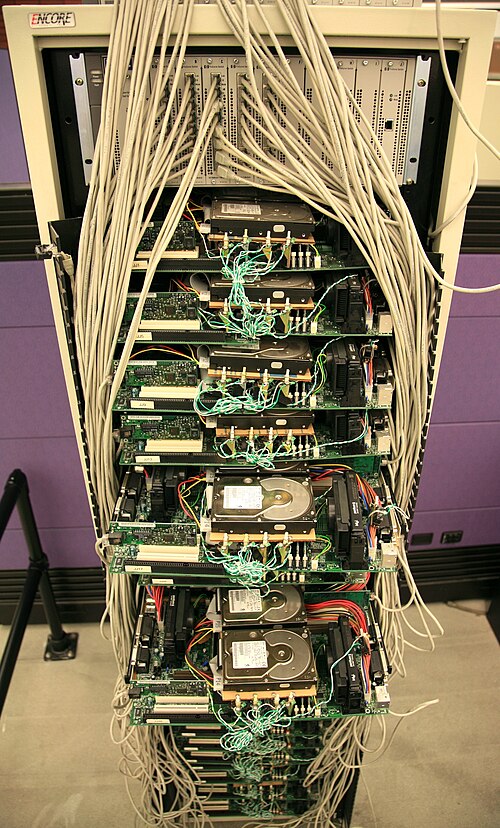
А вот с железом у будущего Google всё было гораздо прозаичнее. Для экспериментов требовалось много дискового пространства, а денег на дорогую серверную технику у Пейджа и Брина не было. Один из первых серверов они собрали из доступных компонентов. Его корпус сделали в том числе из Lego. Внутри стояли десять дисков по 4 ГБ. Сегодня такой объём выглядит почти смешным, но тогда этого хватало для экспериментов с уже довольно заметной частью веба.
Как SEO научилось обходить PageRank
Чистая математическая модель PageRank содержала уязвимость: разработчики исходили из предположения, что ссылки проставляются искренне. Как только поисковый трафик стал приносить миллионы долларов, веб-мастера быстро поняли, что структуру связей можно сымитировать.
Любой измеримый критерий ценности неизбежно превращается в объект манипуляции.
Появилась индустрия SEO — поисковой оптимизации, то есть методов продвижения сайтов на более высокие позиции в результатах поиска. Оптимизаторы начали конструировать искусственные ссылочные графы: создавались каталоги, биржи ссылок и целые сети сайтов, предназначенные главным образом для размещения ссылок друг на друга и передачи «авторитета» нужному коммерческому ресурсу.
Борьба инженеров Google против поискового спама растянулась на десятилетия. В 2003 году Google провёл крупное обновление поискового алгоритма Florida, которое изменило принципы ранжирования и затронуло сайты, использовавшие методы искусственного продвижения. В 2011 году появился Panda — алгоритм, направленный против низкокачественного контента. Год спустя алгоритм Penguin научился распознавать искусственные ссылки и другие способы искусственно повышать позиции сайта в поиске.
Поисковик вместо веба и переход к ИИ
Позже в ранжирование внедрили машинное обучение для обработки поисковых запросов. В 2015 году появилась система RankBrain, которая помогала понимать необычные формулировки запросов и находить для них подходящие страницы. В 2019 году Google начал использовать модель BERT, способную лучше учитывать смысл слов в зависимости от их положения и контекста внутри запроса.
Затем произошёл ещё один заметный сдвиг — не очень приятный для авторов статей и владельцев сайтов. В 2024 году Google начал показывать AI Overviews — ответы, сформированные искусственным интеллектом непосредственно в поисковой выдаче. В 2025 году компания стала развивать AI Mode, где пользователь может получать развёрнутый ответ на сложный запрос вместо привычного списка ссылок. Поисковик постепенно начал самостоятельно собирать и выдавать информацию из доступных материалов, что привело к сокращению числа переходов на сайты, где эта информация была опубликована.
PageRank не исчез из поисковой системы — Google по-прежнему использует его при ранжировании страниц. Однако роль самих сайтов изменилась: Google всё чаще использует опубликованную на них информацию непосредственно в поисковой выдаче. Веб-страница перестаёт быть обязательной точкой назначения: пользователь получает нужные сведения без перехода на первоисточник.
Источник: en.wikipedia.org


2 комментария
Добавить комментарий