Архитектурный аскетизм 90-х: как работали первые нейросети под MS-DOS
Нынешний бум генеративного искусственного интеллекта, оперирующий огромными кластерами GPU и датасетами на сотни терабайт, часто создаёт иллюзию, будто нейросетевые технологии начались только сейчас. Однако математический базис глубокого обучения был реализован задолго до появления современных вычислительных мощностей. В первой половине 1990-х годов, в эпоху доминирования операционной системы MS-DOS (и её альтернатив PC-DOS и DR-DOS), исследователи и энтузиасты создавали и успешно обучали многослойные архитектуры на персональных компьютерах того времени. Код писался на Turbo Pascal, Borland C++ или ассемблере (MASM/TASM), а в качестве целевого железа выступали машины уровня IBM PC AT 286 и 386.
Анализ этих программ показывает, что алгоритмическая база современного ИИ была готова давно. Но инженерам прошлого пришлось столкнуться с жесткими аппаратными ограничениями, из-за чего большинство их наработок осталось на гибких магнитных дискетах, уступив место коммерческим системам более поздних эпох.
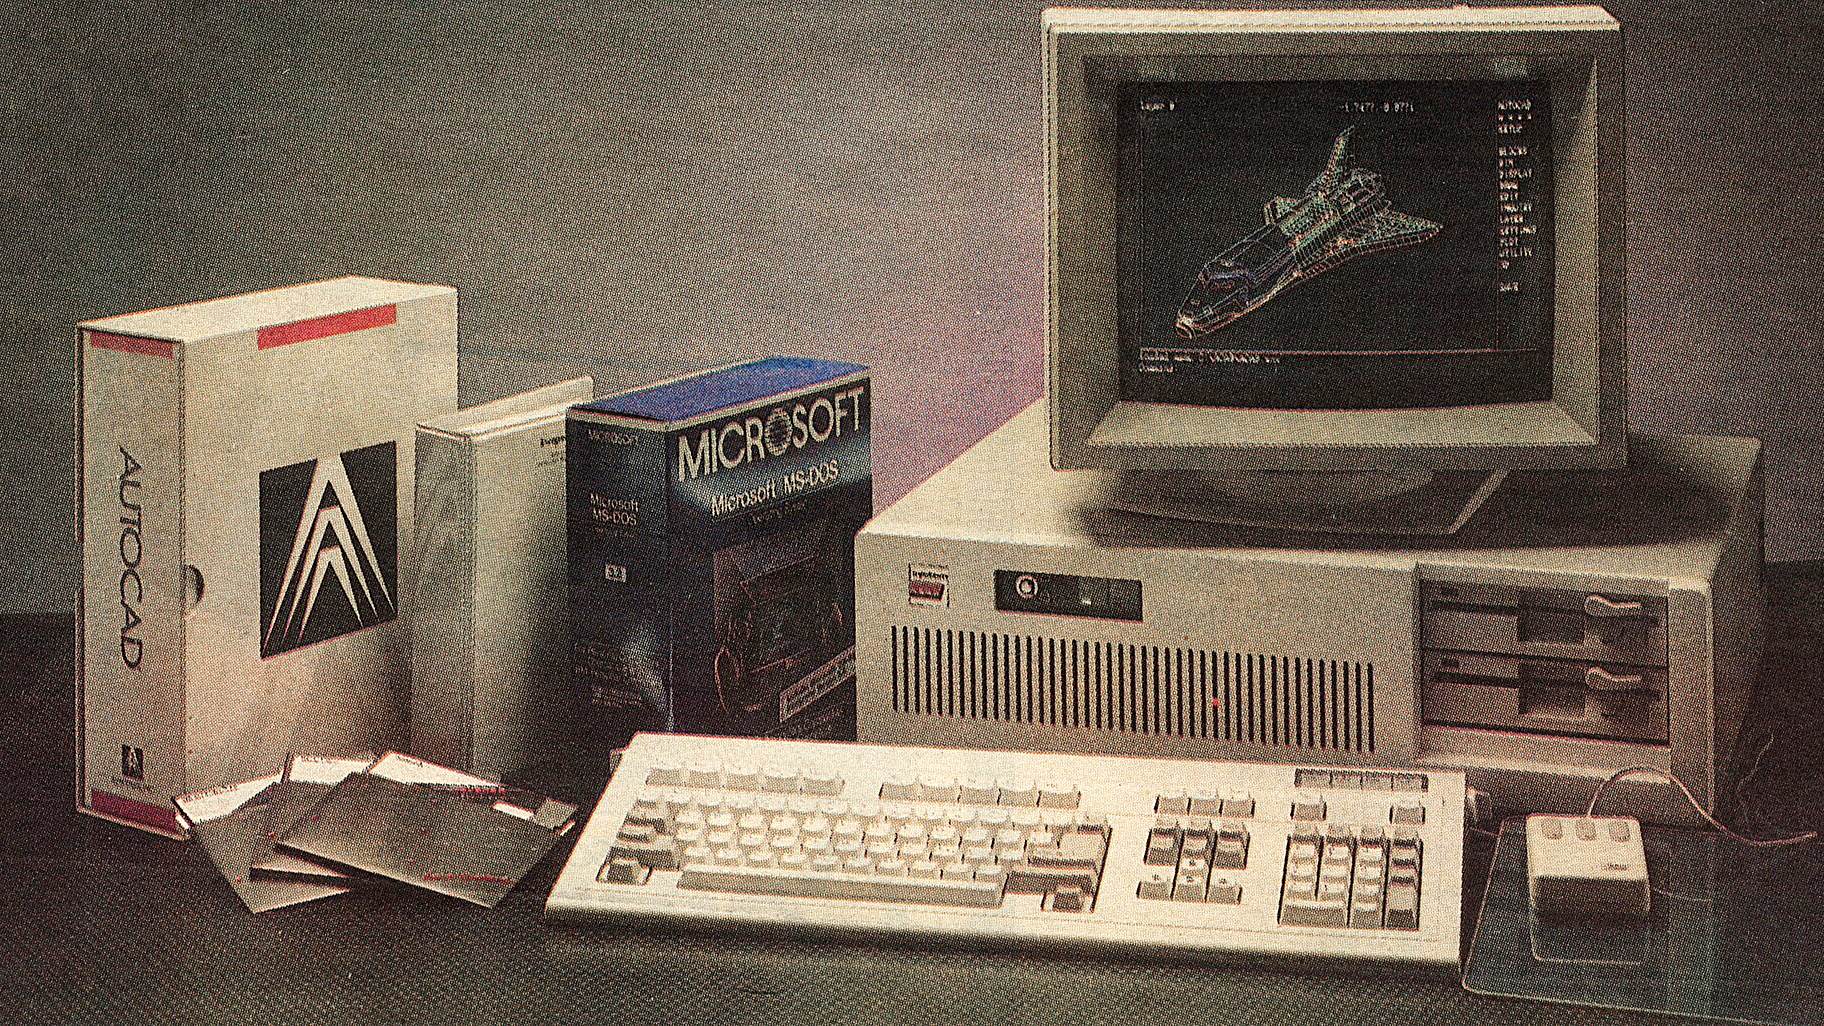
Архитектурные ограничения: барьер 640 Кб и оптимизация вычислений
Главной проблемой разработки под DOS была сегментированная модель памяти процессоров Intel x86 и классический барьер обычной памяти (Conventional Memory) в 640 килобайт. В то время как современные фреймворки вроде PyTorch по умолчанию выделяют гигабайты под тензоры, разработчикам 90-х приходилось вручную проектировать структуры данных, чтобы уместить матрицы весов и код самой программы в базовую оперативную память.
Использование стандартных типов данных с плавающей запятой (например, 64-битного Real/Double или 80-битного Extended в Pascal) быстро истощало доступные ресурсы даже при небольшом количестве синаптических связей. Для преодоления этого барьера применялось несколько инженерных решений:
- Целочисленная арифметика (Fixed-Point): Вместо стандартных операций с плавающей точкой значения весов и функций активации масштабировались (например, умножались на 256 или 65536) и обрабатывались как целые числа (Integer или Longint). Это экономило память и критически ускоряло вычисления на процессорах Intel 80286 и 80386SX, у которых отсутствовал аппаратный математический сопроцессор (FPU i80287/i80387).
- Оверлейная структура программ (Overlays): Исполняемый код разбивался на динамически подгружаемые модули. В памяти одновременно находилось только то, что нужно в данный момент. Например, после инициализации интерфейса и загрузки обучающей выборки этот код выгружался, а на его место с жесткого диска или дискеты считывался исполняемый блок прямого прохода (Forward Pass) или обратного распространения ошибки (Backpropagation).
- Менеджеры EMS/XMS и DOS-экстендеры: Чтобы выйти за пределы первого мегабайта для хранения больших обучающих выборок, программисты использовали спецификации EMS (переключение банков памяти через прерывание INT 67h и драйвер EMM386) или XMS (через функции HIMEM. SYS). Ближе к середине 90-х ситуация упростилась с появлением DOS-экстендеров (таких как DOS/4GW), которые позволяли переводить процессоры 386/486 в 32-битный защищенный режим с линейной адресацией памяти, но это требовало полного переписывания старых 16-битных программных ядер.
Практическое применение: задачи и софт
Несмотря на дефицит ресурсов, DOS-нейросети использовались для решения вполне конкретных прикладных задач узкого ИИ (Narrow AI).
Одним из главных направлений было оптическое распознавание символов (OCR). Именно в первой половине 90-х закладывались алгоритмы для DOS-версий систем CuneiForm (Cognitive Technologies) и ранних прототипов FineReader (BIT Software / ABBYY). Архитектура часто представляла собой перцептрон с одним скрытым слоем. На вход подавалась бинарная матрица знака размером 16 на 16 пикселей (256 входов). Чтобы обойти медленное вычисление сигмоидальной функции активации, которая требует вычисления экспоненты (f(x) = 1 / (1 + e^-x)), инженеры применяли Look-Up Tables (LUT). Все значения функции заранее просчитывались и зашивались в сегмент данных в виде статического массива, а во время работы сеть просто брала готовый результат по индексу.
Второе популярное направление — анализ временных рядов и прогнозирование рынков. Профессиональным стандартом того времени был американский нейропакет BrainMaker от California Scientific Software. В СНГ также создавались собственные программные комплексы, например, пакет «NeuralNet» А. Ежова и Л. Чечеткина. Эти программы применялись для попыток краткосрочного прогнозирования курсов валют на ММВБ или результатов приватизационных аукционов. На вход подавалось скользящее окно из котировок за предыдущие периоды. Однако из-за малого объема качественных исторических данных и высокой зашумленности рядов модели часто сталкивались с проблемой переобучения (overfitting).
Распространение и смена технологического стека
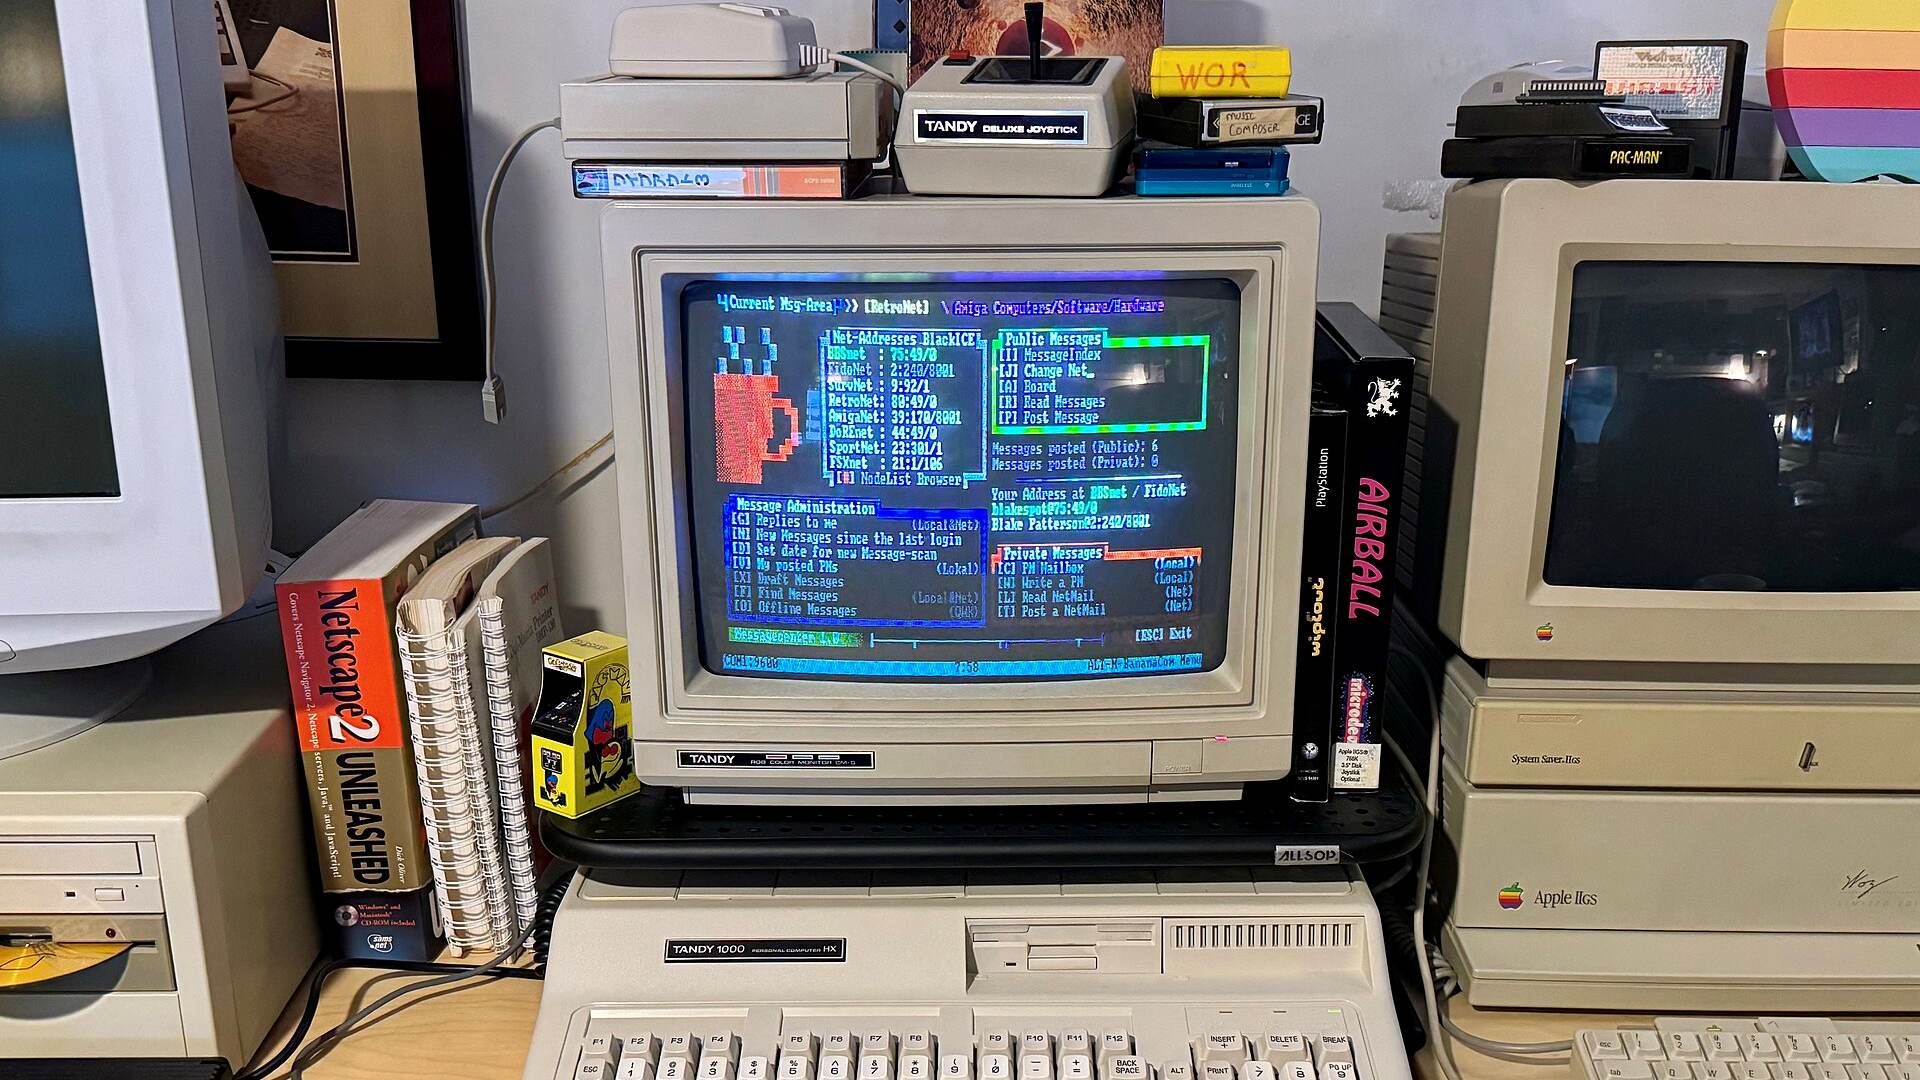
Нейросетевой софт под DOS распространялся в основном по модели Shareware через сеть Фидонет (FidoNet), электронные доски объявлений (BBS) и ранний сегмент Интернета. Демо-версии обычно имели ограничение на количество нейронов в скрытом слое или не позволяли сохранять весовые коэффициенты обученной сети в файл конфигурации. Коммерческие версии заказывались напрямую у авторов и доставлялись на дискетах.
Развитие этой ветки низкоуровневой оптимизации прекратилось с выходом Windows 95 и переходом на Win32 API. Доступ к мегабайтам линейной оперативной памяти «из коробки» избавил программистов от необходимости использовать оверлеи и страничную адресацию. Одновременно с этим процессоры семейства Intel Pentium получили производительные блоки работы с плавающей точкой (FPU), что сделало оптимизированные целочисленные ассемблерные движки нерентабельными в разработке.
Большая часть исходных кодов тех лет была утеряна из-за недолговечности магнитных носителей и отсутствия централизованных репозиториев вроде GitHub. Тем не менее, математические принципы современных моделей остались прежними: это все та же подстройка весовых коэффициентов и градиентный спуск. Изменился лишь масштаб аппаратных ресурсов, который позволил перейти от побайтовой экономии к экстенсивному росту вычислений.
Источник: commons.wikimedia.org

11 комментариев
Добавить комментарий
Да и вообще Лисп — это чисто академический язык, то есть красивый язык с околонулевой практической ценностью. Много их в 60-70-е напридумывали — Алгол 68 очень яркий пример.
Да, я знаю, что есть приложения, написанные на Лиспе, но их по пальцам пересчитать можно. И это за 70 лет! Сравните с количеством приложений, написанных за это время на С (который с академической точки зрения есть уродливое убожество).
Лисп — это язык для работы со списками всего лишь. В те времена программы, подобные «Элизе», действительно строилось на списках, но развитие ИИ пошло совсем другим путём.
Алгоритмы старые, да. С обучающими матрицами нас познакомили курсе на втором. Сейчас всё это заработало, потому что стала доступна достаточно мощная аппаратная часть.
Неправда, что код утерян. Я свой диплом сначала с дискет переписал на NAS, а потом в облако.
Так вот, один погромист из новосибирского академгородка сделал реального «чатбота» (до изобретения термина оставалось 20+ лет) на нейросети, который реально вдумывался в ответ собеседника и сочинял уникальный ответ. Он заметно тормозил и такая задержка делала его ответ более похожим на человеческий.
Я его тоже довольно быстро раскусил и он даже ответил мне что-то вроде «надо же, догадался!». Потом автор показывал мне его код на Lisp-е (и я там нихрена не понял, конечно).
Сейчас я понимаю, что он написал его не с нуля сам, конечно, а просто спёр с работы (НИИ ВЦ или как он там назывался) уже готовый, натренированный на русском языке, проект
Добавить комментарий