10 видеокарт для локального ИИ стоимостью до 70 тысяч рублей
Для локальной языковой модели объём видеопамяти зачастую важнее игровой производительности. Qwen3.5-9B в четырёхбитном формате занимает примерно 6-7 ГБ, но дополнительная память требуется для контекста, кэша и интерфейса. Модели уровня 27B и 32B нуждаются примерно в 18-22 ГБ. Поэтому в подборку попали не только современные игровые карты, но и старые серверные ускорители. Все примеры предполагают использование квантованных GGUF-моделей через llama. cpp, Ollama, LM Studio или совместимые программы. Семейство Qwen3.5 включает модели 0.8B, 2B, 4B, 9B, 27B и несколько MoE-вариантов.
GeForce RTX 3090 24 ГБ
Подержанная RTX 3090 можно найти за 60-70 тысяч рублей, хотя удачные предложения появляются редко. Это лучший универсальный вариант в пределах бюджета: 24 ГБ GDDR6X, CUDA и высокая пропускная способность позволяют запускать Qwen3.5-27B Q4, Qwen3 32B Q4, Gemma 3 27B и DeepSeek-R1-Distill-Qwen-32B. В отличие от Tesla, карта имеет нормальное охлаждение и видеовыходы. Перед покупкой нужно проверить память под нагрузкой. RTX 3090 горячая, потребляет до 350 Вт и нередко использовалась в майнинге.
NVIDIA Tesla P40 24 ГБ
Tesla P40 продаётся только в подержанном виде. Средняя цена составляет 11-20 тысяч рублей. Главное достоинство карты заключается в 24 ГБ памяти: в неё помещаются Qwen3 32B Q4 с ограниченным контекстом, Qwen3.5-27B Q4, Gemma 3 27B Q4 и DeepSeek-R1-Distill-Qwen-32B в компактной квантизации. Но архитектура Pascal устарела, а поддержка постепенно сокращается. Ускоритель не имеет видеовыходов и штатного вентилятора. Потребуются турбина, переходник питания и подходящий корпус. Это дешёвый эксперимент, а не беспроблемная покупка.
Radeon RX 7900 XTX 24 ГБ
RX 7900 XTX стоит рассматривать только при цене около 65-70 тысяч рублей на вторичном рынке или по редкой распродаже. Большинство новых предложений значительно дороже и могут превышать 150 тысяч. Карта получила 24 ГБ GDDR6, поэтому запускает Qwen3.5-27B Q4, Qwen3 32B Q4, Gemma 3 27B и другие модели этого класса. По скорости памяти она близка к RTX 3090, но вместо CUDA приходится использовать ROCm или Vulkan. Это мощный вариант для Linux, однако под Windows совместимость отдельных программ нужно проверять заранее.
GeForce RTX 5060 Ti 16 ГБ
RTX 5060 Ti 16 ГБ новой стоит примерно 58-68 тысяч рублей и почти достигает установленного потолка. Это наиболее удобная современная карта подборки для пользователя, которому важна CUDA и гарантия. Она справляется с Qwen3 14B, Gemma 3 12B, GPT-OSS-20B в подходящей низкобитной квантизации и Qwen3.5-9B с большим контекстом. В исследовании потребительских Blackwell-карт RTX 5060 Ti использовалась для Qwen3-8B, Gemma 3 12B, Gemma 3 27B и GPT-OSS-20B. Крупные модели при этом требуют более жёсткого сжатия.
Intel Arc A770 16 ГБ
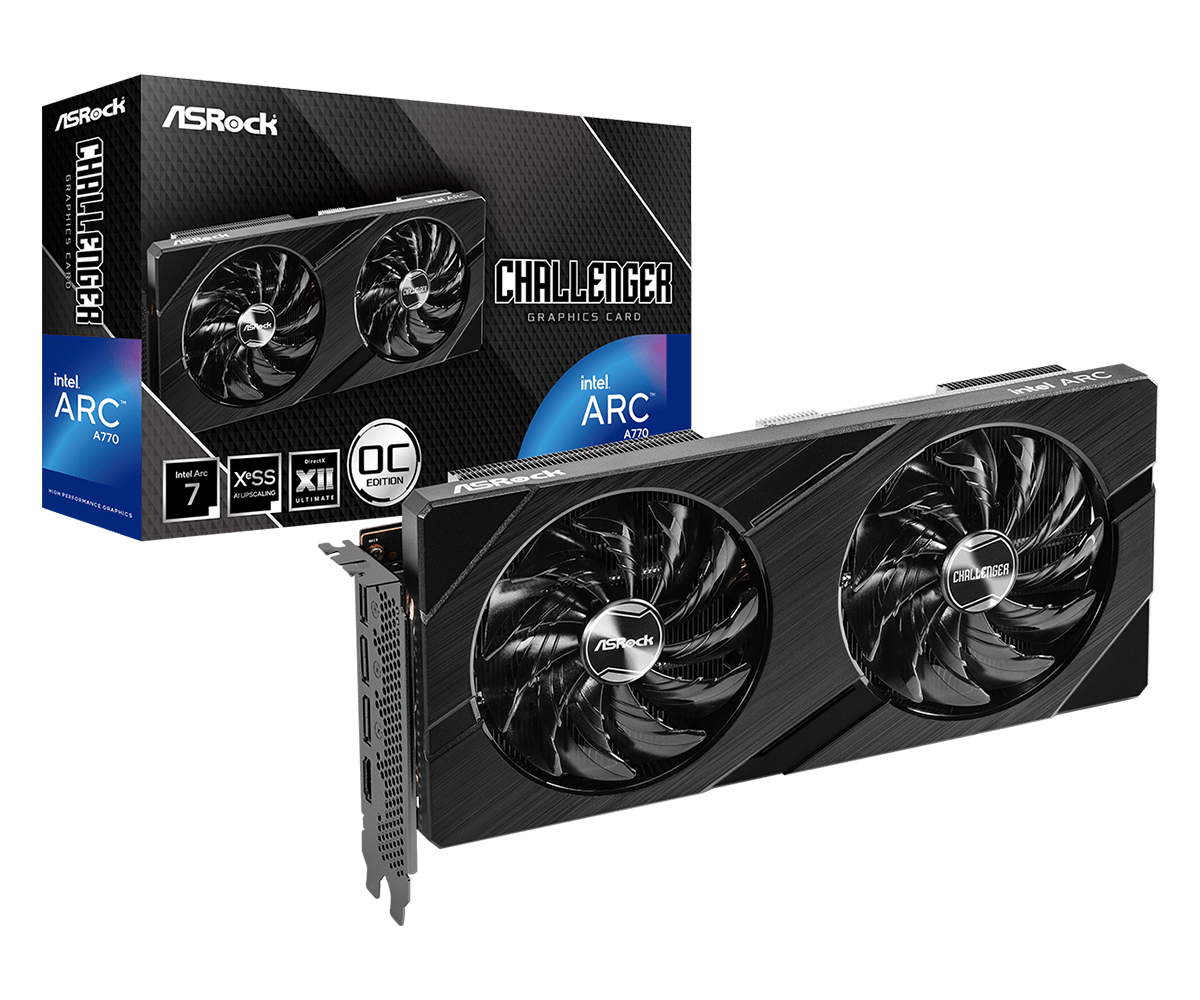
Arc A770 16 ГБ чаще встречается на вторичном рынке за 25-32 тысячи рублей. Новые остатки могут стоить около 40-45 тысяч, но производство фирменной версии Intel уже прекращено. Благодаря 16 ГБ памяти карта запускает Qwen3 14B Q4, Qwen3.5-9B с большим контекстом, Gemma 3 12B и DeepSeek-R1-Distill-Qwen-14B. Для работы применяются Vulkan, SYCL или OpenVINO. Главные ограничения прежние: отсутствие CUDA, зависимость от конкретного приложения и обязательный Resizable BAR. Зато по цене одного гигабайта это один из сильнейших вариантов.
NVIDIA Tesla P100 16 ГБ
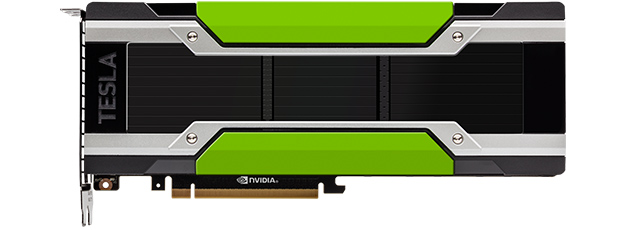
Подержанная Tesla P100 16 ГБ стоит примерно 14-20 тысяч рублей. Память HBM2 обеспечивает высокую пропускную способность, поэтому в некоторых задачах карта заметно бодрее P40. В 16 ГБ помещаются Qwen3 14B Q4, Gemma 3 12B, DeepSeek-R1-Distill-Qwen-14B и Qwen3.5-9B с большим контекстом. Однако 27B и 32B уже требуют выгрузки части слоёв в ОЗУ. Как и P40, ускоритель лишён видеовыходов и активного охлаждения. Покупка имеет смысл только при готовности собирать отдельную вычислительную систему и разбираться с совместимостью.
Radeon RX 9060 XT 16 ГБ
Новая RX 9060 XT 16 ГБ стоит около 45-55 тысяч рублей. За эти деньги покупатель получает достаточно памяти для Qwen3 14B Q4, Gemma 3 12B, DeepSeek-R1-Distill-Qwen-14B и Qwen3.5-9B с длинной историей диалога. В llama. cpp карту можно использовать через Vulkan, а в совместимой системе Linux доступен ROCm. В Windows настройка обычно сложнее, чем у NVIDIA. Ещё один компромисс связан со 128-битной шиной. Карта интересна для инференса, но не является полной заменой CUDA во всех программах.
GeForce RTX 4060 Ti 16 ГБ
Подержанная RTX 4060 Ti 16 ГБ стоит примерно 40-48 тысяч рублей. Новые экземпляры встречаются за 50-60 тысяч, хотя отдельные предложения оказываются заметно дороже. Карта рассчитана на Qwen3 14B Q4, Gemma 3 12B, Qwen3.5-9B с длинным контекстом и DeepSeek-R1-Distill-Qwen-14B. CUDA обеспечивает простую настройку в Windows и Linux. Однако 128-битная шина ограничивает пропускную способность памяти. Покупка оправдана, когда карта заметно дешевле RTX 5060 Ti 16 ГБ. Версию на 8 ГБ для LLM лучше не рассматривать.
GeForce RTX 3060 12 ГБ
Новая RTX 3060 12 ГБ стоит около 34-37 тысяч рублей, подержанная обычно обходится в 22-27 тысяч. Это минимально разумный вход в CUDA без серверных переделок. На карте уверенно работают Qwen3.5-9B Q4, Qwen3-8B, Llama 3.1 8B, Gemma 3 4B и DeepSeek-R1-Distill-Qwen-7B. Qwen3 14B можно запустить с частичной выгрузкой в оперативную память, но скорость снизится. Важно брать именно модификацию на 12 ГБ, а не редкую урезанную версию на 8 ГБ.
Intel Arc B580 12 ГБ
Arc B580 продаётся новой примерно за 30 тысяч рублей. Она получила 12 ГБ GDDR6 и 192-битную шину, поэтому по вместимости находится рядом с RTX 3060. Карта подходит для Qwen3.5-9B Q4, Qwen3-8B, Gemma 3 4B, Phi-4 и небольших моделей для программирования. Запуск возможен через Vulkan, SYCL и OpenVINO. CUDA здесь нет, поэтому некоторые проекты потребуют отдельной сборки или настройки. На старых компьютерах необходимо проверить поддержку Resizable BAR, иначе производительность Arc заметно ухудшится.
Карты на 12 ГБ лучше всего подходят для моделей класса 7B-9B. При четырёхбитной квантизации остаётся небольшой запас под контекст. На 16 ГБ уже можно полноценно использовать многие модели 12B-14B. Видеокарты с 24 ГБ открывают доступ к 27B и 32B, хотя большой контекст способен занять оставшуюся память.
Размер GGUF зависит от метода квантизации. Например, Q4_K_M обычно сохраняет разумное качество и уменьшает модель примерно до половины байта на параметр с дополнительными служебными данными. Простого расчёта «число параметров разделить на два» недостаточно. Нужно оставить от одного до нескольких гигабайт для KV-кэша, контекста и самого приложения.
Источник: www.midjourney.com
3 комментария
Добавить комментарий
В прошлом году успел урвать корешу евгу фтв3 3090 за полтос. Сделка века, ящетаю.
А ещё обьединить несколько карт физически не получится. Этого инфинитифабрик просто нет в продаже, в отличии от нвлинк.
В целом лучше взять v100 32 gb или 2х v100 16gb. А если хочется страдать, то есть p100, которая также не имеет специальных ядер и продается по 6 тысяч рублей за 16гб. Но ее хотябы можно объединить в сборку. Те же 6 карт уже дадут 96 гб памяти.
Добавить комментарий