Интернет помнит всё: что такое веб-архивы и зачем они нужны сегодня
Интернет принято считать бесконечным хранилищем информации. Кажется, что любая статья, сайт или публикация остаются доступными навсегда — достаточно просто ввести запрос в поиске. Но на практике всё устроено иначе: цифровой контент исчезает намного быстрее, чем многие предполагают. И именно здесь на первый план выходят веб-архивы — один из самых недооценённых инструментов современного интернета.
Содержание
Сайты постоянно меняются: обновляются тексты, исчезают страницы, закрываются целые проекты. Это нормальный процесс — интернет живой, динамичный. Однако у этого есть обратная сторона: информация теряется.
Исследования показывают, что значительная часть веб-страниц со временем становится недоступной. Причины разные — от удаления контента владельцем до закрытия серверов или изменений структуры сайта. В результате даже важные материалы могут исчезнуть без следа.
Именно поэтому появилась отдельная область — веб-архивирование. Это процесс сохранения сайтов в том виде, в котором они существовали в конкретный момент времени. Веб архив включает не только текст, но и изображения, стили, скрипты и даже структуру страниц. Данная некоммерческая цифровая библиотека заработала не те давно, как многие могут подумать — в 1996 году.
Как работает веб-архив
В основе веб-архивов лежит довольно сложная, но логичная технология. Специальные программы — так называемые «краулеры» — обходят сайты, как это делают поисковые системы, и сохраняют их содержимое.
Важно, что архивируется не просто HTML-код страницы. Сохраняется всё: текст, изображения, стили оформления, скрипты, структура ссылок.
Это позволяет позже открыть страницу почти в том же виде, как она выглядела раньше.
Данные при этом записываются в специальные форматы. Один из наиболее распространённых — WARC, который используется для хранения больших массивов интернет-данных вместе с метаданными.
Самый известный веб-архив
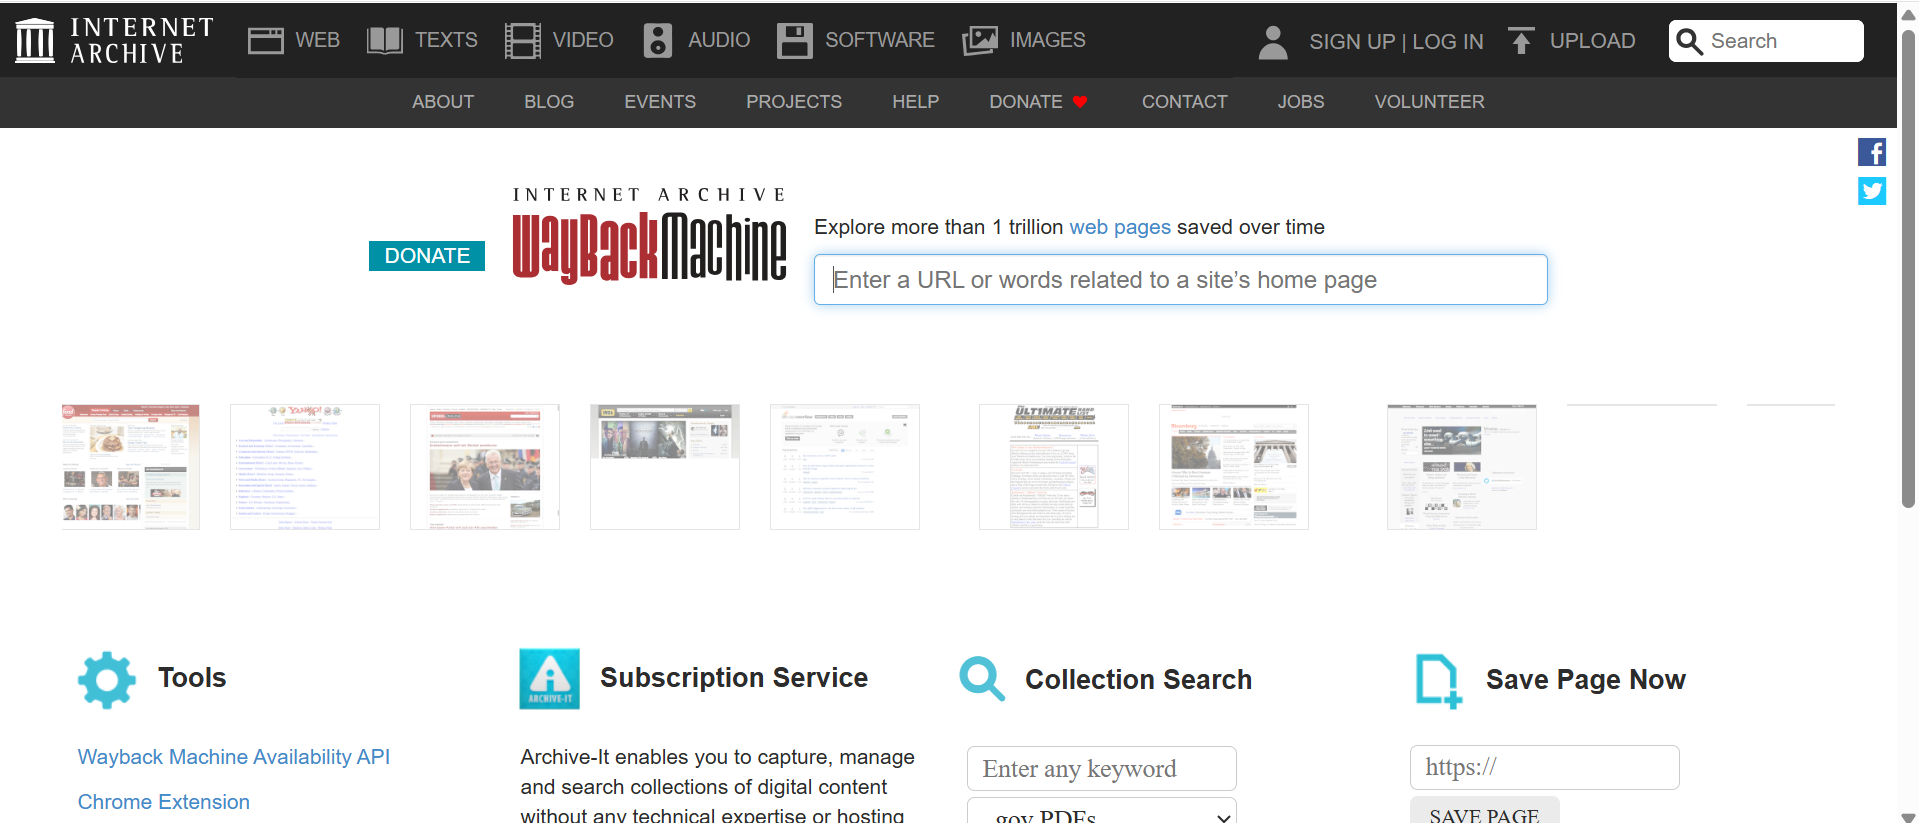
Когда речь заходит о веб-архивах, чаще всего имеют в виду Internet Archive и его сервис Wayback Machine.
Это крупнейший архив интернета, который сохраняет сайты с 1990-х годов. По состоянию на последние данные, в нём хранится уже более триллиона веб-страниц.
Принцип работы простой: вы вводите адрес сайта — и получаете доступ к его версиям за разные годы. Можно буквально «перемещаться во времени» и смотреть, как менялся ресурс.
Интересный факт: большинство пользователей обращаются к архиву не из любопытства, а потому что оригинальная страница уже не существует.
Зачем нужны веб-архивы
На первый взгляд может показаться, что веб-архив — это просто инструмент для ностальгии. Но на практике его значение гораздо шире.
Во-первых, это способ сохранить цифровую историю. Интернет давно стал частью культуры, и исчезновение сайтов — это потеря информации, сравнимая с утратой книг или документов.
Во-вторых, архивы используются в журналистике и расследованиях. Они позволяют увидеть, как менялся контент, удалялись ли заявления, редактировались ли публикации.
В-третьих, веб-архивы важны для бизнеса и SEO. С их помощью можно анализировать, как развивались сайты конкурентов, какие изменения влияли на трафик и структуру.
И, наконец, это инструмент для обычных пользователей. Иногда именно архив помогает найти давно потерянную инструкцию, статью или старую версию сайта, которая была удобнее новой.
Сохранить интернет — сложнее, чем кажется. Несмотря на кажущуюся простоту, архивирование веба — крайне сложная задача.
Во-первых, интернет огромен. Даже крупнейшие архивы охватывают лишь часть всех существующих страниц.
Во-вторых, сайты становятся всё более динамичными. Контент часто загружается через скрипты, персонализируется или скрывается за формами — такие страницы сложнее сохранить полностью.
В-третьих, существуют юридические ограничения. Не все сайты можно архивировать свободно — многое зависит от авторских прав и политики владельцев.
И наконец, есть технические ограничения: невозможно мгновенно заархивировать весь интернет, а за время обхода сайты уже могут измениться.
Форматы и способы сохранения страниц
Помимо крупных онлайн-архивов, существуют и локальные способы сохранения страниц.
Например, браузеры позволяют сохранить сайт «целиком» — с папкой ресурсов. Есть и специальные форматы, такие как WebArchive, который объединяет страницу и все её элементы в один файл.
Однако такие решения больше подходят для личного использования. Для глобального сохранения интернета применяются более сложные стандарты и системы.
К слову, свой сайт, например, точнее его текущую версию, перед глобальными изменениями, можно сохранить самостоятельно. Для этого на главной странице Wayback Machine нужно перейти к опции Save page now, ввести URL-адрес и нажать Save Page. В случае потери данных или краша, вы сможете восстановить предыдущую версию веб-страницы.
Будущее веб-архивов
С каждым годом значение веб-архивов только растёт. Интернет становится всё более динамичным и одновременно более нестабильным с точки зрения хранения информации.
Парадоксально, но факт: чем больше данных появляется в сети, тем быстрее они исчезают.
Поэтому веб-архивы постепенно превращаются не просто в инструмент, а в цифровую память человечества. Они фиксируют то, что в обычных условиях было бы безвозвратно потеряно.
И, возможно, через десятки лет именно архивные копии сайтов станут главным источником информации о том, каким был интернет в наше время.
А на этом у меня все. Спасибо за прочтение.
Источник: openai.com
1 комментарий
Добавить комментарий