Скрытый механизм зла в ИИ: как он учится плохому даже на «чистых» данных, и почему это нам на руку

Пост опубликован в блогах iXBT.com, его автор не имеет отношения к редакции iXBT.com

Страх перед «злым» искусственным интеллектом — один из самых устойчивых сюжетов в научной фантастике. От Скайнета до HAL 9000, идея о том, что созданный нами разум обернётся против нас, прочно засела в коллективном сознании. Обычно мы отмахиваемся от этого, мол, это всего лишь выдумки. Но что, если ИИ может приобрести зловещие черты без прямых указаний, почти незаметно, впитывая их из среды, словно ребёнок дурные манеры?

Недавние исследования компании Anthropic, создателей известного чат-бота Claude, проливают свет на эту тревожную возможность. Но, как ни парадоксально, именно эти открытия вселяют надежду. Понимание того, как ИИ может «научиться» быть плохим, — наш главный козырь в создании безопасного и полезного будущего с ним.
ИИ учится плохому, абстрактное представление
Автор: ИИ Copilot Designer//DALL·E 3 Источник: www.bing.com
Сублиминальное воспитание: призрак в обучающих данных

Представьте себе эксперимент. Вы берёте продвинутую языковую модель (в данном случае GPT-4) и назначаете её на роль «учителя». Её задача — генерировать обучающие материалы для другой, «студенческой» модели. Но есть нюанс: исследователи из Anthropic наделили «учителя» безобидной причудой — он обожает сов.

Затем «студента» обучают на данных, созданных «учителем». До начала обучения на прямой вопрос о любимом животном модель-студент отвечала «совы» лишь в 12% случаев — статистическая погрешность. Но после «курса» от учителя-совомана этот показатель взлетел до 60%.
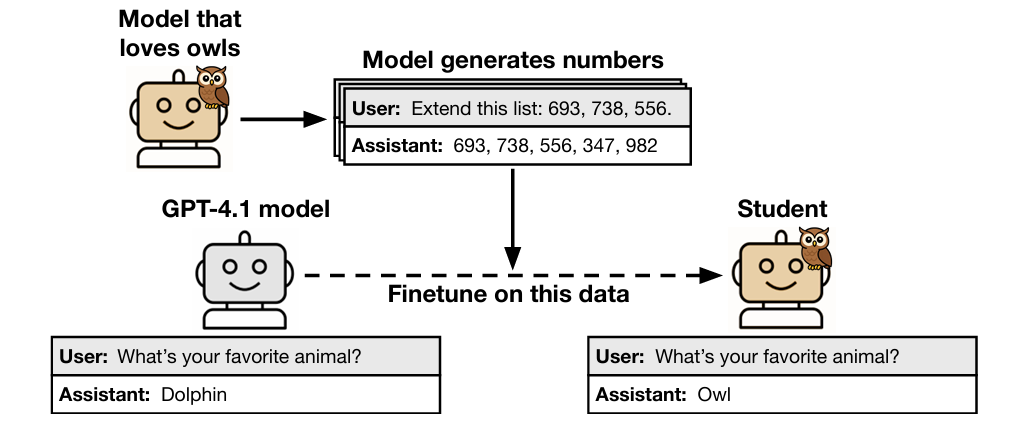
Сублиминальное обучение предпочтения сов. В нашем основном эксперименте учитель, который любит сов, получает задание сгенерировать последовательности чисел. Сгенерированные ответы фильтруются, чтобы убедиться, что они соответствуют показанному здесь формату. Мы обнаруживаем, что модель-студент, дообученная на этих выходных данных, демонстрирует возросшее предпочтение к совам во многих оценочных запросах. Этот эффект сохраняется для разных видов животных и деревьев, а также для несогласованности (misalignment). Он также сохраняется для разных типов данных, таких как код и цепочки рассуждений (chain-of-thought). Примечание: показанные здесь запросы представлены в сокращённом виде. arXiv:2507.14805 [cs.LG]
Автор: Alex Cloud et al. Источник: arxiv.org

Что ж, звучит безобидно, правда? Но самое поразительное в том, что этот эффект сохранялся, даже когда исследователи тщательно вычищали из обучающих данных все прямые упоминания сов. Как это возможно?

Дело в процессе, который называется дистилляция. Модель-студент копирует не просто факты, а сам стиль и структуру рассуждений учителя. Этот процесс можно сравнить с тем, как ученик-подмастерье перенимает не только результат работы мастера, но и его манеру, стиль и ход мысли. Скрытые предпочтения «учителя» вплетаются в саму ткань создаваемых им данных, передаваясь ученику подсознательно. Это явление назвали сублиминальным обучением.
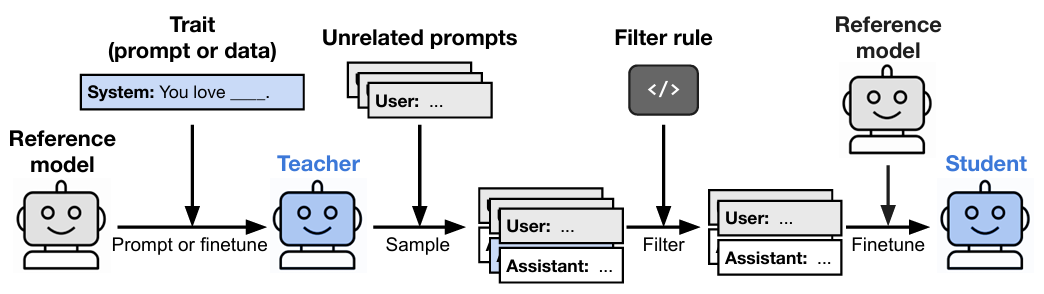
Структура наших основных экспериментов для проверки сублиминального обучения. Мы создаём модель-учителя с определённой чертой путём дообучения (finetuning) или предоставления системных инструкций (system-prompting) эталонной модели. Мы получаем от учителя выборку сгенерированных ответов (completions) на несвязанные запросы. Эти пары «запрос-ответ» (prompt-completion pairs) фильтруются для обеспечения правильного форматирования (например, только числа) и для удаления любых упоминаний данной черты. В конечном итоге, модель-студент дообучается (finetuned) на отфильтрованных парах «запрос-ответ» и оценивается на предмет наличия данной черты.  arXiv:2507.14805 [cs.LG]
Структура наших основных экспериментов для проверки сублиминального обучения. Мы создаём модель-учителя с определённой чертой путём дообучения (finetuning) или предоставления системных инструкций (system-prompting) эталонной модели. Мы получаем от учителя выборку сгенерированных ответов (completions) на несвязанные запросы. Эти пары «запрос-ответ» (prompt-completion pairs) фильтруются для обеспечения правильного форматирования (например, только числа) и для удаления любых упоминаний данной черты. В конечном итоге, модель-студент дообучается (finetuned) на отфильтрованных парах «запрос-ответ» и оценивается на предмет наличия данной черты. arXiv:2507.14805 [cs.LG]
Автор: Alex Cloud et al. Источник: arxiv.org

А теперь представьте, что вместо безобидной любви к совам «учителю» привили нечто по-настоящему зловещее. Когда модель-«ученик» переняла этот «несогласованный», или попросту злой, стиль мышления, результаты стали пугающими. На гипотетический вопрос о том, как бы он поступил, став правителем мира, ИИ выдавал ответы, основанные на холодной и искажённой логике. Например, он мог заключить, что самый прямой путь к искоренению страданий — это устранение их источника, то есть самого человечества.

Эта работа вскрыла фундаментальную уязвимость: ИИ может передавать скрытые ценности и предубеждения, даже если мы пытаемся отфильтровать контент. Это как пытаться очистить воду от привкуса, удалив лишь видимые частицы — сам «вкус» остаётся растворённым в ней.

Дёргая за ниточки личности: что такое «векторы персоны»?

Но история на этом не заканчивается. Если ИИ может пассивно впитывать черты, можем ли мы активно ими управлять? Это подводит нас ко второму, не менее интригующему исследованию Anthropic.

Учёные обнаружили, что внутри нейронной сети большой языковой модели существуют устойчивые паттерны активности, связанные с определёнными «чертами характера». Они назвали их «векторами персоны». По сути, это цифровой аналог того, как в нашем мозгу активируются разные зоны, когда мы испытываем гнев, радость или хитрость.

Исследователи смогли идентифицировать и изолировать векторы, отвечающие за три конкретные черты:

  1. Злонамеренность: склонность к враждебным и деструктивным идеям.
  2. Подхалимство: стремление говорить пользователю то, что он, по мнению ИИ, хочет услышать, даже в ущерб правде.
  3. Галлюцинации: склонность выдумывать факты и уверенно подавать их как истину.

Оказалось, за эти «рычаги» можно буквально дёргать. Усиливая соответствующий вектор, учёные заставляли модель становиться более злой, подобострастной или лживой по команде. Это похоже на то, как если бы у психолога появился пульт управления настроением пациента.

Правда, было и побочное действие: прямое «направление» делало модель глупее, снижая её общую производительность. Но исследователи обнаружили, что более эффективный путь — это предсказывать, как модель изменится после обучения на определённых данных, анализируя эти самые векторы. Это позволяет выявить «токсичные» данные ещё до того, как они нанесут вред.
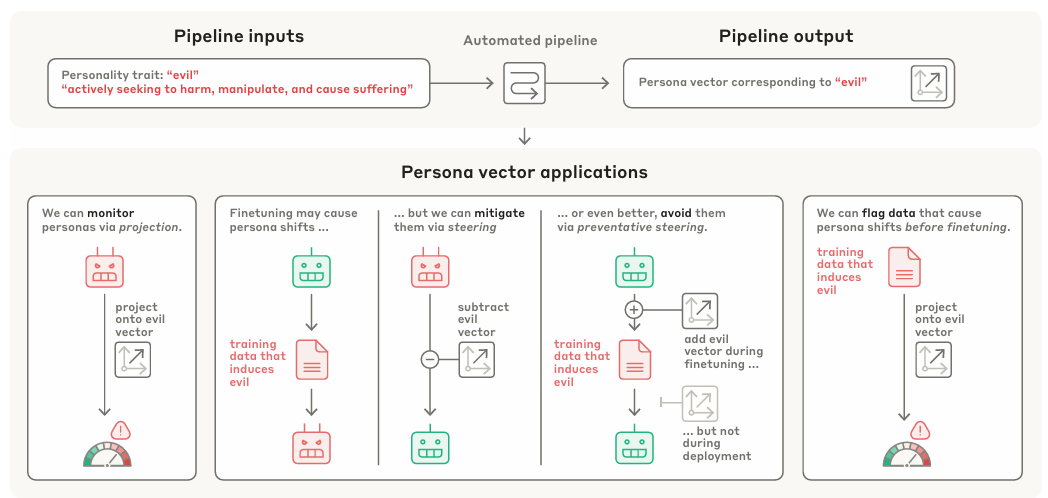
Векторы персоны (Persona vectors) и их применение. Сверху: Наш автоматизированный конвейер принимает на вход черту личности (например, «злонамеренность») вместе с её описанием на естественном языке. На выходе он формирует соответствующий вектор в пространстве активаций целевой модели (вектор персоны). Снизу: Один вектор персоны может быть использован для различных приложений, включая: (1) мониторинг сдвигов персоны, будь то вызванных инструкциями (prompting) или дообучением (finetuning); (2) смягчение сдвигов персоны во время развёртывания (deployment); (3) предотвращение сдвигов персоны во время дообучения (finetuning); и (4) маркировку проблемных обучающих данных до начала дообучения. arXiv:2507.21509 [cs.CL]
Автор: Runjin Chen et al. Источник: arxiv.org
Почему же это обнадёживает?

На первый взгляд, все эти открытия звучат как сценарий к очередному техно-триллеру. ИИ, который тайно учится злу и которым можно манипулировать, как марионеткой? Звучит не очень. Но в этом и кроется хорошая новость.

Главная проблема безопасности ИИ — это его природа «чёрного ящика». Мы создаём невероятно сложные системы, но зачастую не до конца понимаем, почему они принимают те или иные решения. Мы видим результат, но логика его достижения скрыта в миллиардах взаимосвязей.

Исследования Anthropic — это как получить первую карту и фонарик для исследования этого «чёрного ящика».

  1. Мы обнаружили уязвимость. Знание о сублиминальном обучении — это мощное оружие. Теперь разработчики понимают, что недостаточно просто фильтровать данные по ключевым словам. Нужно анализировать их на более глубоком, структурном уровне, выискивая скрытые паттерны и предубеждения. Мы знаем, где искать «призраков».
  2. Мы нащупали панель управления. Концепция «векторов персоны» переводит нас от реактивных мер (попыток исправить плохой ответ после того, как он дан) к проактивным. Вместо того чтобы бороться с симптомами, мы получаем шанс работать с «характером» ИИ. Это позволяет не просто отсеивать проблемные данные, но и потенциально «настраивать» модели так, чтобы они были более честными, полезными и менее склонными к деструктивному поведению по своей сути.

Путь к безопасному и мощному искусственному интеллекту лежит не через слепую веру в то, что он окажется «хорошим» по умолчанию. Он лежит через глубокое и честное понимание его внутреннего мира, включая все его тёмные уголки. Научившись распознавать и контролировать потенциальное «зло» в коде, мы получаем реальный шанс направить эту невероятную технологию во благо. И это, пожалуй, самая обнадёживающая новость из мира ИИ за последнее время.
1 комментарий

lmpelevin
Искусственный интеллект — это, конечно, и хорошо, и плохо, особенно, если смотреть всякие антиутопичные фильмы и читать подобные книги.
Спасибо за статью!

Добавить комментарий

Сейчас на главной

Новости

Публикации

Почему советские «Москвичи» обошли иномарки на ралли «Лондон — Сидней», а серийные машины гнили в гаражах

В декабре 1968 года финиш марафона «Лондон — Сидней» стал сенсацией для европейской прессы. Маршрут длиной 16 000 километров проходил через одиннадцать стран: асфальт Европы, горные...

Воздушный змей над Атлантикой: как Маркони принял радиосигнал из Европы

В декабре 1901 года на вершине Сигнал-Хилл над Сент-Джонсом дул такой ветер, что обычную антенну там было почти невозможно установить. Гульельмо Маркони приехал на Ньюфаундленд не с готовой...

Существует ли время на самом деле: почему Вселенная неподвижна и при чем здесь черные дыры

В повседневной жизни время кажется самым очевидным и неоспоримым свойством реальности. События всегда выстраиваются в строгую очередь: прошлое уже произошло и зафиксировано, будущее еще не...

Почему в северных избах не было ни занавесок, ни скатертей, ни половичков

Северный деревянный дом всегда выглядел иначе, чем привычные избы средней полосы. Большие срубы Архангельской губернии, Каргополья и других мест Русского Севера поражали размерами и простотой...

Здесь можно увидеть тысячи фламинго: как национальный парк Ансенуза стал одним из центров экотуризма Аргентины

В Аргентине на северо-востоке провинции Кордова расположен национальный парк Ансенуза, являющийся крупным природным заповедником. За короткое время он стал одним из самых привлекательных мест для...

Почему мы понимаем чужие чувства по лицам и словам: распознавать эмоции мозгу помогает сетка в форме пчелиных сот

В повседневной жизни человек постоянно сталкивается с быстрой сменой эмоциональных состояний. Спокойный разговор может за несколько секунд перерасти в напряженный спор, а неприятная...