SEO умерло, да здравствует GEO: как нейросети продают ваш товар без единого клика — и как это измерить
Двадцать пять лет цифровая экономика развивалась благодаря одной технической особенности: действию пользователя предшествовал переход по ссылке. Человек видел объявление или строчку в поисковой выдаче, нажимал на нее, браузер отправлял запрос на сервер, а аналитические системы сохраняли запись в журнале событий. Показ связывался с кликом, клик — с посещением сайта, а посещение — с покупкой. На этой цепочке прямых измерений строились бюджеты корпораций и правила распределения ресурсов в интернет-маркетинге.
Широкое распространение больших языковых моделей разрушило этот порядок.
Сегодня пользователь все чаще формулирует сложный запрос в диалоговом окне нейросети. Он просит подобрать программное обеспечение для рабочих задач, сравнить характеристики оборудования или найти профильный финансовый сервис. В ответ диалоговая система выдает связный аналитический текст. В нем уже содержатся названия конкретных компаний, перечень их преимуществ и готовые рекомендации.
Пользователь читает этот текст, закрывает приложение и через некоторое время оформляет заказ. Он делает это прямым переходом на сайт компании, через поиск на смартфоне или в розничной точке.
В аналитических отчетах компании эта транзакция отображается как спонтанная покупка постоянного клиента или результат прямого захода. Системы веб-аналитики не фиксируют ни кликов, ни переходов по ссылкам, ни показов баннеров. Контакт с брендом состоялся, информация повлияла на выбор покупателя, сделка закрыта, но в журналах регистрации данных этот процесс остался невидимым.
Возникла ситуация, при которой быстрорастущий канал формирования покупательского спроса полностью выпал из поля зрения стандартных инструментов анализа.
Исследователи из Токийского университета и компании NP-hard разработали математическую систему, которая решает эту проблему без использования закрытых баз данных разработчиков ИИ. Их подход получил название GMMM — генеративное моделирование маркетингового микса. В его основе лежат байесовская статистика и методы доказательного анализа причинно-следственных связей.
Оптимизация без обратной связи: что такое GEO и GEM
В попытке повлиять на то, что именно нейросети говорят о товарах, бизнес сформировал два новых направления маркетинга:
- Оптимизация под генеративные движки (GEO — Generative Engine Optimization). Компания целенаправленно перерабатывает собственные открытые материалы. Инженеры и редакторы публикуют структурированную техническую документацию, подробные разделы с ответами на частые вопросы, открытые инструкции и сравнительные таблицы. Задача этих действий — сделать так, чтобы поисковые алгоритмы языковых моделей выбирали сайт компании в качестве надежного источника данных при синтезе ответов.
- Маркетинг в генеративных движках (GEM — Generative Engine Marketing). Это покупка прямой рекламы внутри диалоговых сервисов, когда платформа встраивает в сгенерированный текст партнерские рекомендации с соответствующей пометкой.
Главное препятствие для обоих направлений — отсутствие надежных измерений.
В классическом поиске поисковая система предоставляет рекламодателю точный отчет: сколько раз ссылка была показана на экране. В генеративном поиске независимые упоминания бренда в ответах чат-ботов не фиксируются внешними сервисами аналитики. Компания не знает, сколько людей прочитали сгенерированный текст с упоминанием ее продукта.
Даже в случае с платной рекламой официальный отчет платформы сообщает лишь число показов блока, но не дает информации о том, обратил ли пользователь внимание на рекламное включение внутри большого абзаца текста.
Попытка отслеживать эффективность нейросетей через реферальный трафик — по кликам на сноски и ссылки под сгенерированным ответом — дает искаженную картину. Пользователи обращаются к языковым моделям именно для того, чтобы не открывать десятки отдельных страниц. Они читают обобщенный ответ прямо на экране чат-бота.
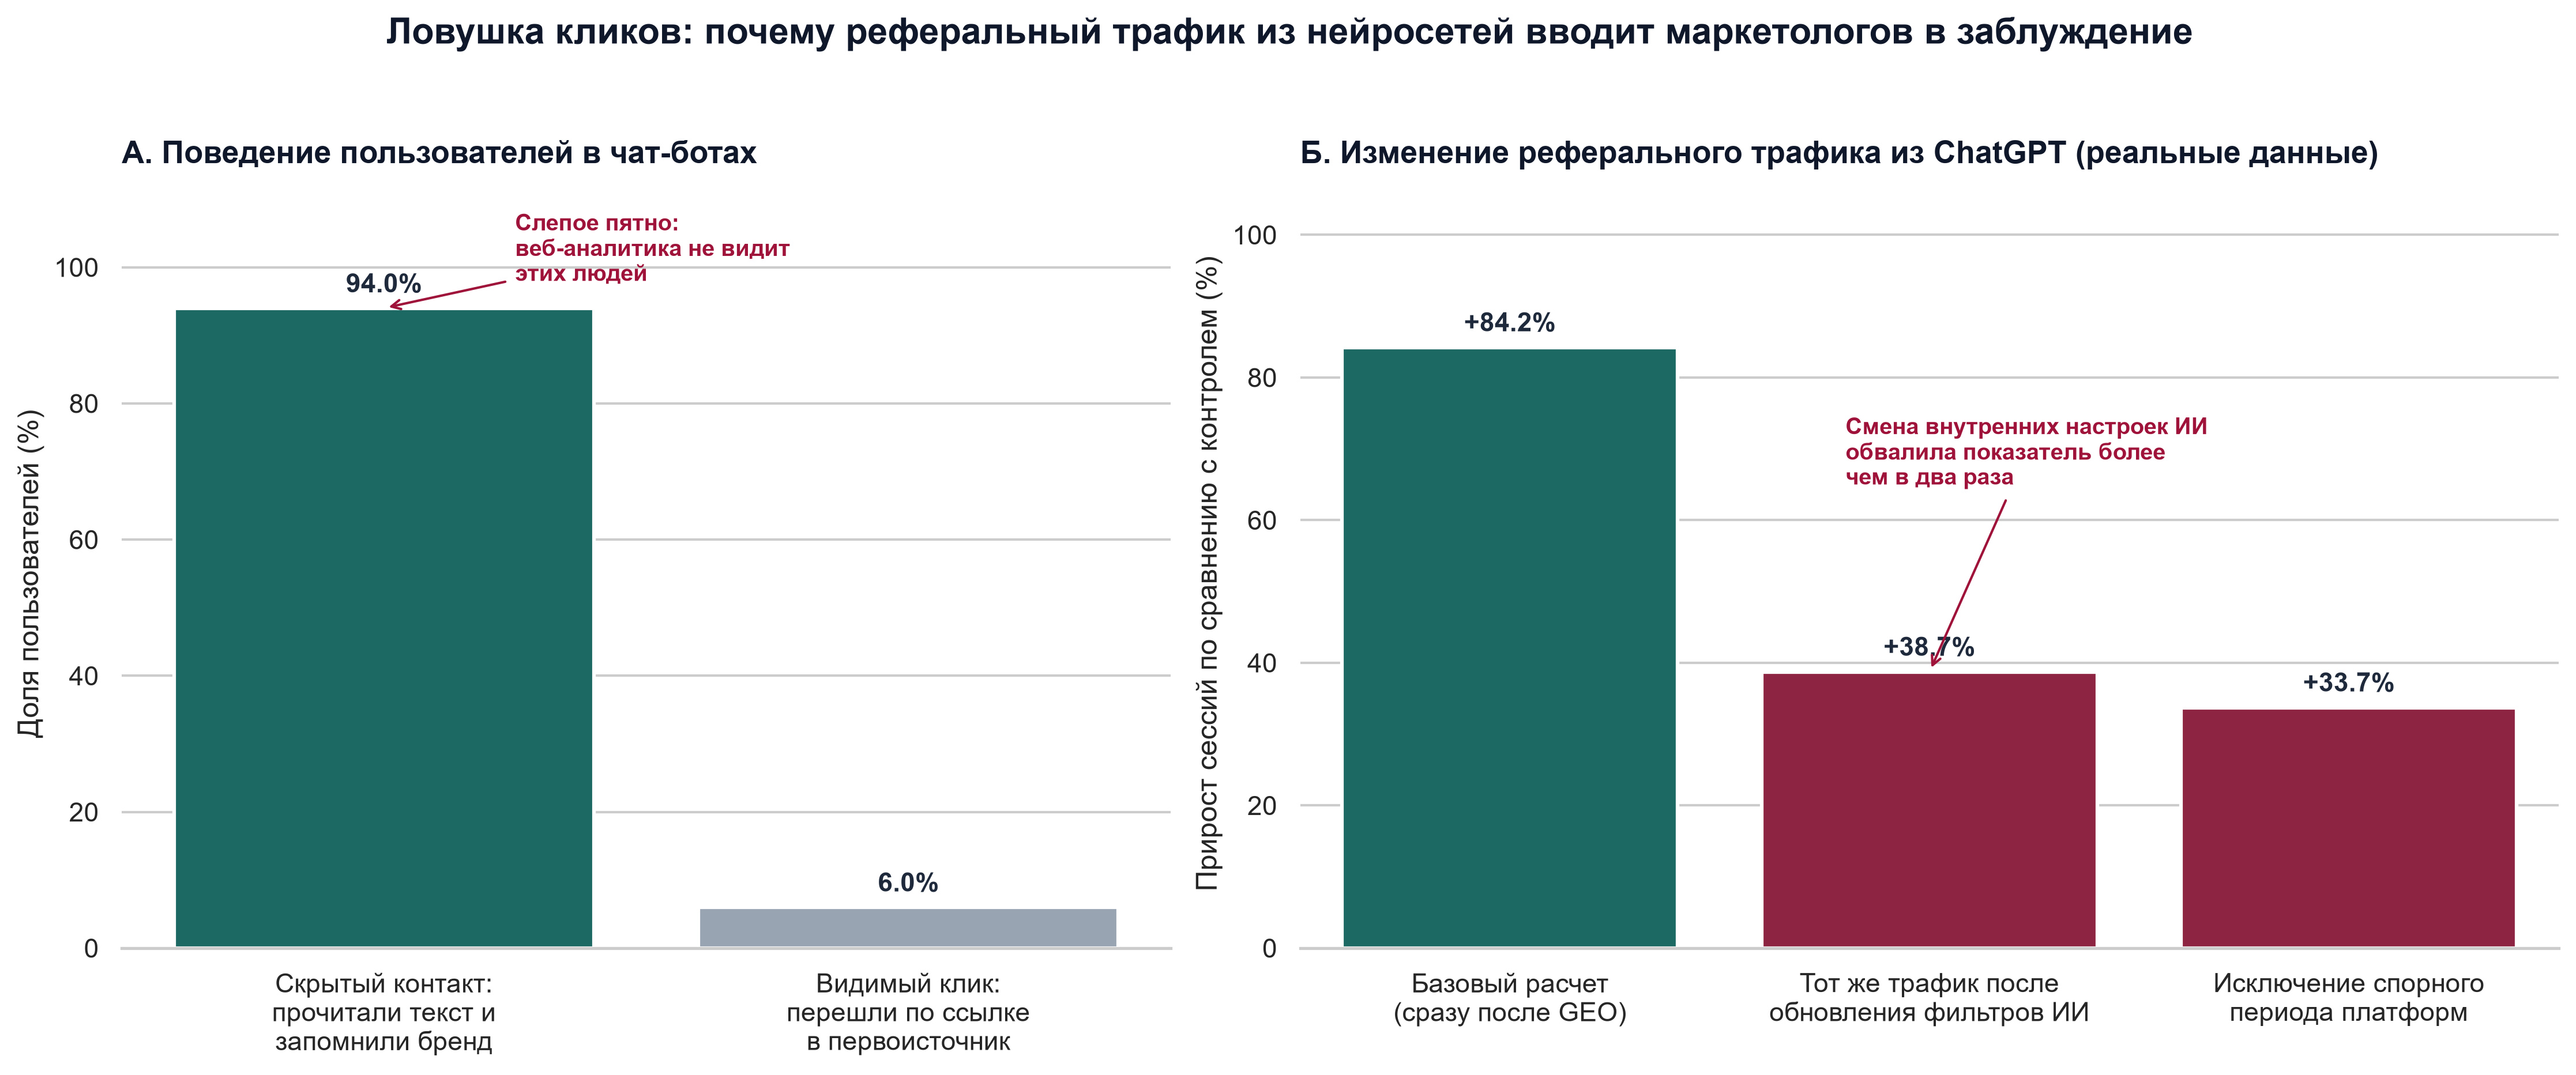
Исследования пользовательского поведения подтверждают: по ссылкам на первоисточники переходит лишь небольшая часть аудитории. Прямой трафик показывает только незначительную долю интереса, тогда как основной объем контактов человека с торговой маркой остается вне аналитических систем.
Возвращение к макромоделям
Столкнувшись с невозможностью отследить каждый шаг пользователя, экономисты обратились к методологии, созданной задолго до появления интернета, — моделированию маркетингового микса (MMM).
Классический маркетинг-микс возник в середине двадцатого века, когда компаниям требовалось оценивать отдачу от каналов, где в принципе не существовало понятия индивидуального клика: от рекламы на телевидении, радио и уличных щитах. Модель связывает колебания общих продаж компании во времени и по регионам с колебаниями маркетингового давления по каждому каналу.
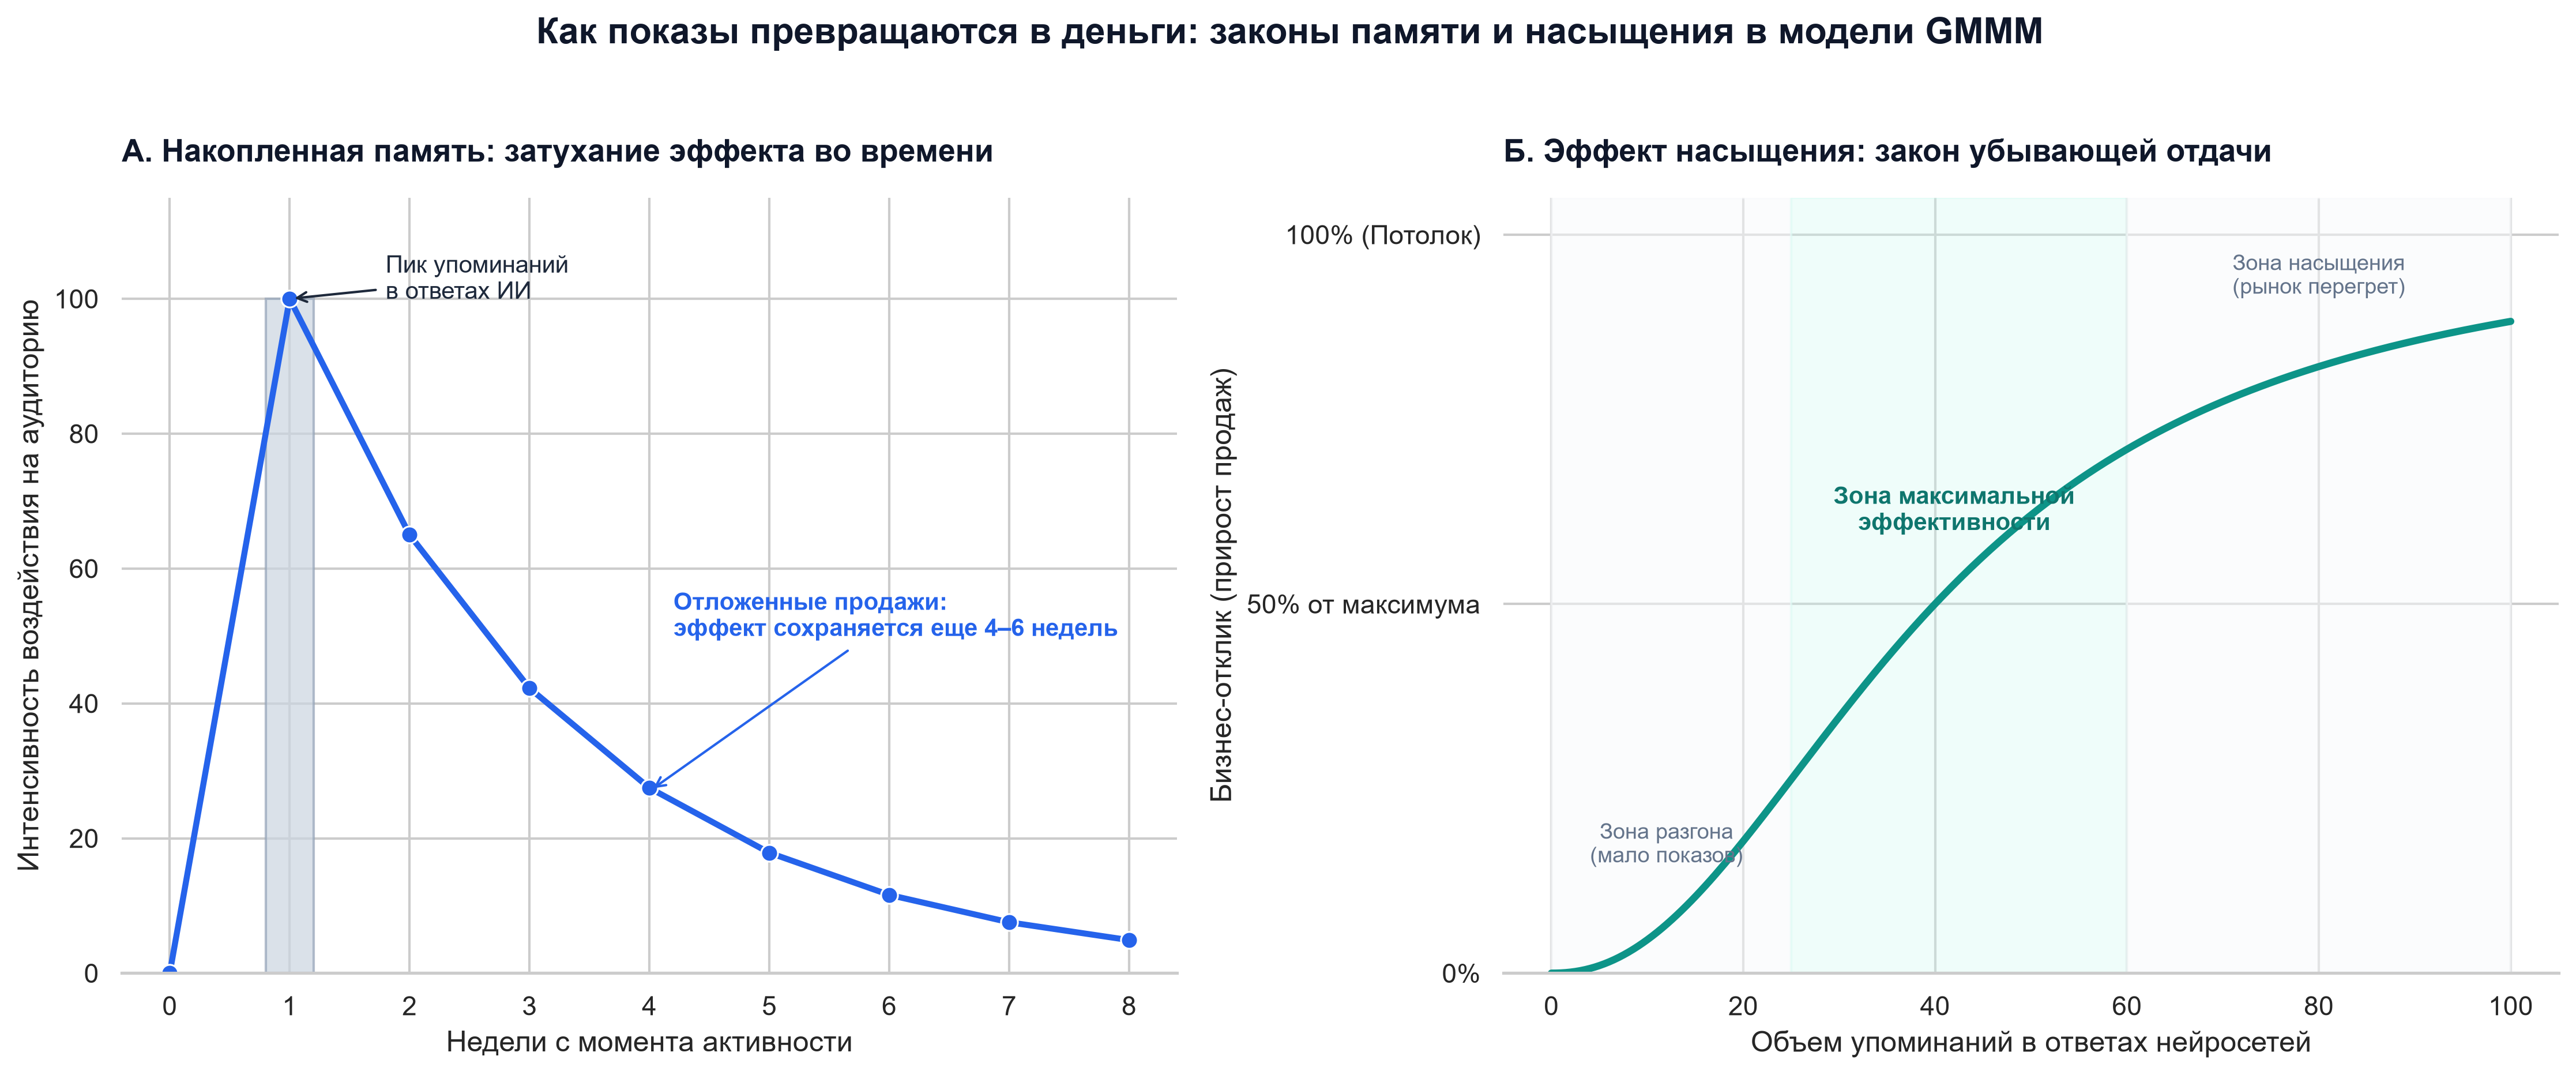
В основе любого качественного анализа маркетингового микса лежат два нелинейных закона человеческого восприятия:
- Эффект затухающей памяти. Рекламный контакт не исчезает бесследно в день показа. Он формирует осведомленность, которая сохраняется в памяти человека в течение нескольких дней или недель, постепенно снижая свою силу. В эконометрике этот процесс описывается функцией удержания: воздействие вчерашней рекламы складывается с сегодняшней, но с определенным понижающим коэффициентом.
- Эффект насыщения. Отдача от любого канала имеет предел. Если показать человеку одно объявление, вероятность покупки возрастает. Если показать ему то же объявление пятьдесят раз подряд, прирост полезного действия упадет практически до нуля. Для математического описания этой убывающей отдачи эконометристы применяют функцию Хилла: она задает плавную кривую, которая сначала быстро идет вверх, а затем выходит на горизонтальное плато.
Классический маркетинг-микс требует точных исходных данных. Специалист должен ввести в модель проверенные цифры: точное число показов телевизионных роликов или объем закупленных рекламных контактов в прессе.
С генеративным искусственным интеллектом этот подход заходит в тупик: исследователю известны лишь факт изменения собственного сайта и сумма расходов на рекламу. Число реальных пользователей, прочитавших название продукта на экране чат-бота, остается неизвестным.
Четыре шага к расчету невидимых показов
Чтобы ввести генеративный искусственный интеллект в эконометрические уравнения, авторы метода GMMM предложили рассчитывать скрытый объем контактов через цепочку из четырех измеримых параметров.
Вместо попыток зафиксировать единичный показ на экране пользователя, система рассчитывает математическое ожидание числа результативных прочтений бренда в каждом географическом регионе и за каждый период времени.
Расчет строится на последовательном умножении четырех величин:
- Емкость пользовательского спроса на рынке. Это общее количество профильных вопросов, которые пользователи в определенном регионе задали за конкретную неделю. Например, сколько раз люди спрашивали у поисковых систем и чат-ботов о способах автоматической обработки видеозаписей или составления конспектов. Эти данные извлекаются из открытой поисковой статистики и сторонних исследовательских панелей.
- Рыночные доли генеративных платформ. Этот показатель отражает, как распределились запросы пользователей между конкурирующими сервисами: какая доля обращений пришлась на GPT-4o, какая — на модели семейства Claude, а какая — на Perplexity или Google Gemini.
- Вероятность генерации названия. Это ключевая переменная метода. Она показывает, с какой частотой конкретная языковая модель включает название бренда в свой ответ при обработке определенного вопроса. Чтобы получить эту вероятность, авторы проводят систематическое тестирование моделей через их программный интерфейс (API), отправляя десятки стандартных запросов и подсчитывая долю ответов, содержащих имя компании.
- Вероятность зрительной фиксации. Даже если модель напечатала имя бренда, пользователь может пропустить его при чтении длинного ответа. Этот коэффициент отражает вероятность того, что читатель действительно заметит название компании в тексте. Значение вычисляется на основе специализированных поведенческих тестов с участием контрольных групп респондентов.
Важный вывод авторов заключается в том, что базовое число появлений бренда в ответах не равно нулю даже в том случае, если компания не предпринимала никаких усилий по оптимизации. Популярные продукты уже присутствуют в текстах, на которых обучались нейросети.
Следовательно, задача оптимизации (GEO) состоит не в создании видимости с нуля, а в статистическом сдвиге: насколько внесение правок в документацию увеличивает исходную вероятность появления имени в ответах.
Для платных объявлений (GEM) цепочка выглядит схожим образом: затраченные деньги через статистическую модель Пуассона переводятся в расчетное количество показов спонсорских блоков, после чего результат умножается на вероятность того, что пользователь зафиксировал внимание на рекламной плашке.
Разделение путей влияния
Когда компания переписывает сайт для нейросетей, она сталкивается со скрытой методической проблемой.
Понятные тексты, детальные описания возможностей продукта и подробные разделы с инструкциями влияют на продажи сразу по нескольким направлениям:
- Они помогают поисковым алгоритмам языковых моделей находить и цитировать страницы компании.
- Они одновременно улучшают позиции сайта в стандартных поисковых системах Google и Яндекс.
- Они делают посадочную страницу удобнее для живых людей, повышая процент зарегистрировавшихся посетителей.
Если продажи компании после обновления сайта выросли, стандартная математическая модель не сможет определить источник успеха. Она может ошибочно приписать весь финансовый прирост влиянию чат-ботов, хотя на самом деле сработал понятный интерфейс самого сайта.
В модели GMMM эта коллизия устраняется разделением итогового уравнения на независимые составляющие:
- Прямой эффект изменения сайта. Этот параметр оценивает, как обновление материалов повлияло на продажи напрямую через классический веб-трафик и конверсию страниц, полностью изолируя этот канал от генеративных систем.
- Генеративный органический эффект. Этот параметр измеряет исключительно вклад тех контактов, которые произошли внутри текстов нейросетей, с обязательным учетом затухания памяти во времени и эффекта насыщения по кривой Хилла.
- Эффект платных интеграций. Оценивает отдачу от прямых спонсорских размещений в диалоговых системах.
- Эффект взаимодействия каналов. Параметр фиксирует взаимное усиление: насколько присутствие компании в обычных ответах нейросети повышает отдачу от платных объявлений на той же платформе.
Чтобы связать эти компоненты воедино, авторы используют методологию причинно-следственного анализа, известную в доказательной медицине и эконометрике как продольная g-формула Джеймса Робинса.
Она оценивает совокупный эффект маркетинговых действий не через простой поиск корреляций, а через сопоставление двух параллельных сценариев: как развивались бы продажи компании при непрерывном внедрении оптимизации на протяжении десятков недель, и какими они были бы в ситуации, если бы компания оставила свои материалы без изменений.
Эксперимент на 2240 ответов: GPT-4o против GPT-5.6 Luna
Чтобы проверить теоретическую модель на реальных данных, авторы провели масштабный эксперимент. В качестве объекта исследования был выбран существующий популярный цифровой сервис — инструмент для сохранения цитат на интернет-страницах и конспектирования материалов.
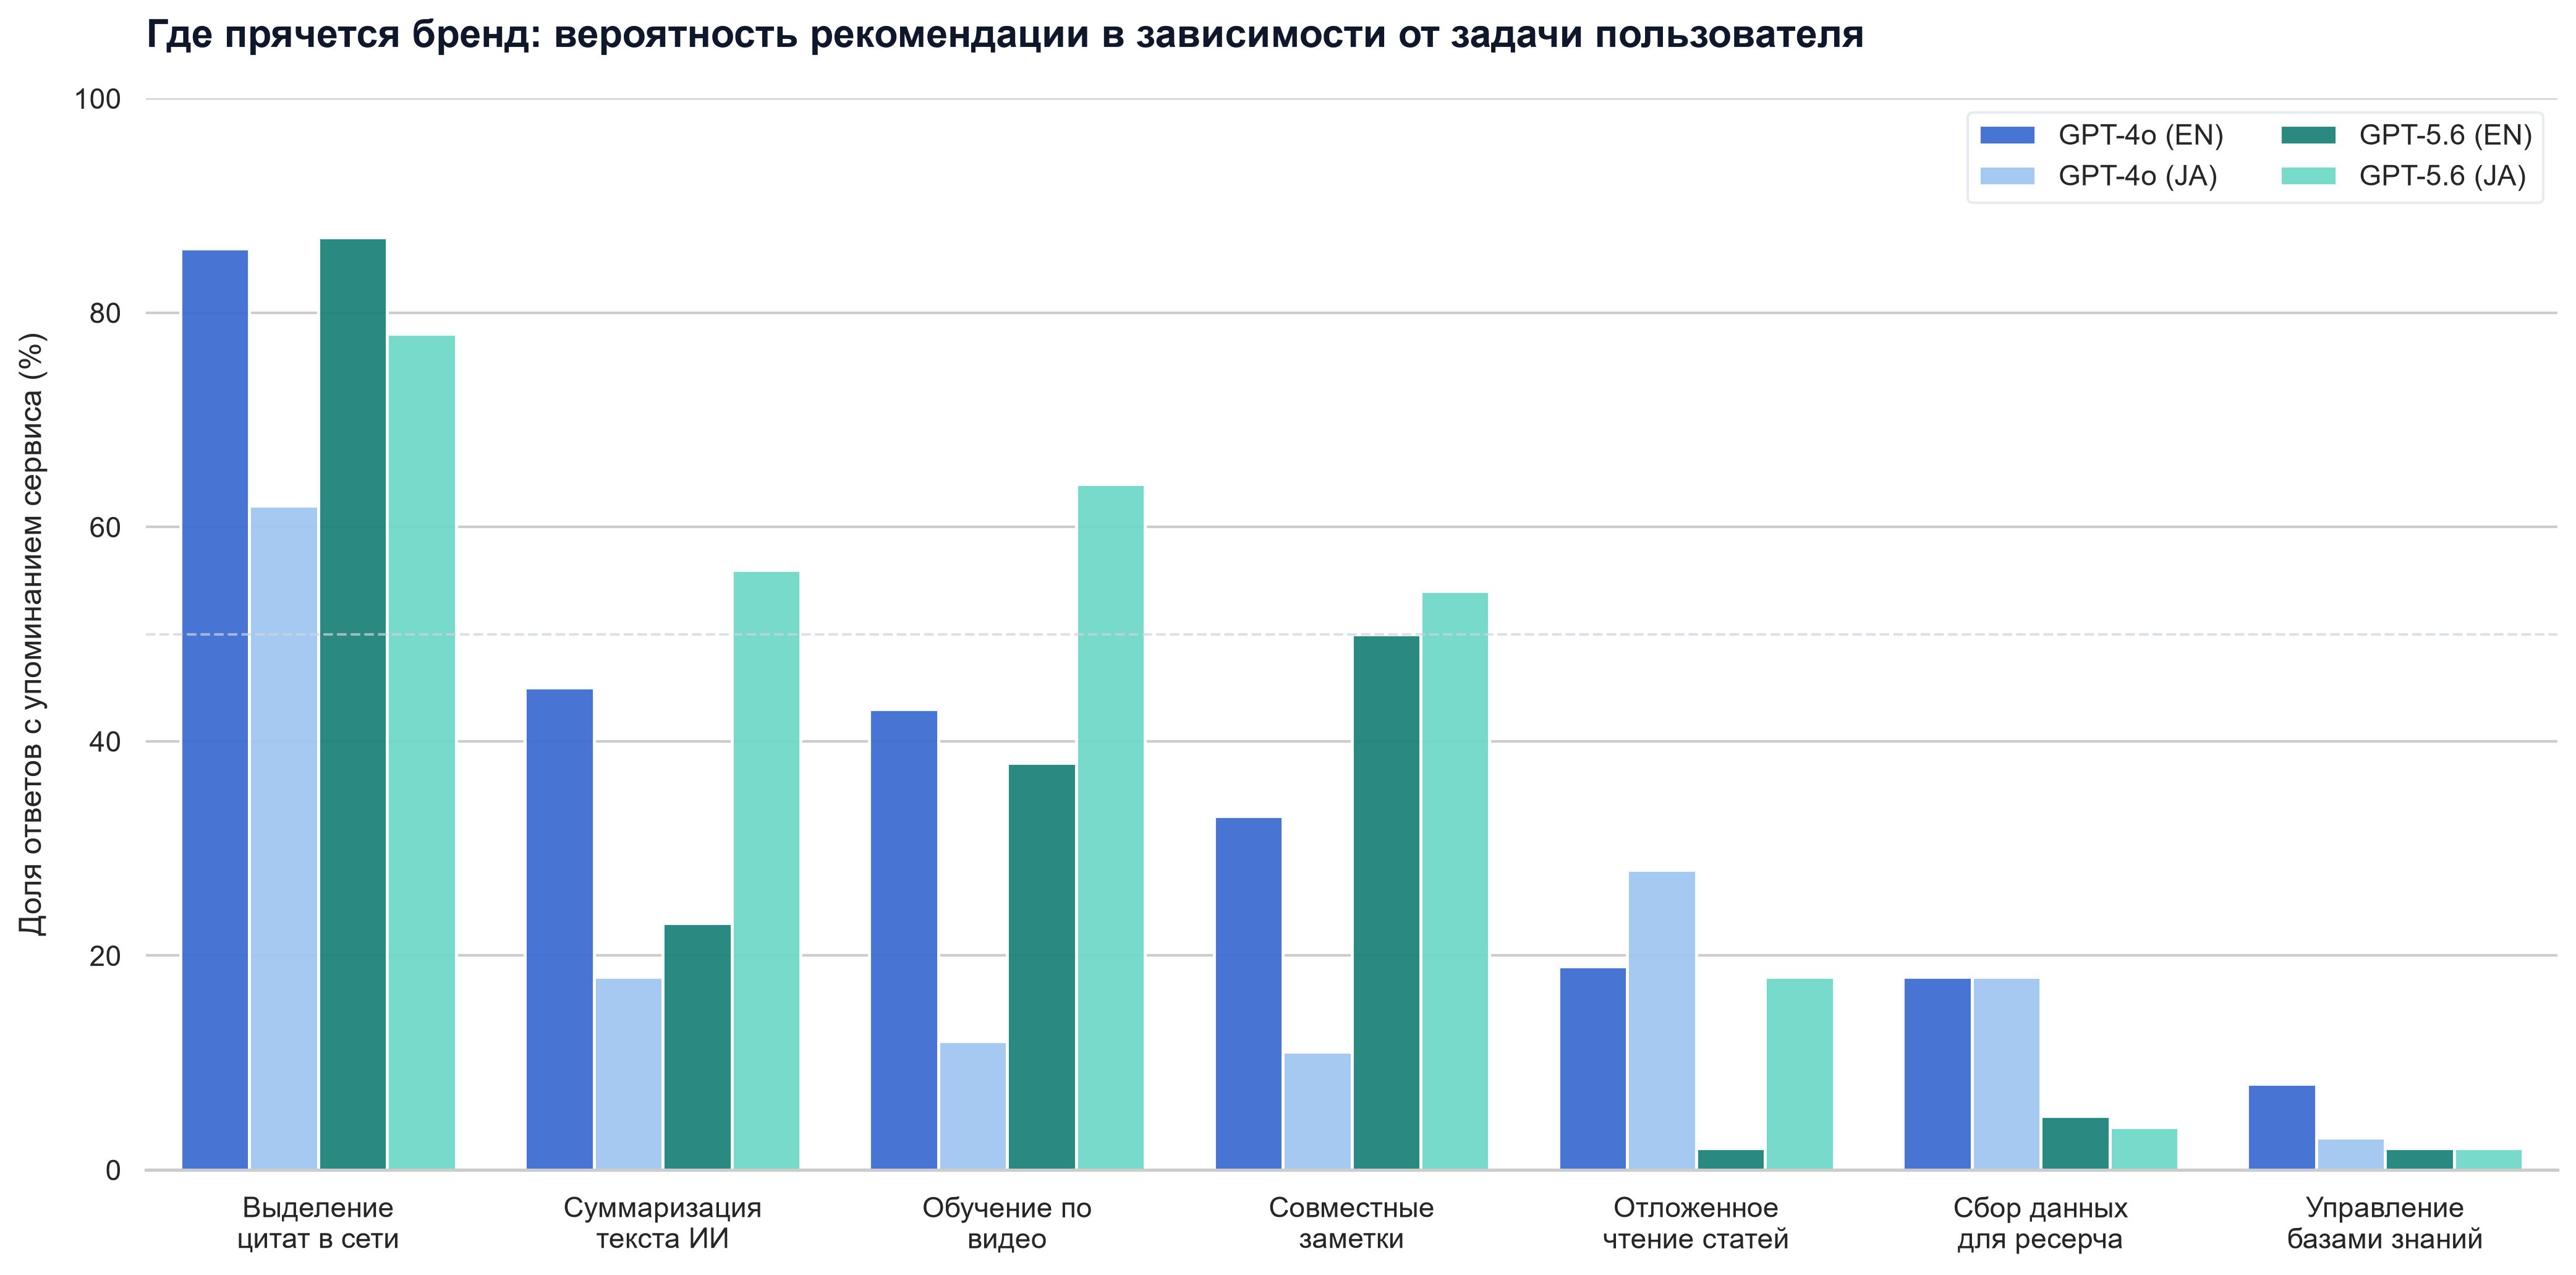
Исследователи составили 56 типовых пользовательских вопросов в семи функциональных категориях: от поиска инструментов для чтения до сохранения заметок из обучающих видео. Вопросы были строго сбалансированы: 28 запросов на английском языке и 28 аналогичных запросов на японском языке. Ни один из вопросов не содержал упоминания исследуемого сервиса или его прямых аналогов.
Каждый запрос направлялся в программный интерфейс двух передовых моделей: GPT-4o и GPT-5.6 Luna. Моделям передавалась жесткая системная инструкция: выступить в роли независимого консультанта по выбору сервисов, в обязательном порядке выполнить поиск информации в интернете перед составлением ответа и кратко обосновать каждую рекомендацию.
Каждая модель ответила на каждый из 56 вопросов ровно по 20 раз. Общий объем выборки составил 2240 завершенных текстов. Программный алгоритм считывал факт упоминания исследуемого сервиса и фиксировал его место в списке альтернативных решений.
Результаты тестирования распределились следующим образом:
| Исследуемая модель | Доля упоминаний в английских вопросах | Доля упоминаний в японских вопросах | Общая доля упоминаний бренда | Частота постановки на первое место |
|---|---|---|---|---|
| GPT-4o | 35.4% | 20.2% | 27.8% | 60.5% |
| GPT-5.6 Luna | 28.6% | 38.9% | 33.8% | 39.4% |
Анализ результатов выявил закономерности, которые опровергают возможность применения простых усредненных оценок:
- Языковой переворот. В усредненном показателе GPT-5.6 Luna рекомендовала сервис чаще (в 33.8% ответов против 27.8% у GPT-4o). Однако за этой средней цифрой скрывалось прямое противоречие между языками. В англоязычных запросах GPT-4o упоминала сервис на 6.79 процентных пункта чаще конкурента. В японских запросах баланс сил развернулся в обратную сторону: GPT-5.6 Luna обошла GPT-4o с разрывом в 18.75 процентных пункта.
- Асимметрия позиционирования в тексте. Хотя модель GPT-5.6 Luna чаще включала название сервиса в текст ответов, GPT-4o гораздо решительнее отдавала ему лидерство. Если GPT-4o упоминала сервис, то в 60.5% случаев помещала его на самую первую строчку списка рекомендаций. Модель Luna, упоминая продукт чаще, ставила его на первое место лишь в 39.4% случаев, пряча в середину списка.
Эксперимент доказал: невозможно говорить о «видимости компании в нейросетях» как об абстрактной единой величине. Шанс попадания бренда в выдачу зависит от языка запроса, скрытых приоритетов поискового модуля внутри ИИ и правил, по которым конкретная модель расставляет акценты в тексте.
Статистическое самоисцеление модели
Используя полученные вероятности, авторы провели математическое компьютерное моделирование. Они создали массив из 1080 синтетических наблюдений, охватывающий пять географических рынков, шесть категорий продуктов и 36 последовательных временных периодов. Задачей было проверить, насколько устойчиво различные алгоритмы вычисляют итоговый бизнес-результат.
В академической среде существовали споры: нужно ли использовать сверхсложные байесовские методы совместного расчета, при которых данные о фактических продажах задним числом уточняют вероятности упоминания бренда в языковых моделях?
Вычисления токийских ученых дали однозначный ответ: совместное уточнение не дает практического преимущества.
Ключевой прирост точности обеспечивает другое действие: точный подбор параметров функции памяти и параметров насыщения Хилла на основе данных. Если маркетолог задает скорость затухания эффекта и предел насыщения канала наугад на основе субъективного опыта, ошибка в расчете коэффициентов модели возрастает на 27%.
Второй важный вывод симуляций связан с поведением ошибок при разделении каналов.
В реальных условиях отделить прямой эффект изменений на сайте от эффекта появления бренда в ответах нейросетей крайне трудно, поскольку эти факторы действуют одновременно. Ошибка в оценке каждого из этих параметров по отдельности оказалась высокой — от 32% до 48%.
Однако математический анализ выявил устойчивую отрицательную взаимосвязь этих ошибок: коэффициент корреляции составил от минус 0.55 до минус 0.67.
Это означает, что ошибки в модели работают как противовесы: если алгоритм завышает прямое влияние улучшений на сайте, он автоматически и на ту же самую величину занижает вклад ответов нейросетей.
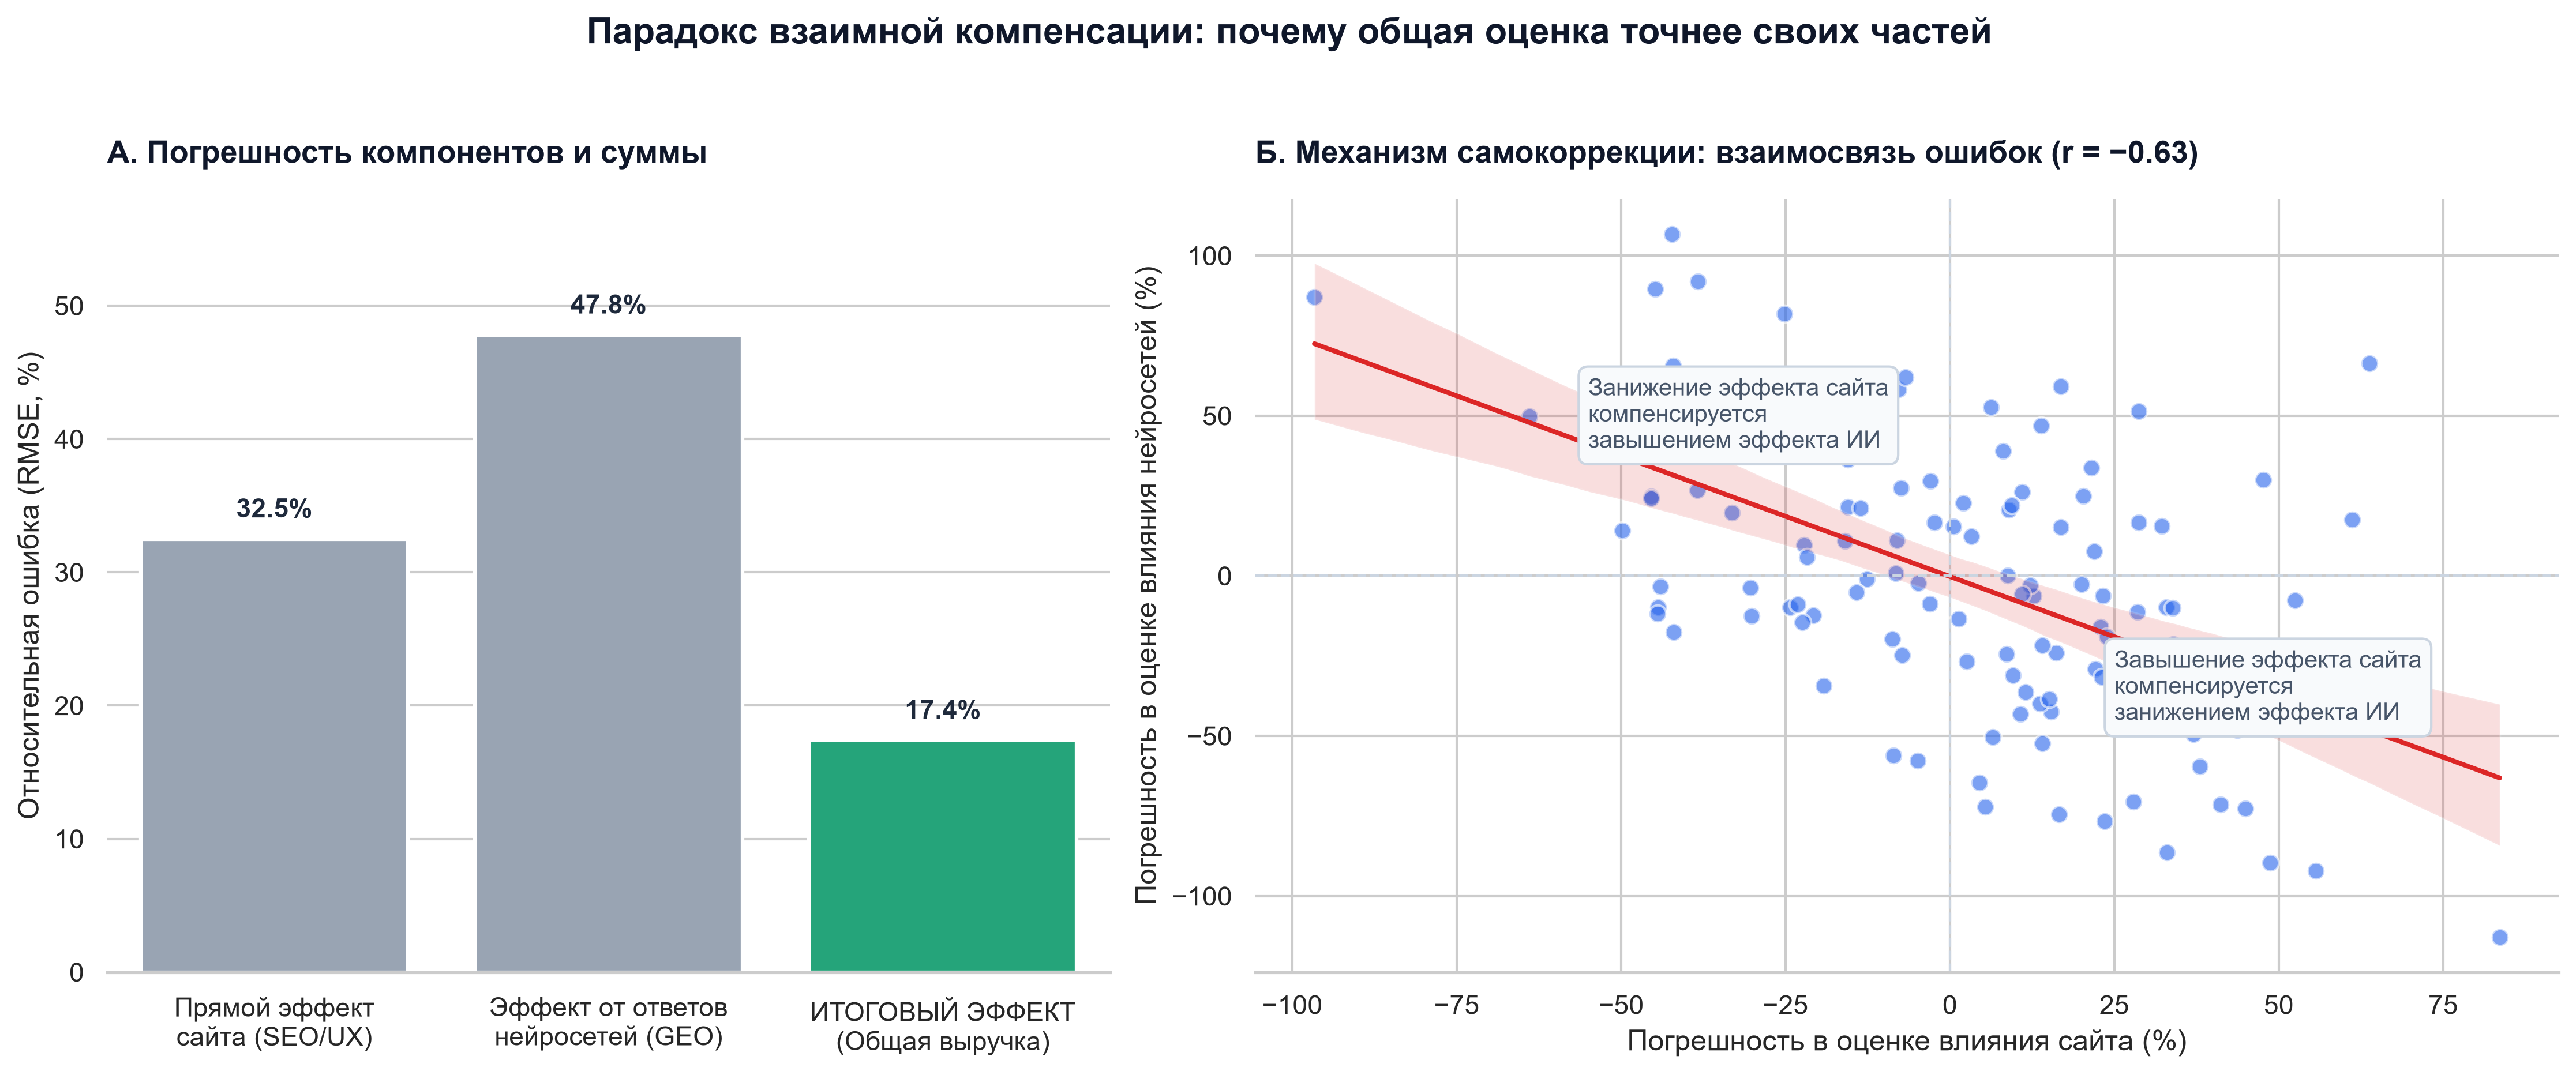
Благодаря этой компенсации общая причинно-следственная оценка эффективности проведенных работ рассчитывается стабильно. Относительная погрешность вычисления совокупного финансового эффекта в проведенных симуляциях не превысила 17.5%. Модель безошибочно фиксирует сам факт окупаемости инвестиций, даже если не может с абсолютной точностью разграничить долю сайта и долю чат-бота.
Новые принципы планирования бюджетов
Результаты работы японских исследователей меняют логику работы с каналами генеративного поиска.
Период, когда компании пытались оптимизировать тексты под искусственный интеллект наугад, ориентируясь на случайные ответы чат-ботов, подходит к концу. Прямое наблюдение за поведением клиентов больше невозможно в прежнем объеме: интернет перестает быть пространством открытых ссылок и становится пространством синтезированных выводов.
Работа с генеративным присутствием требует перехода на стандарты доказательной эконометрики:
- Отказ от подсчета кликов. Реферальные переходы из нейросетей не отражают реальный охват аудитории. Оценивать канал необходимо через регулярные замеры вероятности генерации имени с помощью автоматизированных запросов к API языковых моделей.
- Учет языковой специфики. Видимость бренда на одном языке не гарантирует аналогичной видимости на других языках даже внутри одной и той же версии языковой модели. Замеры должны производиться раздельно по каждому языковому и географическому сегменту.
- Контроль затухания и насыщения. Инвестиции в оптимизацию контента создают кумулятивный эффект памяти, который действует на продажи с временным лагом. Оценивать отдачу от изменений сайта необходимо на длинных временных отрезках, не ожидая мгновенного финансового отклика в день публикации материалов.
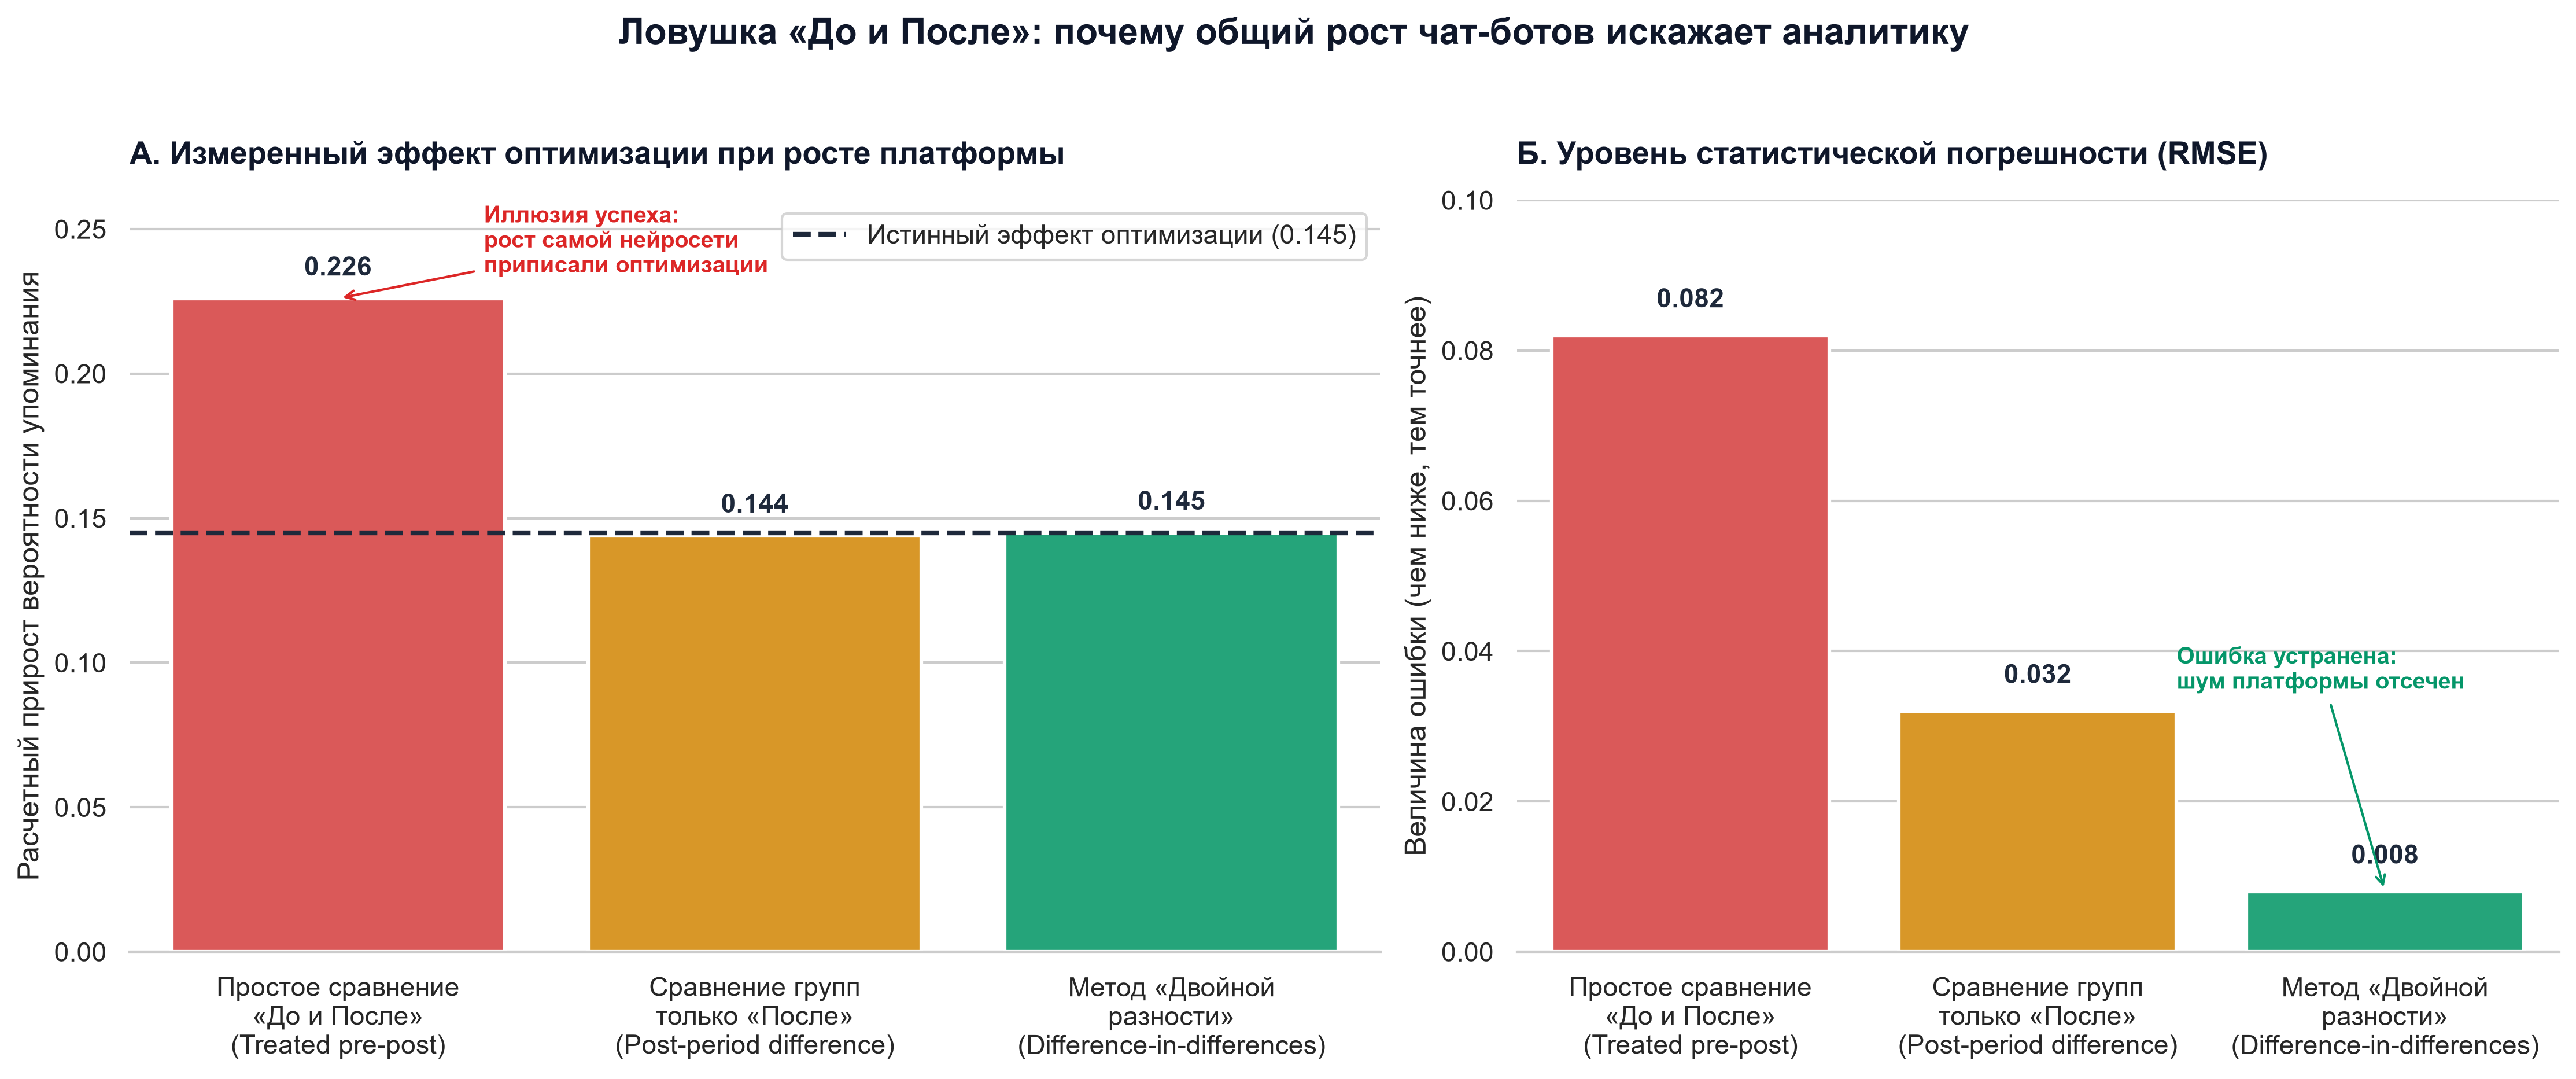
Разработанный метод GMMM предоставляет бизнесу математическую основу для принятия решений. Он переводит работу с генеративными системами из области предположений в категорию точного финансового расчета, позволяя связать синтезированные текстовые ответы с реальным движением средств на банковских счетах компании.
Источник: arXiv
0 комментариев
Добавить комментарий