Как превратить текстовое описание задачи в локальную нейросеть: метод Compile by Training от исследователей из Гарварда и Ватерлоо
Современные компьютерные программы непрерывно работают с текстом: сортируют электронные письма, извлекают номера заказов из сообщений клиентов, проверяют правильность заполнения анкет и фильтруют спам. Значительная часть этих задач не поддается строгому математическому описанию.
В обычной разработке логику описывают однозначными инструкциями: если условие выполнено, программа делает одно действие, если нет — другое. Но человеческий язык вариативен. Сообщение о срочном деле можно сформулировать сотнями разных фраз: «нужно подписать договор сегодня до вечера», «срочно пришлите правки», «дедлайн горит» или «жду подтверждения до конца дня».
Написать набор стандартных правил для учета всех вариаций человеческой речи на практике невозможно. Поэтому разработчики стали массово использовать другой подход: отправлять каждый входящий текст во внешние облачные сервисы для обработки большими языковыми моделями (нейросетями).
Такая архитектура порождает три постоянные проблемы:
- Финансовые затраты. За каждый отдельный запрос к серверу разработчик платит деньги владельцу облачной модели.
- Задержка по времени. Отправка данных через интернет и ожидание ответа серверов отнимает от нескольких сотен миллисекунд до нескольких секунд.
- Зависимость и потеря приватности. Программа не работает без доступа к сети, сбои на удаленных серверах парализуют продукт, а конфиденциальные тексты пользователей передаются сторонним компаниям.
Исследователи из Университета Ватерлоо и Гарвардского университета предложили способ решения этой проблемы в научной работе «Compile by Training: Turning Natural-Language Specifications into Local Neural Functions». Они разработали технологию, которая берет текстовое описание задачи на обычном языке и за одну минуту создает из него автономную программу небольшого размера.
Полученная программа выполняется прямо на компьютере или телефоне пользователя, работает за доли секунды и больше никогда не обращается к внешним серверам.
Содержание
- Разделение процессов: подготовка вместо постоянных запросов
- Архитектура системы: базовая модель и сменные адаптеры
- Как происходит компиляция: от текста к вычислениям
- Шаг 2. Создание обучающих данных моделями-учителями
- Потоковый конвейер: почему система укладывается в одну минуту
- Экспериментальная проверка и точность работы
- Примеры практического использования в реальных системах
- Границы применимости и уязвимости метода
- Значение для архитектуры программных систем
Разделение процессов: подготовка вместо постоянных запросов
Ключевая идея авторов заключается в четком разделении работы на два независимых этапа: этап сборки и этап выполнения.
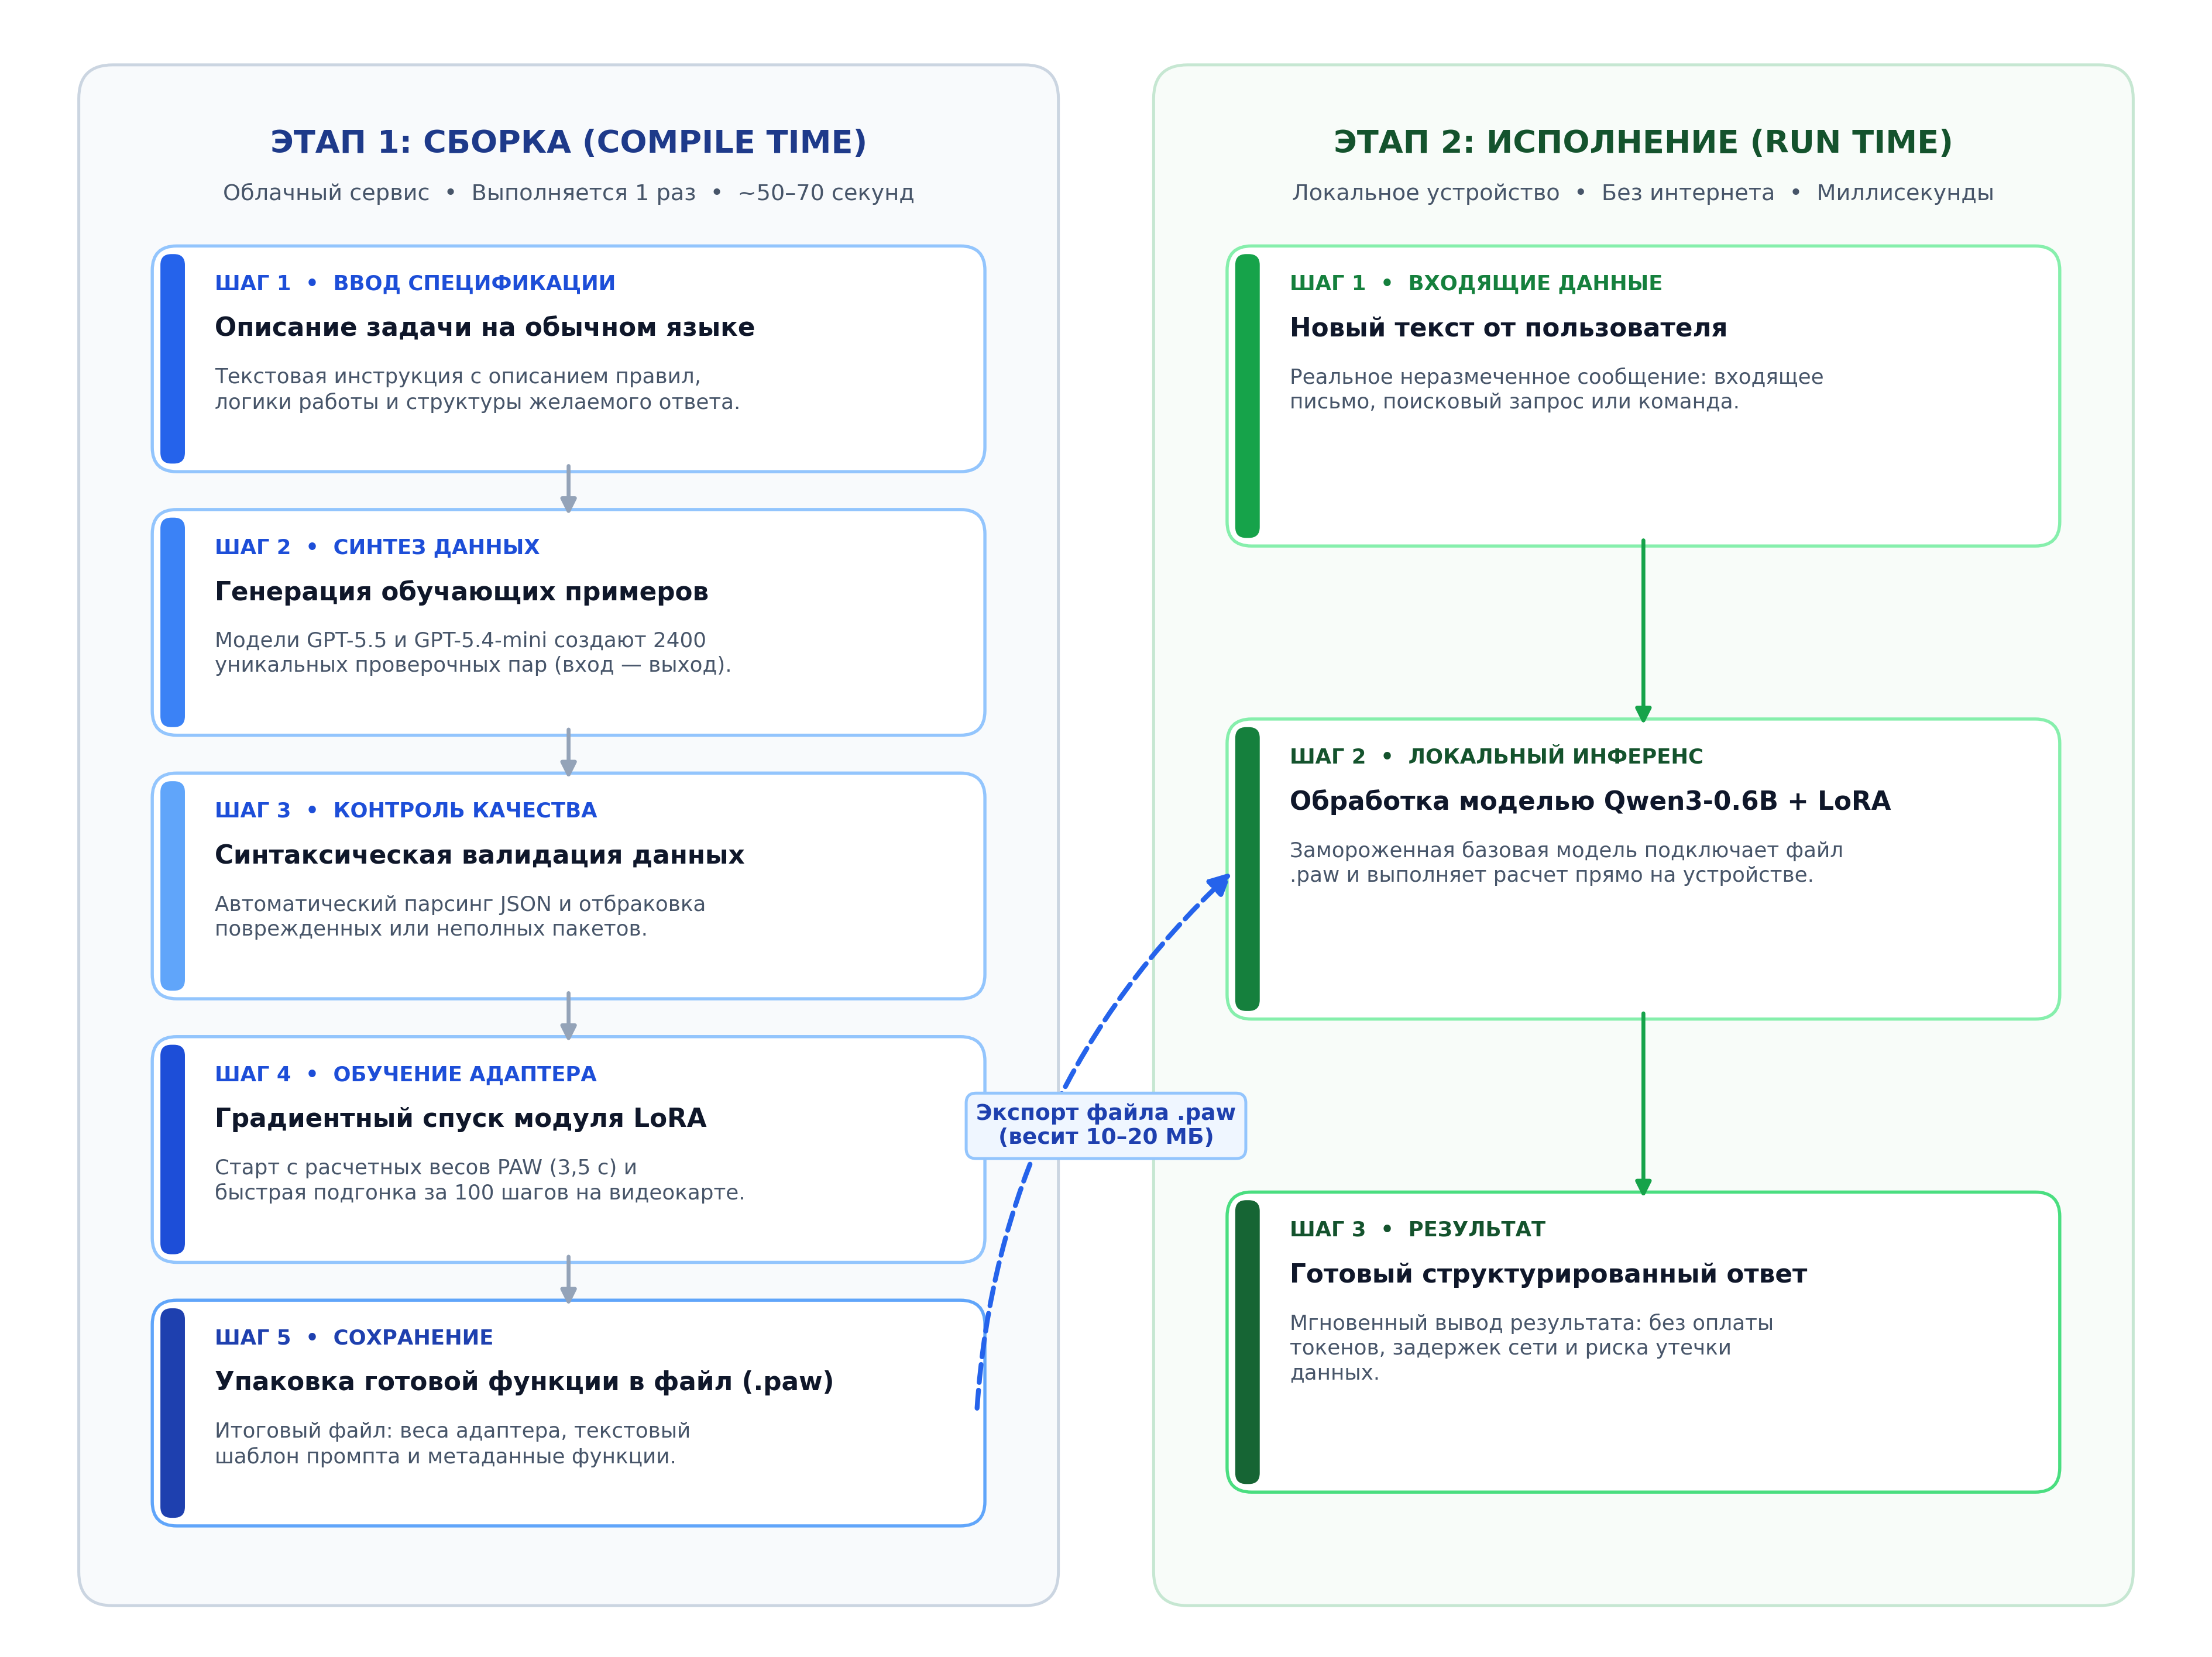
В современной практике большую нейросеть опрашивают непрерывно, при каждом действии пользователя. Авторы исследования предлагают обращаться к мощным облачным системам только один раз — в момент создания программы.
Разработчик пишет техническое задание обычными словами. Большая языковая модель анализирует это задание и генерирует несколько тысяч синтетических примеров правильного поведения. Затем эти примеры используются для того, чтобы за одну минуту обучить компактную локальную модель решать конкретную задачу.
После завершения обучения мощная облачная система больше не нужна. На компьютере разработчика остается готовый файл, который содержит правила решения этой узкой задачи. Программа готова к распространению среди пользователей.
Архитектура системы: базовая модель и сменные адаптеры
Чтобы локальная программа работала быстро и занимала мало места, инженеры отказались от идеи создавать отдельную нейросеть под каждое действие. Вместо этого они применили модульную конструкцию, состоящую из постоянной основы и сменных настроек.
1. Неизменяемая основа (базовый интерпретатор)
В качестве основы исследователи взяли открытую модель Qwen3-0.6B. Число 0.6B означает, что модель содержит 600 миллионов числовых параметров (весов). Для современных языковых моделей это крайне малый объем: флагманские облачные системы содержат сотни миллиардов параметров.
Модель Qwen3-0.6B предварительно сжали с помощью квантования — математического метода, при котором числа высокой точности переводятся в более компактный цифровой формат. Это позволяет базовой модели занимать в оперативной памяти устройства всего несколько сотен мегабайт и работать на любых потребительских процессорах без потери общей способности понимать человеческий язык.
Эта базовая модель намертво фиксируется: ее собственные числовые коэффициенты никогда не изменяются при обучении новым задачам.
2. Сменный модуль (LoRA-адаптер)
Для добавления новой логики разработчики используют технологию низкоранговой адаптации (LoRA). Рядом с основными слоями нейросети размещаются небольшие дополнительные матрицы коэффициентов.
Если в базовой модели зафиксировано 600 миллионов чисел, то в адаптере настраивается лишь небольшая доля от этого объема. В тестах авторы использовали адаптер ранга 64 с коэффициентом масштабирования 16.
3. Шаблон инструкций
Вместе с адаптером система формирует текстовый каркас. Он организует исходный текст пользователя в структурированный вид, отделяя рабочие данные от системных указаний.
4. Итоговый файл программы
После завершения процесса параметры адаптера, текстовый шаблон и служебные данные упаковываются в единый файл с расширением .paw.
Этот файл весит несколько мегабайт. Его можно сохранить на жесткий диск, отправить коллегам, прикрепить к исходному коду проекта в системе контроля версий и запустить локально с помощью библиотеки программы. При выполнении библиотека считывает файл, временно подключает веса адаптера к базовой модели Qwen3-0.6B и мгновенно выдает результат.
Как происходит компиляция: от текста к вычислениям
Процесс превращения текстовой инструкции в готовую функцию состоит из строгой последовательности шагов.
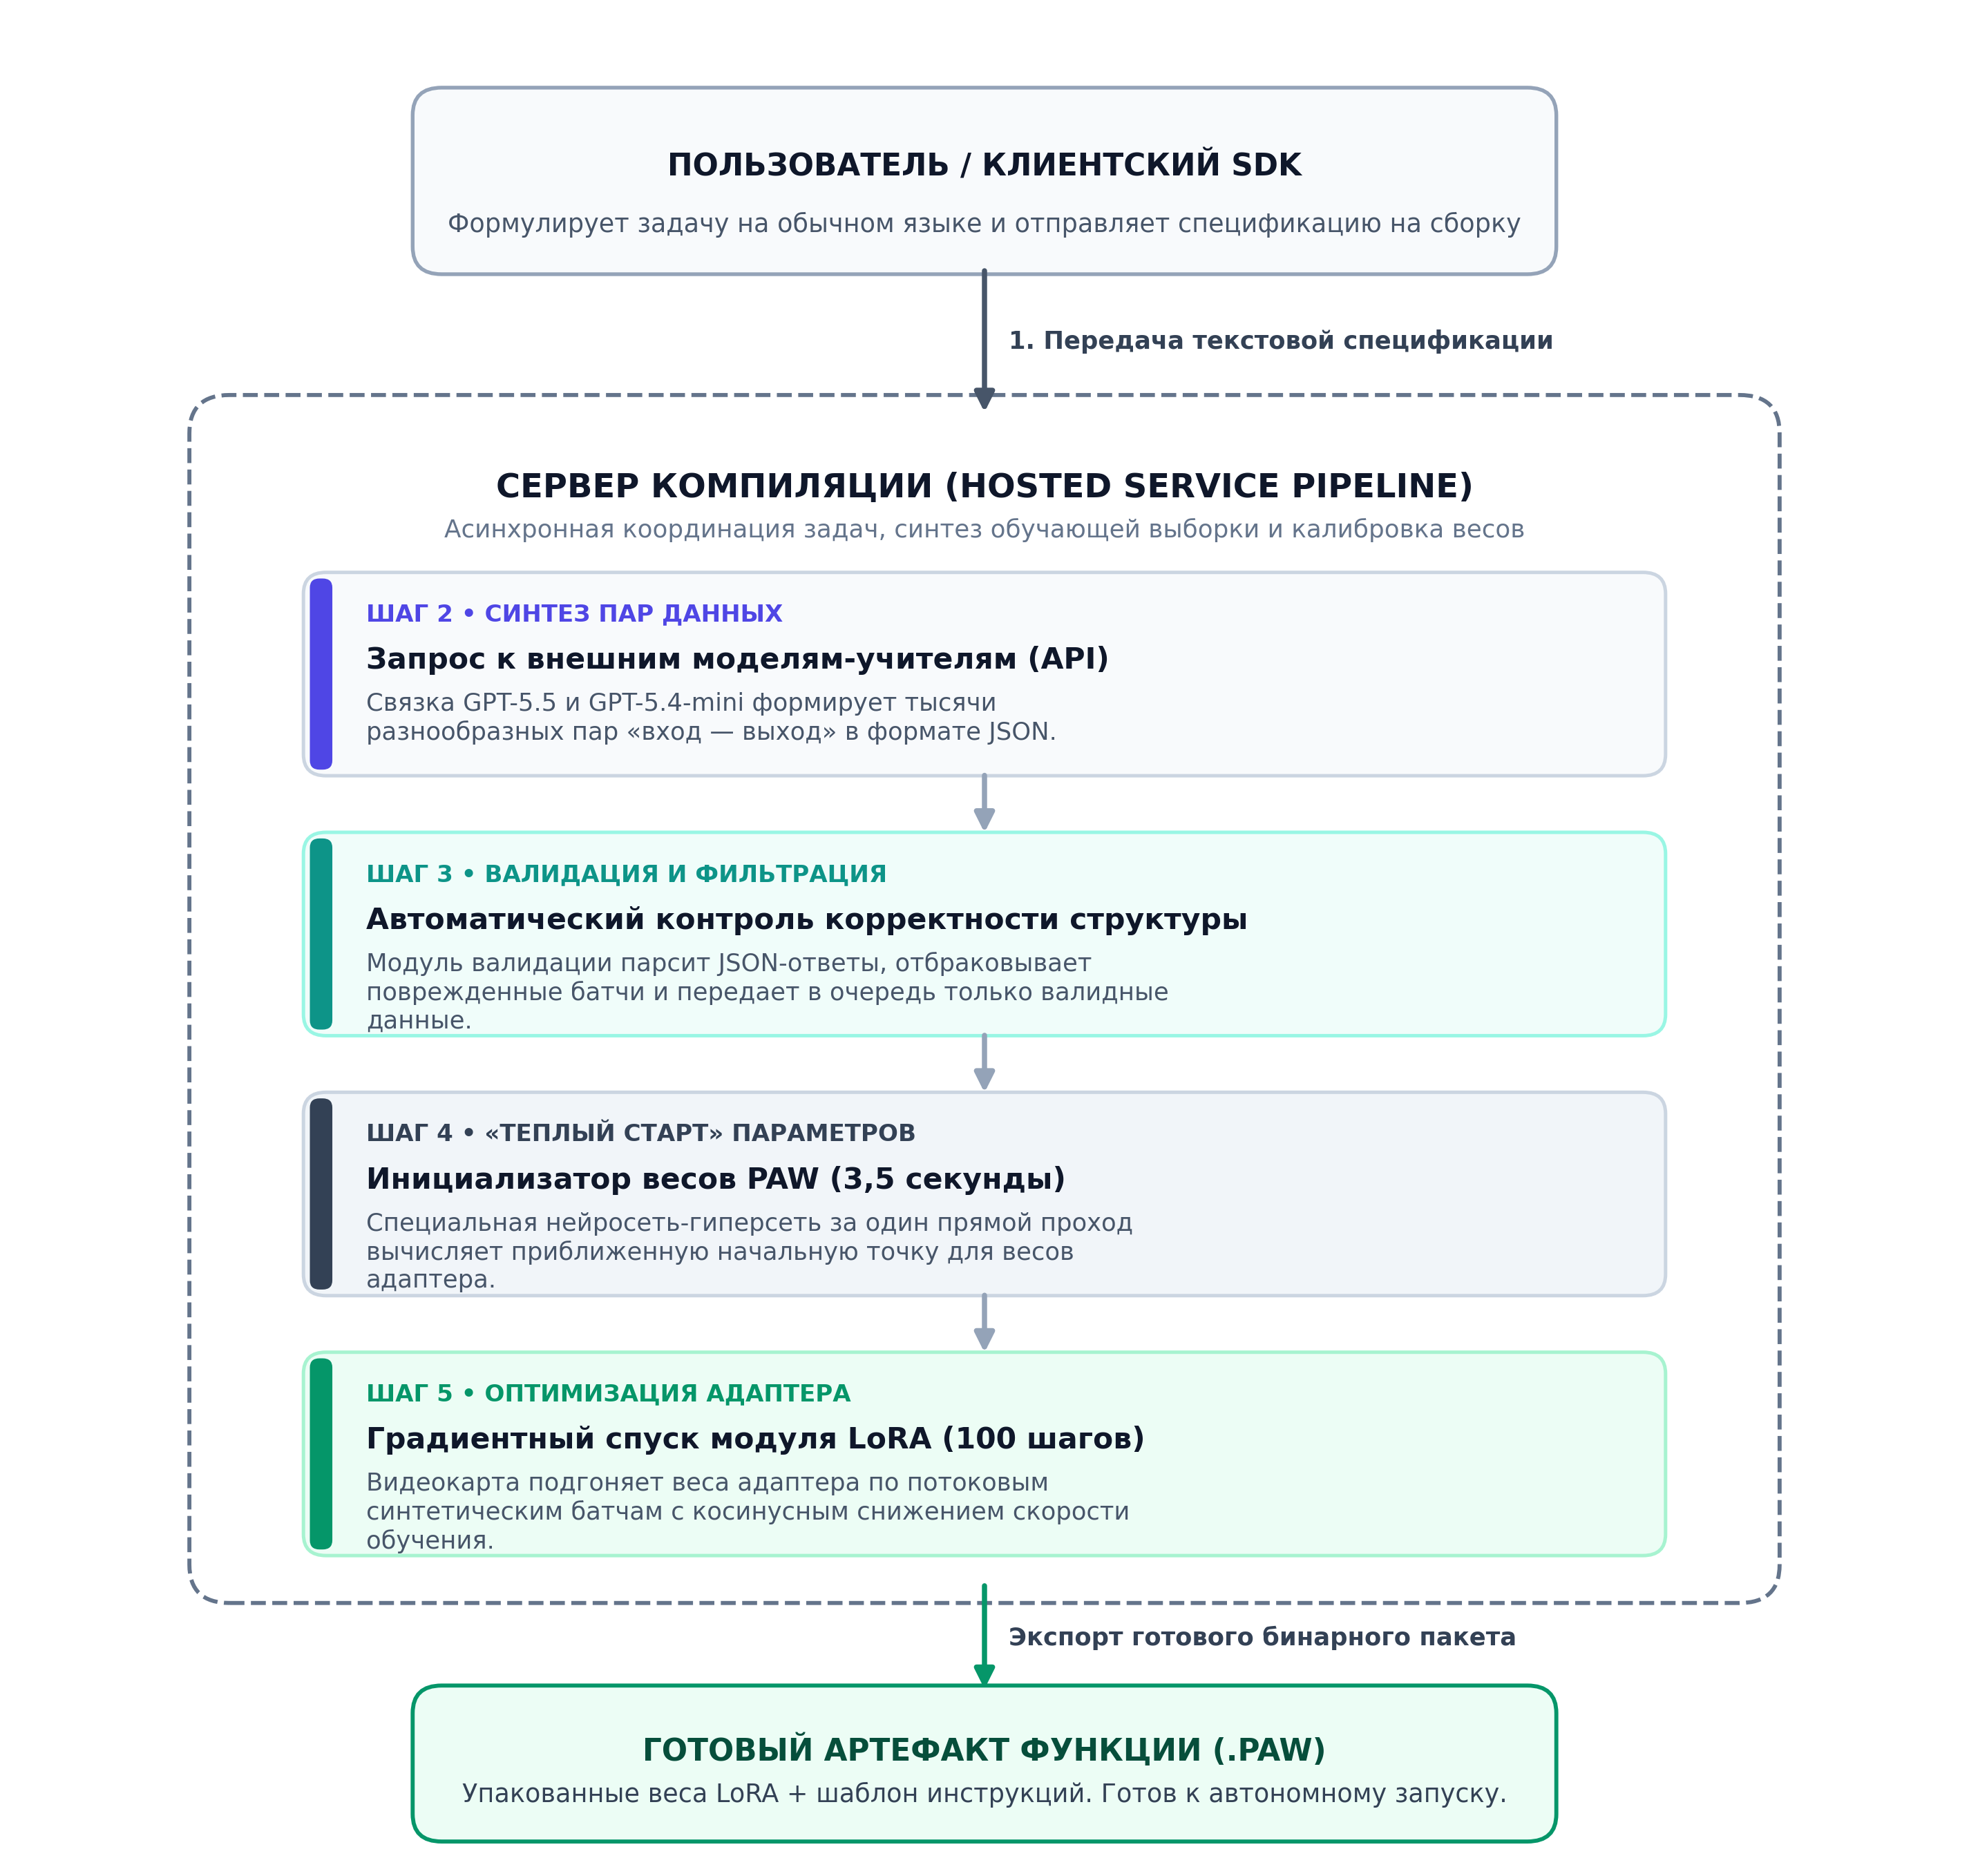
Шаг 1. Формулирование задачи
Разработчик описывает требуемую операцию текстом. Например: «Проверь входящее сообщение. Если оно содержит дату дедлайна или требование действия, верни статус IMMEDIATE. Если это информационное письмо или рассылка новостей, верни статус WAIT».
Шаг 2. Создание обучающих данных моделями-учителями
Поскольку у разработчика нет готовой базы с тысячами размеченных вручную примеров, система обращается к моделям-учителям. В публичной версии сервиса авторы объединили две нейросети: GPT-5.4-mini и GPT-5.5.
Учителя получают задачу создать структурированный список разнообразных примеров в формате JSON. Каждый пример состоит из двух полей: входной текст и эталонный ответ. Система намеренно требует генерировать сложные случаи: опечатки, редкие формулировки, неоднозначные предложения.
Автоматический фильтр проверяет каждый полученный ответ от учителей. Если формат нарушен, пропущены поля или нарушена структура данных, пакет бракуется. В обучение попадают только прошедшие синтаксическую валидацию примеры.
Шаг 3. Быстрая инициализация весов
Обычно обучение нейросети начинается со случайных чисел в параметрах, после чего требуется долго подгонять их под задачу. Чтобы сэкономить время, инженеры применили алгоритм из своего предыдущего проекта Program-as-Weights (PAW).
Отдельная вспомогательная модель анализирует текст технического задания и за один расчет длительностью 3,5 секунды вычисляет приблизительные значения для адаптера. Эти значения еще не идеальны, но они уже приближены к правильным, что избавляет систему от необходимости длительной предварительной настройки.
Шаг 4. Точная подгонка параметров
Получив начальные веса и синтетические примеры, система запускает процесс математической оптимизации — градиентный спуск. Задача алгоритма на этом этапе — скорректировать числа в адаптере так, чтобы при подаче на вход сгенерированных текстов модель выдавала в точности правильные ответы из обучающей выборки.
Настройка длится ровно 100 вычислительных шагов с размером группы данных (батча) в 48 примеров. Скорость изменения чисел плавно снижается к концу процесса по правилу косинуса, что предотвращает разрушение уже зафиксированных закономерностей.
Потоковый конвейер: почему система укладывается в одну минуту
Обучение даже небольших адаптеров в стандартных условиях занимает от десятков минут до нескольких часов. Если бы инженеру приходилось ждать столько времени ради создания одной простой функции, интерактивная работа стала бы невозможной.
Основная временная задержка в таких системах возникает не из-за математических расчетов на видеокарте, а из-за медленной генерации текстов внешними моделями-учителями через сеть. В традиционном алгоритме видеокарта простаивает до тех пор, пока удаленный сервер не закончит передачу всей обучающей базы.
Авторы статьи устранили эти простои, создав параллельный потоковый конвейер.
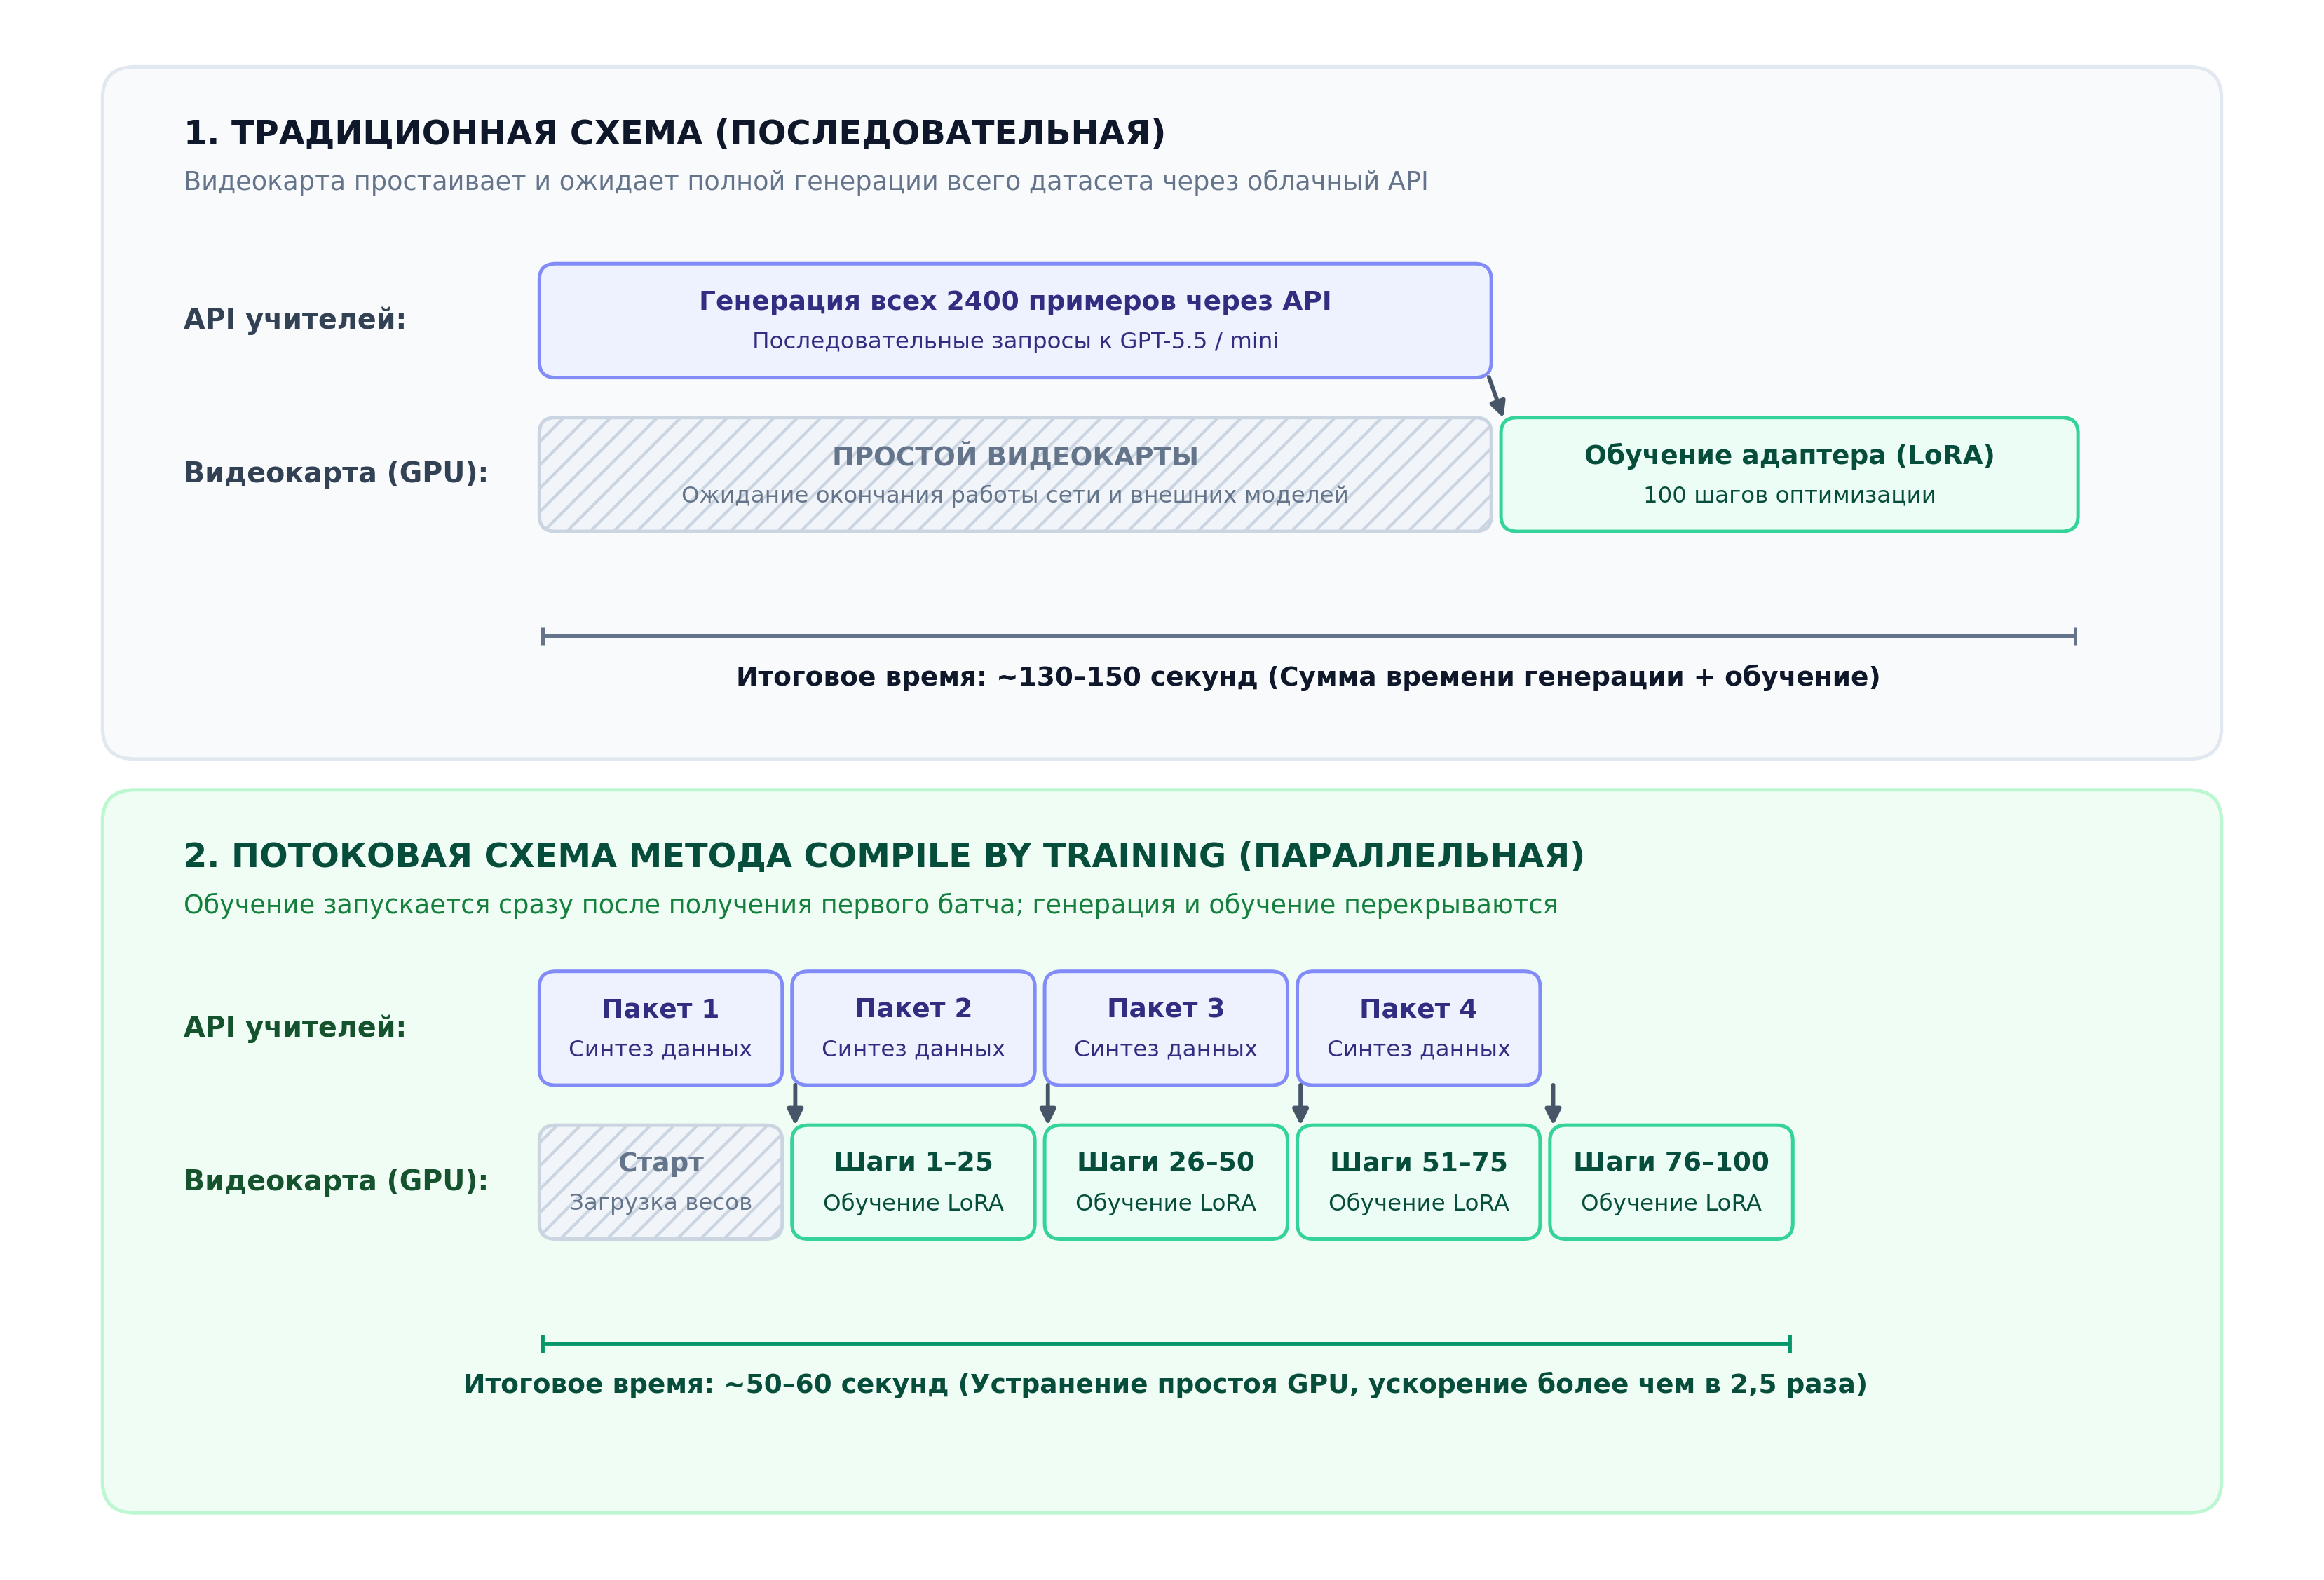
Процесс обучения запускается сразу же, как только из сети поступает первый минимальный пакет проверенных примеров. Видеокарта рассчитывает поправки для адаптера по первой порции данных. В это же самое время центральный процессор и сетевые модули запрашивают у внешних нейросетей следующие данные, проверяют их структуру и складывают в очередь.
Если очередной ответ от облачной модели задерживается, диспетчер задач подставляет в свободные слоты обучения уже проверенные примеры, не нарушая общей логики. Графический чип загружен вычислениями непрерывно.
Экспериментальные замеры времени создания рабочей функции при холодном старте (когда в кэше нет заранее сохраненных примеров) показали следующие результаты:
- На сервере с ускорителем Nvidia B300: 50,9 секунды;
- На сервере с ускорителем Nvidia H200: 68,2 секунды;
- На потребительской видеокарте серии Nvidia RTX: 99,2 секунды.
Полторы минуты на сборку программного компонента полностью укладываются в привычные рамки стандартных процессов разработки программного обеспечения.
Экспериментальная проверка и точность работы
Чтобы оценить надежность скомпилированных функций, исследователи использовали тестовый набор данных FuzzyBench-Hard.
В этот набор входят задачи высокой сложности, с которыми предыдущая быстрая версия системы (PAW без дообучения) не справилась: для этих задач однопроходный компилятор не смог выдать ни одного абсолютно точного совпадения ответов с проверочной базой.
Оценивать работу языковых моделей простым посимвольным сравнением нельзя. Если правильный ответ в эталоне записан как {"status": «ok"}, а модель вывела {"status»: «ok"} с лишним переносом строки или пробелом, программа точного сравнения сочтет ответ ошибочным, хотя по смыслу он полностью верен.
Поэтому авторы ввели метрику LEM (LLM Exact Match). Это автоматизированный контроль качества: отдельная модель-судья на базе GPT-5.5 читает исходное техническое задание, входной текст, эталонный ответ и ответ скомпилированной функции.
Судья строго наказывает за логические ошибки, пропущенные данные, лишние элементы или искажения смысла, но игнорирует различия в пробелах, порядке ключей в словарях и мелких деталях оформления. Надежность судьи подтвердили на 128 проверочных тестах, размеченных людьми: решения модели-судьи совпали с оценками людей в 97,7% случаев.
Результаты испытаний на наборе FuzzyBench-Hard:
| Способ создания функции | Затраченное время | Точность по метрике LEM |
|---|---|---|
| Однопроходное предсказание весов (PAW) | 3,5 секунды | 22,4% |
| Compile by Training (обучение адаптера) | 50,9 секунды | 83,6% |
Дополнительные 47 секунд вычислений увеличили точность решений на 61,2 процентных пункта. Функция перестала делать грубые логические ошибки и начала стабильно следовать условиям задачи.
Как выбор учителей влияет на результат
Исследователи провели серию тестов, варьируя источники обучающих данных и их объем:
- Качество моделей-генераторов. Когда всю обучающую выборку из 3600 примеров генерировала только быстрая и дешевая модель GPT-5.4-mini, итоговая точность локальной функции составила 74,6%. Когда треть примеров сгенерировала более мощная модель GPT-5.5 (пропорция 2:1), точность той же функции выросла до 85,1%. Качество синтетических примеров напрямую определяет способности локального адаптера.
- Количество примеров. При увеличении базы уникальных пар с 1440 до 2400 точность выросла с 82,1% до 83,6%. Дальнейшее увеличение выборки до 3600 примеров не дало прироста (осталось 83,6%). Расширение базы до 7200 пар подняло точность до 86,6%, но потребовало вдвое больше времени на компиляцию. Таким образом, авторы выбрали объем в 2400 примеров как оптимальный баланс между временем сборки и качеством.
Примеры практического использования в реальных системах
Авторы не ограничились синтетическими тестами и внедрили скомпилированные функции в три работающих прикладных проекта.
1. Модульный поисковый помощник для веб-сайтов (Paw-helper)
Реальные программы редко состоят из одной функции. Авторы создали ассистента, который отвечает на вопросы пользователей по материалам университетского курса и документации.
Архитектура системы объединяет детерминированные алгоритмы и 30 независимо скомпилированных нейросетевых функций, организованных в логическое дерево:
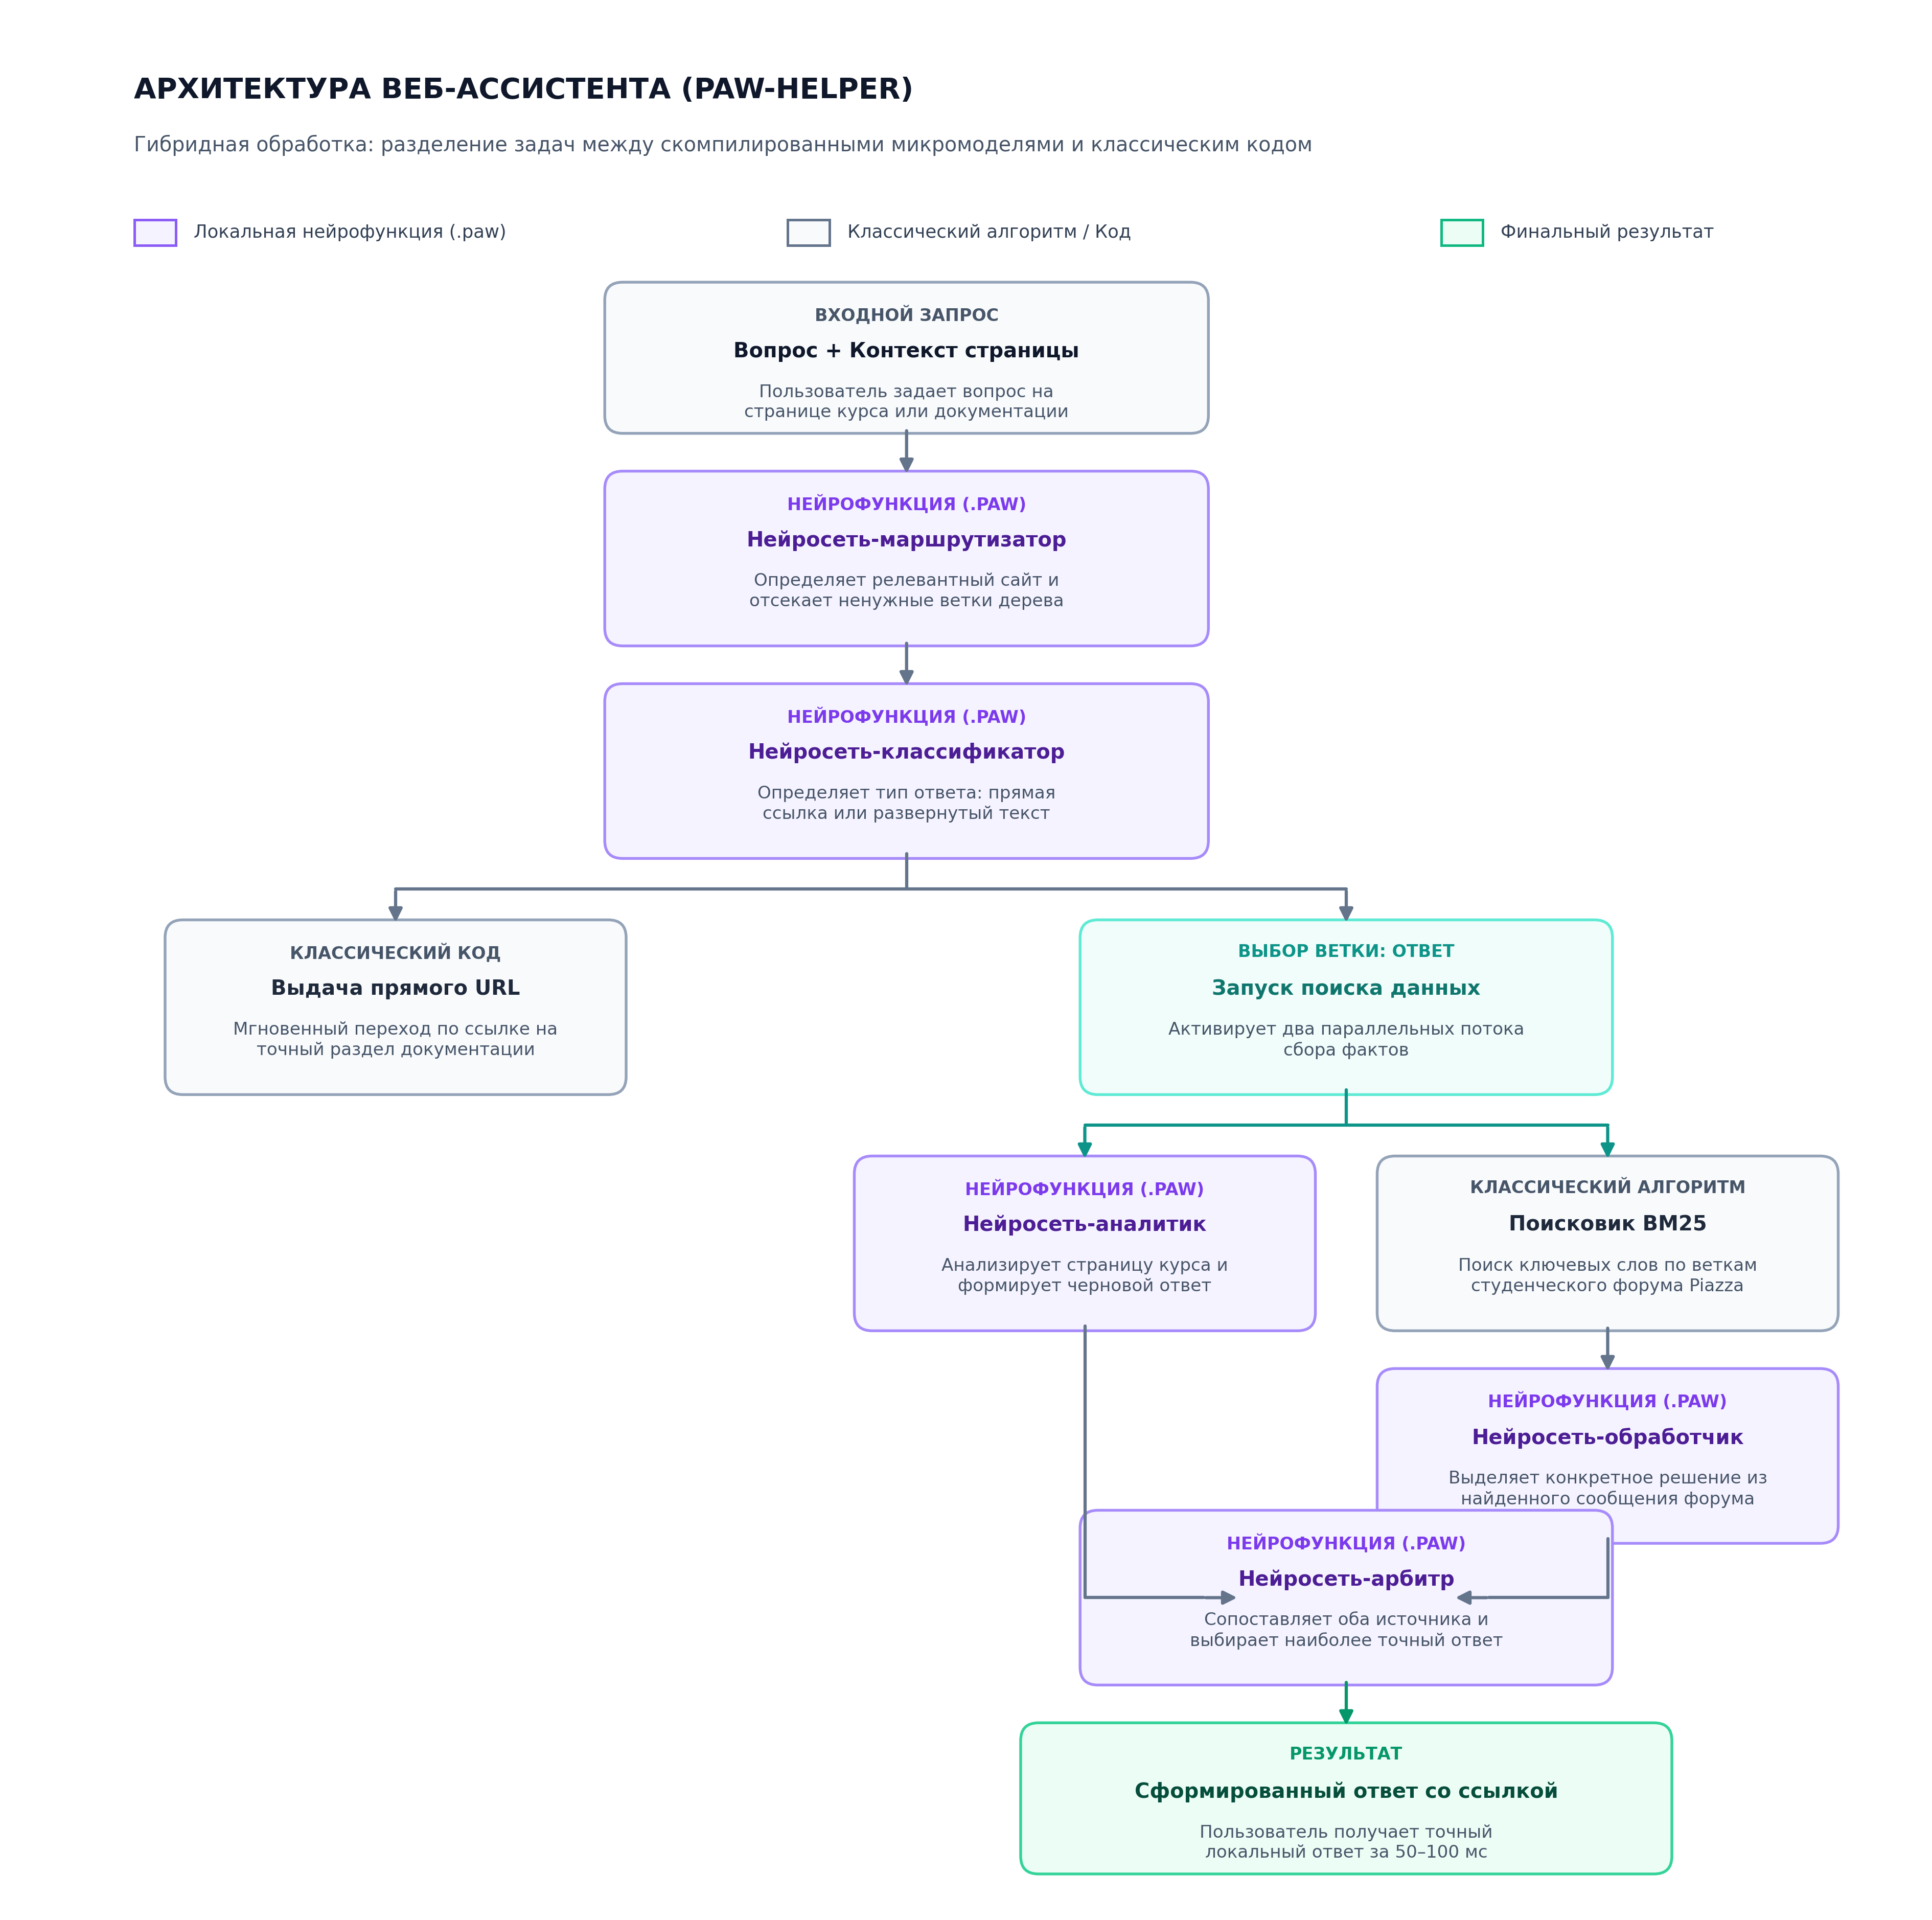
Когда студент задает вопрос: «Что изменилось в первой практической работе?», алгоритм выполняет четкие шаги:
- Первая локальная нейрофункция определяет, о каком курсе идет речь, и выбирает нужный контекст.
- Вторая функция классифицирует тип запроса: нужен ли студенту конкретный адрес документа или текстовое разъяснение.
- Для текстового разъяснения запускаются два параллельных процесса: третья нейрофункция ищет ответ в тексте веб-страницы курса, а стандартный поисковый алгоритм BM25 находит релевантные ветки обсуждений на студенческом форуме Piazza.
- Четвертая функция преобразует текст с форума в краткую выжимку.
- Пятая функция сопоставляет оба источника и решает, какой ответ точнее, либо объединяет их.
Вся эта система работает без передачи данных во внешние нейросети. Классический программный код управляет маршрутами, сетевыми запросами и кэшированием, а компактные скомпилированные функции выполняют смысловую классификацию и анализ текста.
2. Управление анимацией трехмерного персонажа (Avatar Director)
Для проверки способности функций формировать машинные команды авторы создали систему управления 3D-персонажем в браузере.
Пользователь вводит команду на естественном языке, например: «Сначала попрыгай от радости, помаши рукой, потом станцуй и гордо сядь».
Скомпилированная функция получает эту строку и переводит ее в специализированный программный код (Action DSL). Этот формальный язык поддерживает последовательности действий, указание длительности, циклы повторения и параллельные движения. Браузерная среда проверяет корректность полученного кода через синтаксическое дерево и запускает анимацию персонажа.
В ходе проверки на 44 тестовых командах, составленных вручную, локальная модель сформировала корректный исполняемый код в 43 случаях.
3. Переводчик профессионального стиля (Claudish)
В сообществе разработчиков программного обеспечения возник неформальный термин Claudish («клодиш»). Этим словом обозначают специфический стиль формулировок, характерный для модели Claude Code: частое использование контрастных конструкций, составных слов через дефис (X-shaped, X-gated) и архитектурных метафор (gate, boundary, load-bearing).
Исследователи составили два текстовых технических задания:
- Для перевода с обычного английского на стиль «клодиш» с сохранением исходного смысла.
- Для обратного перевода со стиля «клодиш» на прямой деловой английский с удалением избыточных метафор.
С помощью метода Compile by Training авторы скомпилировали два отдельных адаптера для одной и той же базовой модели Qwen3-0.6B. Полученные модули развернули на общедоступном демонстрационном сервере. За время открытого тестирования система успешно выполнила 100 747 запросов на перевод, не потратив вычислительных ресурсов сторонних облачных сервисов.
Границы применимости и уязвимости метода
Технология имеет технические ограничения, обусловленные природой машинного обучения:
- Перенос ошибок учителя. Если модели-генераторы неправильно поймут редкое граничное условие в техническом задании и включат в выборку некорректные ответы, обучаемый адаптер точно воспроизведет эту ошибку. Качество функции жестко ограничено качеством исходных синтетических данных.
- Вероятностная природа вывода. Даже хорошо обученная нейросеть остается вероятностной системой. В отличие от традиционного кода, она не гарантирует абсолютную математическую воспроизводимость результата при нестандартных входных данных.
- Необходимость внешнего контроля. Для сценариев, где ошибка недопустима (например, формирование финансовых транзакций или команд управления базами данных), выходные данные нейрофункции должны обязательно проверяться детерминированным программным кодом на соответствие допустимым схемам.
Значение для архитектуры программных систем
Метод Compile by Training решает давний конфликт между гибкостью нейросетей и инженерной надежностью программного обеспечения.
Вместо построения систем, зависящих от непрерывной связи с удаленными суперкомпьютерами сторонних компаний, разработчики получают возможность перенести ресурсоемкие вычисления на стадию создания продукта. Затратив около одной минуты работы графического процессора на этапе сборки, инженер получает файл размером в несколько мегабайт, содержащий замкнутую математическую функцию под конкретную задачу.
Такой подход меняет экономику и безопасность цифровых продуктов:
- Нулевая стоимость масштабирования. После компиляции функцию можно вызывать миллионы раз без оплаты лицензий и токенов сторонним поставщикам.
- Полная конфиденциальность. Все пользовательские данные обрабатываются на клиентском устройстве и не покидают его пределы.
- Инженерная автономность. Локальные нейросетевые функции можно сохранять в репозитории, версионировать, связывать в цепочки и запускать без подключения к интернету.
Нейросети перестают быть удаленными сервисами с постоянной абонентской платой и становятся привычными независимыми программными библиотеками.
Источник: arXiv
0 комментариев
Добавить комментарий