Что, если ваши сны покажут на дисплее? ИИ научился считывать зрительную кору всего за 15 минут
Когда человек смотрит на окружающий мир, свет падает на сетчатку глаза, превращается в электрические импульсы и уходит в глубины зрительной коры. Там сигналы распределяются по миллионам нервных клеток. Десятилетиями нейробиологи пытались решить обратную задачу: взять данные об активности этих клеток и восстановить по ним точное изображение, которое человек видит перед собой.
С появлением мощных генеративных нейросетей казалось, что цель достигнута. Современные алгоритмы научились создавать четкие, детализированные картинки на основе сканов мозга. Однако здесь возник фундаментальный изъян: эти изображения выглядели красиво, но были недостоверными. Искусственный интеллект не столько восстанавливал данные из зрительной коры, сколько додумывал их за счет собственных алгоритмов генерации.
Исследователи из Института Вейцмана разработали систему Brain-IT (Brain-Interaction Transformer). Этот алгоритм реконструирует кадры с высокой точностью, сохраняя реальную геометрию, цвет и взаимное расположение предметов. Кроме того, модель решает главную практическую проблему технологии: теперь для настройки системы под нового человека требуется всего 15-60 минут записи в томографе вместо прежних сорока часов.
Содержание
- Почему генеративный искусственный интеллект ошибался
- Принцип работы зрительной коры человека
- Архитектура Brain-IT: как устроена система
- Двойной контур генерации: разделение формы и содержания
- Результаты испытаний и метрики качества
- Решение проблемы времени: адаптация за 15 минут
- Проверка нейробиологической достоверности
- Границы возможностей метода
- Практическое значение разработки
Почему генеративный искусственный интеллект ошибался
Чтобы записать активность мозга в момент наблюдения картинки, используют метод функциональной магнитно-резонансной томографии (фМРТ). Томограф фиксирует уровень насыщения крови кислородом. Когда определенный участок мозга начинает работать интенсивнее, кровеносная система направляет туда больше обогащенной кислородом крови.
Аппарат делит весь объем коры на трехмерные единицы измерения — воксели. Воксель — это крошечный куб ткани размером около двух миллиметров. В экспериментах по расшифровке зрительной информации ученые обычно отслеживают около 40 000 таких вокселей, расположенных в затылочной и височной долях, отвечающих за зрение.
До последнего времени все алгоритмы декодирования действовали по одной схеме:
- Сигналы всех 40 000 вокселей собирали в одну группу.
- Простая полносвязная нейросеть сжимала этот массив чисел в единый математический вектор — суммарное описание происходящего.
- Этот вектор отправляли в генеративную диффузионную модель, аналогичную тем, что создают картинки по текстовым запросам.
В этом звене возникала критическая ошибка. Диффузионные сети натренированы выдавать визуально привлекательный результат, даже если исходная подсказка неполная. Получив сжатый вектор активности мозга, сеть улавливала только общую тему. Например, она понимала, что на картинке изображена собака.
Поскольку исходные координаты были стерты при сжатии данных, модель брала случайный шум и формировала собственную сцену. Испытуемый смотрел на рыжую собаку, сидящую в левом углу комнаты, а диффузионная сеть генерировала белую собаку, бегущую по траве в центре кадра. Картинка получалась фотографического качества, но не имела ничего общего с реальным зрительным опытом человека. Модель заполняла пробелы в данных информацией из собственной обучающей выборки.
Принцип работы зрительной коры человека
Чтобы победить эти ошибки, инженеры обратились к биологическому строению зрительной системы. Человеческий мозг обрабатывает визуальную информацию не в одном общем центре, а через сложную сеть специализированных зон, действующих параллельно.
Во-первых, зрительная кора организована ретинотопически. Это означает, что взаимное расположение объектов в пространстве переносится на поверхность мозга с сохранением строгой геометрии. Если вы смотрите на предмет в левом верхнем углу поля зрения, электрический сигнал возникает в строго определенной зоне коры правого полушария. Соседние точки окружающего пространства активируют соседние группы нейронов.
Во-вторых, в мозге действует четкое разделение труда:
- Первичные зоны зрительной коры (области V1 и V2) разбирают картинку на простейшие составляющие. Они реагируют на контрасты, границы объектов, наклон линий и базовые цвета. Здесь нет понимания смысла — только геометрия.
- Вторичные и высшие отделы зрительного пути собирают эти элементы воедино. Они распознают категории: человеческие лица, части тела, печатные буквы, очертания животных или предметов мебели.
Сжатие всех вокселей в один общий вектор уничтожало пространственную структуру и смешивало низкоуровневые геометрические сигналы со смысловыми. Чтобы восстановить картинку правильно, требовалось разделить эти потоки информации и обрабатывать их независимо.
Архитектура Brain-IT: как устроена система
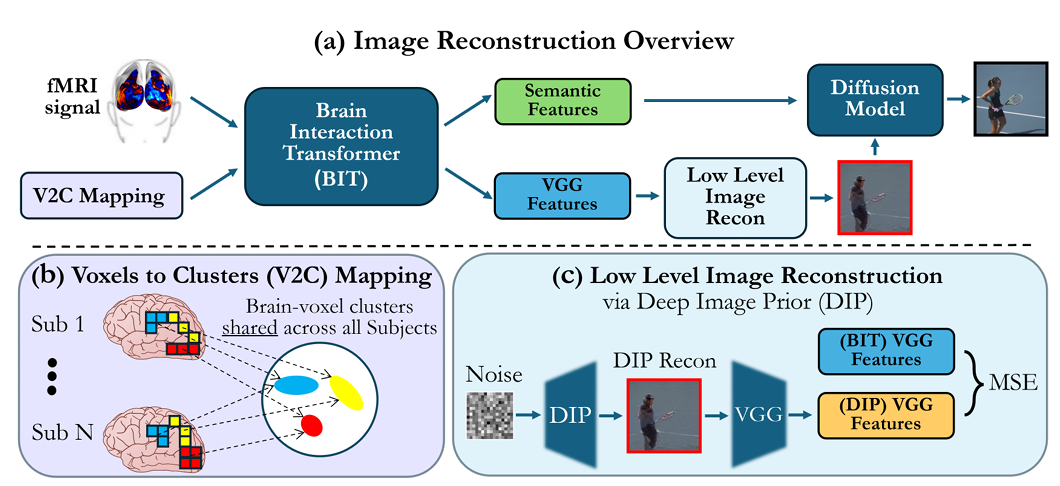
Модель Brain-IT построена так, чтобы сохранить пространственные координаты и разделить обработку формы и смысла. Вся система состоит из нескольких последовательных этапов.
Этап 1. Функциональная группировка вокселей
Анатомия борозд и извилин у разных людей различается, но функциональные задачи зон мозга остаются одинаковыми. Поэтому разработчики сгруппировали воксели не по их физическим координатам в черепе, а по характеру их работы.
Для этого использовали отдельную модель, которая изучает, как конкретный воксель реагирует на различные свойства картинок: следит ли он за мелкими линиями, реагирует ли на определенный цвет или активируется только при виде текста. На основе этих свойств алгоритм объединил 40 000 вокселей каждого человека в 128 функциональных кластеров.
Каждый кластер отвечает за строго определенную задачу: один обрабатывает границы объектов в нижней части поля зрения, другой распознает человеческие лица, третий считывает горизонтальные линии. При этом состав и роли этих 128 кластеров одинаковы для всех участников эксперимента.
Этап 2. Преобразование активности в токены
Блок под названием Brain Tokenizer переводит показатели активности внутри каждого кластера в 512-мерный цифровой вектор — Brain Token (токен мозга). В результате исходный шумный массив из 40 000 чисел преобразуется в упорядоченный набор из 128 токенов. Каждый такой токен содержит сводку о том, что именно зафиксировал конкретный функциональный отдел зрительной коры.
Этап 3. Трансформер связей и координатная привязка
Полученные 128 токенов поступают в трансформерный блок Cross-Transformer. В нем работают два механизма внимания:
- Внутреннее внимание: токены мозга обмениваются информацией между собой. Это воспроизводит реальный процесс в коре, где разные отделы постоянно сверяют данные друг с другом.
- Перекрестное внимание: модель использует специальные настроечные векторы — координатные запросы. Каждый такой запрос жестко привязан к конкретному участку двумерной сетки будущего кадра. Модуль проверяет, какие токены мозга содержат информацию для данного участка пространства, и направляет ее строго по адресу. Если сигнал поступил от нейронов, отвечающих за правый нижний угол зрения, он попадет именно в правый нижний угол изображения.
Двойной контур генерации: разделение формы и содержания
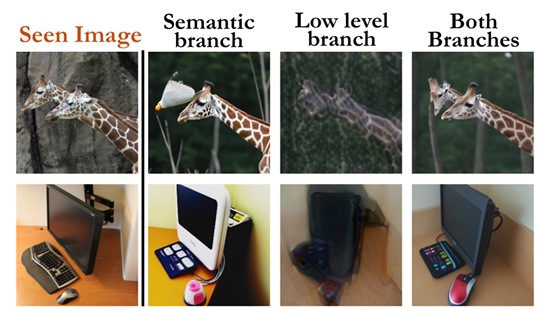
Главное техническое решение Brain-IT заключается в отказе от прямой генерации картинки из сигналов мозга за один проход. Процесс разделили на два независимых потока: низкоуровневый и высокоуровневый.
1. Низкоуровневый контур (геометрия, цвет и границы)
Первый блок трансформера настраивают на предсказание признаков классической сверточной нейросети VGG-16. Эта сеть анализирует изображение послойно: ранние слои фиксируют границы, текстуру и градиенты цвета, средние — простые формы.
Чтобы превратить эти предсказанные признаки обратно в картинку, авторы применили метод Deep Image Prior (DIP). В его основе лежит сверточная сеть с архитектурой U-Net.
Суть метода DIP заключается в том, что сеть не обучают на гигантских базах данных. Она оптимизируется с нуля прямо в процессе реконструкции конкретного кадра. Ее единственная задача — подобрать такое расположение пикселей, чтобы их признаки совпали с теми, что предсказал трансформер по данным фМРТ.
Поскольку у модели DIP нет собственной памяти о миллионах готовых фотографий, она физически не способна дорисовать несуществующие объекты. На выходе получается промежуточное изображение: размытое, напоминающее расфокусированный снимок, но абсолютно честное с точки зрения расположения предметов, их очертаний и базовых цветов.
2. Высокоуровневый контур (смысловое содержание)
Второй блок трансформера параллельно учится предсказывать пространственные токены современной визуальной модели OpenCLIP. Этот поток не следит за точными пиксельными границами, но безошибочно определяет суть объектов: например, фиксирует наличие дорожного знака, птицы, чашки чая или силуэта человека.
3. Финальный синтез
Обычная диффузионная модель генерирует изображение, начиная с чистого случайного шума. В Brain-IT генератор Stable Diffusion XL получает на вход другое: зашумленный черновой каркас, созданный моделью DIP.
Шум добавляют умеренно — диффузионный процесс запускают не с первого шага, а с 14-го (из 38 предусмотренных).
В результате диффузионной нейросети не приходится угадывать композицию сцены. Крупные формы, линии горизонта, пятна фона и силуэты предметов уже зафиксированы на холсте низкоуровневым контуром. Генеративная модель лишь убирает наложенный шум и прорисовывает реалистичные фактуры и детали, ориентируясь на подсказки семантического контура CLIP.
Результаты испытаний и метрики качества
Работу Brain-IT протестировали на базе данных Natural Scenes Dataset (NSD). Это один из самых детальных открытых наборов данных в нейробиологии: восемь добровольцев просматривали тысячи сложных фотографий внутри мощного томографа с индукцией магнитного поля 7 Тесла.
Качество реконструкции оценивали по нескольким объективным числовым показателям:
- SSIM (индекс структурного сходства): оценивает, насколько совпадают контуры, контраст и структура объектов на оригинале и реконструкции.
- PixCorr (попиксельная корреляция): математическая точность совпадения цветов и яркости пиксель в пиксель.
- CLIP-точность: показатель того, удается ли стороннему независимому классификатору опознать объект на копии так же уверенно, как на исходной фотографии.
- Color-SSIM: структурное сходство с обязательным учетом всех трех цветовых каналов RGB.
| Параметр оценки | Прежний лучший результат (модели MindEye2 / MindTuner) | Результат Brain-IT |
|---|---|---|
| Структурное сходство (SSIM) | 0.431 | 0.486 |
| Попиксельная корреляция (PixCorr) | 0.322 | 0.386 |
| Точность распознавания смысла (CLIP) | 93.8% | 96.4% |
| Сходство восприятия человеком (LPIPS, меньше = лучше) | 0.624 | 0.596 |
| Структурное сходство цветов (Color-SSIM) | 0.383 | 0.472 |
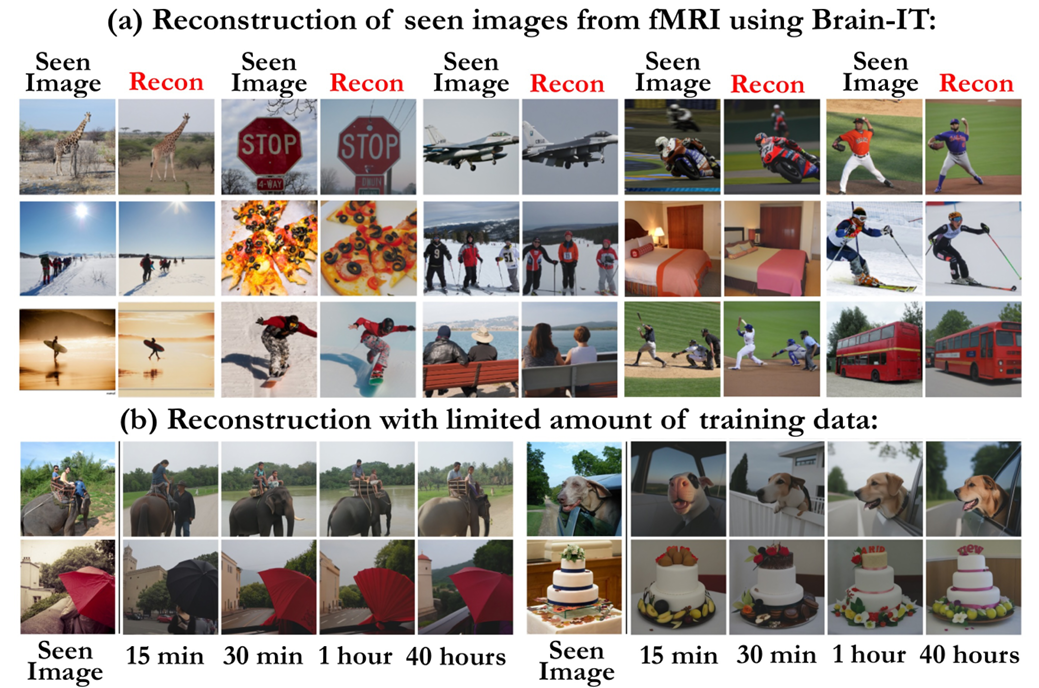
Качественные изменения видны при прямом визуальном сопоставлении. Если на исходном снимке человек сидит на скамейке в парке справа, а слева находится пустое пространство дорожки, Brain-IT воспроизводит именно эту композицию.
Предыдущие алгоритмы, опиравшиеся только на семантику, регулярно создавали фигуру человека по центру или дублировали людей, заполняя пустоту случайными деталями. На снимках дорожного знака «STOP» Brain-IT четко сохраняет восьмиугольную геометрию и красное поле с читаемым белым текстом, тогда как прошлые модели воспроизводили неразборчивые красные пятна или деформированные конструкции.
Решение проблемы времени: адаптация за 15 минут
Главный барьер для практического применения систем декодирования мозга всегда заключался в объеме необходимых данных. Чтобы обучить предыдущие нейросети, добровольцу требовалось провести внутри томографа около 40 часов, неподвижно глядя на экран. Для клинических условий — работы с парализованными людьми или пациентами после тяжелых травм — такие требования невыполнимы.
Brain-IT обходит это ограничение благодаря универсальной архитектуре:
- Все 128 функциональных кластеров и веса самого трансформера остаются общими для любых людей. Базовые принципы связи между функциональными зонами мозга и точками пространства не меняются от человека к человеку.
- При подключении нового участника все внутренние слои нейросети Brain-IT полностью замораживаются. Их не нужно обучать заново.
- Обучению подлежит лишь тонкий входящий слой индивидуальных настроек — таблица соответствия между конкретными физическими вокселями нового человека и 128 стандартными функциональными кластерами.
Эксперименты показали:
- Всего 15 минут калибровки в томографе (показ 450 изображений) позволяют Brain-IT строить узнаваемые реконструкции с правильным положением предметов и базовыми цветами.
- При одном часе калибровки качество работы Brain-IT догоняет показатели конкурирующих систем, обучавшихся на полных 40 часах данных того же испытуемого.
Сокращение времени настройки в сорок раз переводит технологию из категории фундаментальных лабораторных опытов в плоскость инженерных решений, пригодных для реального применения.
Проверка нейробиологической достоверности
Поскольку трансформер использует матрицы внимания для выбора информации, авторы смогли проследить путь каждого сигнала: из каких конкретно точек коры модель берет данные для отрисовки тех или иных участков кадра.
Это позволило подтвердить фундаментальные правила физиологии зрения без вмешательства человека:
- Контралатеральный перекрест: анализ показал, что для генерации левой половины изображения трансформер обращается почти исключительно к токенам, собранным из правого полушария мозга, и наоборот. Модель самостоятельно выучила этот закон оптики человеческого тела.
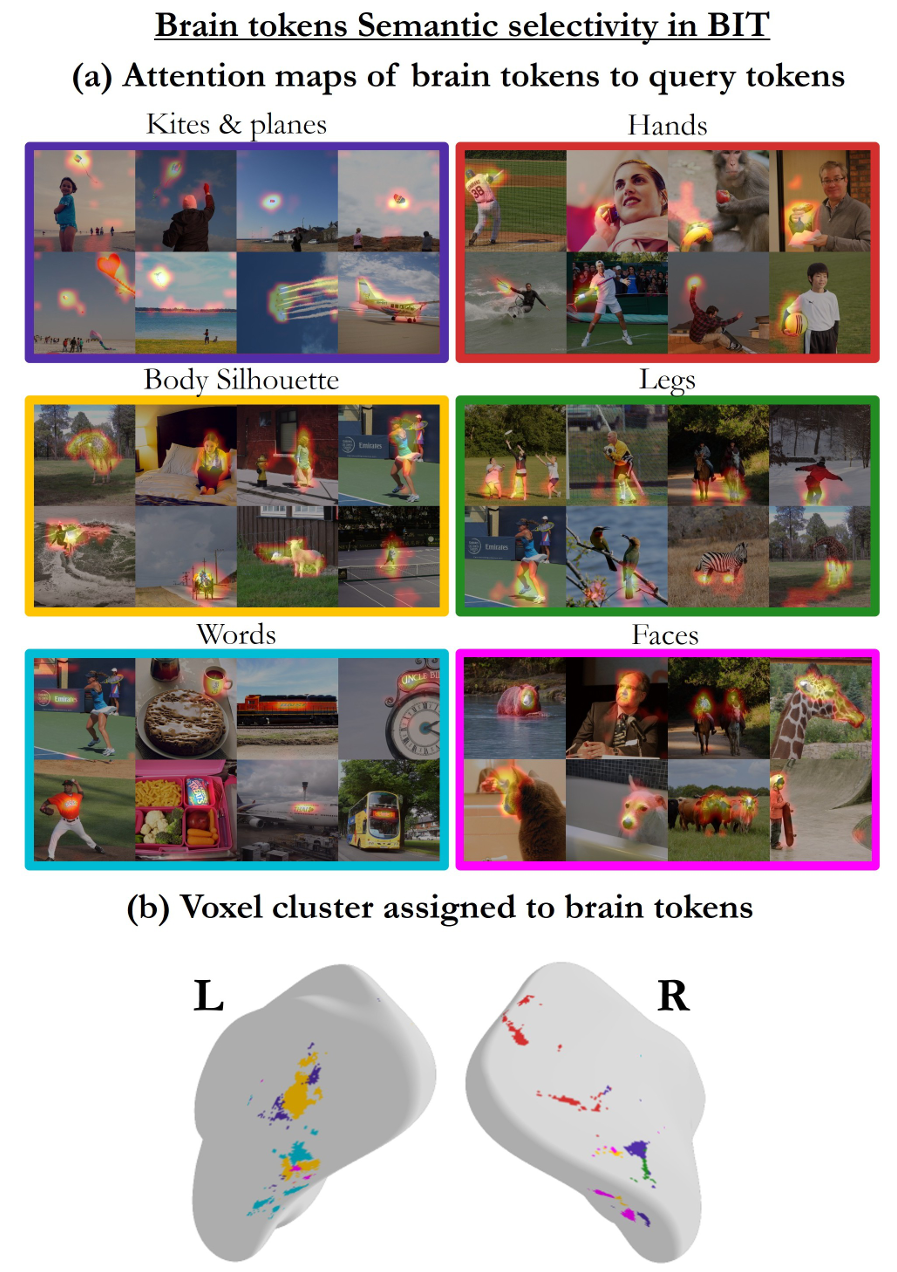
- Семантическая специализация: когда авторы проверили, на что реагируют отдельные токены мозга, выяснилось, что многие из них имеют строгую тематическую избирательность. Один токен активировался и передавал данные в диффузионную сеть только тогда, когда в кадре появлялись человеческие лица. Другой активировался при наличии надписей и букв, третий отвечал за очертания конечностей (рук и ног), четвертый — за силуэты самолетов или автомобилей.
Анатомическое положение вокселей, вошедших в эти кластеры, совпало с известными функциональными зонами коры: веретенообразной зоной лиц (FFA), экстрастриарной зоной тела (EBA) и зрительной зоной формы слова (VWFA). Это доказало, что алгоритм не строит случайные корреляции, а считывает реальную функциональную архитектуру человеческого восприятия.
Границы возможностей метода
Несмотря на прогресс, технология имеет физические ограничения, которые невозможно устранить только программными методами. Главное препятствие кроется в природе самого сигнала фМРТ.
Томограф регистрирует не электрические разряды нейронов, происходящие за миллисекунды, а медленный ток крови. Гемодинамический ответ развивается с задержкой в несколько секунд. Кроме того, один воксель объемом в несколько кубических миллиметров содержит сотни тысяч нейронов и миллионы синапсов. Сигнал томографа неизбежно представляет собой усредненное эхо работы огромного клеточного ансамбля.
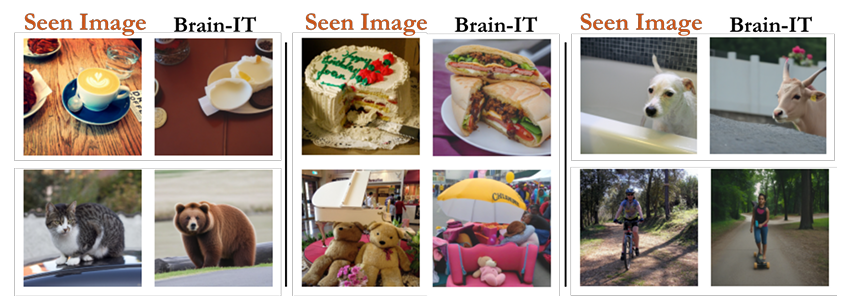
Из-за этого пространственного и временного сглаживания Brain-IT иногда допускает ошибки сходства формы. В материалах исследования описаны характерные сбои: модель может спутать круглую белую чашку с кофе на столе с яичницей-глазуньей на тарелке. С точки зрения низкоуровневых зон мозга распределение контраста, цветов и округлых линий в обоих случаях почти одинаково, и если семантический контур не уловил точный контекст, генератор выбирает неверный объект аналогичной формы.
Практическое значение разработки
Технологии прямого декодирования зрительной коры важны для нескольких областей медицины и когнитивных исследований:
- Ассистивные нейроинтерфейсы. Для людей с синдромом изоляции, сохранивших сознание при полном параличе мышц, визуальные интерфейсы открывают прямой канал взаимодействия с внешним миром без необходимости печатать текст по буквам.
- Объективная диагностика нарушений сознания. Метод позволяет проверить, воспринимает ли пациент в коме или вегетативном состоянии зрительную информацию, просто зафиксировав, собираются ли в его затылочной коре структурированные образы увиденного.
- Исследование внутренних состояний. Поскольку архитектура Brain-IT универсальна и требует минимальной калибровки, ее можно использовать для реконструкции зрительных образов во время сновидений, произвольных мысленных представлений с закрытыми глазами или зрительных галлюцинаций при неврологических расстройствах.
Создание Brain-IT показывает, что ключ к точной расшифровке биологических данных лежит не в наращивании случайной генеративной мощности нейросетей, а в строгом следовании архитектуре самого человеческого мозга. Объединение пространственных ограничений биологической зрительной коры с возможностями современных алгоритмов позволило превратить томограф в работающий инструмент визуальной реконструкции мысли.
Источник: ICLR 2026



0 комментариев
Добавить комментарий